Text to Image
Rédigez un prompt et générez un lot que vous pouvez immédiatement agrandir, utiliser pour un échange de visage ou publier.
Dernière mise à jour Il y a 1 jour
Ce que fait l’outil
Text to Image crée des images directement à partir de texte. Vous contrôlez le sujet, le décor, l’éclairage, la composition et le style. Choisissez un modèle adapté au style et aux restrictions de contenu souhaités. Les résultats sont sous licence commerciale et peuvent être envoyés vers n’importe quel outil ZenCreator.
🎬 Résultats
Un aperçu de ce que Text to Image peut produire à partir d’un simple prompt.
Vous ne voulez pas tout configurer vous-même ?
Passez la configuration : choisissez un style prêt à l’emploi dans la bibliothèque Templates et ajoutez simplement votre prompt.
Guide étape par étape
Étape 1. Model : sélectionnez le modèle de génération d’images dans la liste déroulante. Appuyez sur l’un d’eux ci-dessous pour voir ses points forts.
WAN 2.7 Image
WAN 2.7 Image
Aperçu
Modèle WAN de nouvelle génération conçu pour une génération plus flexible et expressive.
Points clés
S’adapte bien à un large éventail de prompts et de scénarios.
Fonctionne avec des filtres de sécurité minimaux (prend en charge le contenu SFW et NSFW).
Offre des résultats cohérents avec plus de variation dans les sorties.
Adapté aux générations diverses et moins contraintes.
Seedream 5
Seedream 5
Aperçu
Modèle d’image IA de nouvelle génération axé sur la génération intelligente, l’édition contrôlable et le raisonnement amélioré.
Points clés
Combine la génération d’images avec le raisonnement logique et le suivi d’instructions.
Conçu pour des compositions plus complexes et des prompts structurés.
Mieux adapté aux sorties de haute qualité et aux tâches de génération plus avancées et contrôlées.
Qwen Image
Qwen Image
Aperçu
Modèle polyvalent de la famille Qwen, axé sur une génération structurée et prévisible.
Points clés
Produit des résultats stables et cohérents à travers les prompts.
Fonctionne avec des filtres de sécurité minimaux (prend en charge le contenu SFW et NSFW).
Gère un large éventail de styles sans réglage intensif du prompt.
Adapté à la génération d’images quotidienne.
Nano Banana 2
Nano Banana 2
Aperçu
Modèle SFW haute qualité optimisé pour des visuels propres et commerciaux.
Points clés
Génère des images jusqu’à 2K de résolution.
Fonctionne avec les filtres de sécurité activés (prend en charge uniquement le contenu SFW).
Anatomie propre, visages stables, look soigné.
Bien adapté au contenu mode, lifestyle et de marque.
Seedream 5 Pro
Seedream 5 Pro
Aperçu
Le tout dernier fleuron Seedream, conçu pour la meilleure compréhension des prompts et le réalisme.
Points clés
Prend en charge les 15 formats, plus que tout autre modèle de cet outil.
Bascule de niveau de résolution : 1K (2 crédits) ou 2K (3 crédits).
Fonctionne avec des filtres de sécurité minimaux (prend en charge le contenu SFW et NSFW).
Mieux adapté aux sorties les plus fidèles et les plus contrôlées.
General
General
Aperçu
Modèle universel haute résolution optimisé pour une qualité de sortie maximale.
Points clés
Génère des images en 4K natif.
Fonctionne avec des filtres de sécurité minimaux (prend en charge le contenu SFW et NSFW).
Réalisme, anatomie et éclairage équilibrés sans réglage supplémentaire.
Meilleur choix quand vous voulez des images finales prêtes à publier.
Flux Klein Spicy
Flux Klein Spicy
Aperçu
Modèle de génération rapide avec moins de restrictions de contenu et prise en charge de workflows créatifs flexibles.
Points clés
Architecture optimisée pour la vitesse, conçue pour l’itération rapide.
Permet une génération de contenu plus flexible grâce à un filtrage minimal.
Prend en charge les workflows itératifs et l’expérimentation rapide.
Mieux adapté à la génération rapide où la flexibilité est requise.
Qwen Image Pro
Qwen Image Pro
Aperçu
Version améliorée de Qwen Image avec une qualité de sortie plus raffinée.
Points clés
Produit des résultats plus propres et plus détaillés par rapport au modèle de base.
Maintient des sorties cohérentes à travers différents prompts.
Fonctionne avec des filtres de sécurité minimaux (prend en charge le contenu SFW et NSFW).
Mieux adapté aux images finales.
WAN 2.7 Pro
WAN 2.7 Pro
Aperçu
Modèle WAN avancé avec plus de détails et des sorties plus expressives.
Points clés
Produit des résultats plus détaillés par rapport à WAN 2.7 Image.
Gère mieux les scènes et compositions complexes.
Fonctionne avec des filtres de sécurité minimaux (prend en charge le contenu SFW et NSFW).
Recommandé pour des images finales de haute qualité.
Krea 2
Krea 2
Aperçu
Modèle rapide et photoréaliste qui applique toujours notre LoRA de style intégrée : aucune sélection de LoRA personnalisée n’est nécessaire.
Points clés
Entraîné avec une LoRA de style dédiée pour du contenu adulte réaliste ; la LoRA ne peut être remplacée ni désactivée.
Deux niveaux de qualité : 1K (1 crédit) ou 2K (2 crédits). Même style et même composition, seuls la résolution et le prix changent.
Ignore la largeur/hauteur manuelle, le prompt négatif et la sélection de LoRA ; la taille est définie uniquement par le format + le niveau.
Z-Image Spicy
Z-Image Spicy
Aperçu
Modèle photoréaliste non censuré, texte-vers-image uniquement : il n’accepte pas les images de référence.
Points clés
Entraîné en plus sur du contenu explicite et dessine bien à partir du texte seul.
Deux modes : Standard (1 crédit, plus rapide) ou Pro (2 crédits, plus de détails fins).
Le fournisseur réécrit et développe automatiquement votre prompt avant la génération : des prompts courts et précis (40 à 120 mots, un paragraphe) fonctionnent donc généralement mieux que des prompts longs et détaillés.
Ignore la largeur/hauteur manuelle, le prompt négatif et les LoRAs ; la taille est définie uniquement par le format.
Choix rapide :
Le plus rapide et le moins cher, juste pour tester une idée → Qwen Image.
Pose spécifique ou scène détaillée, sans censure → WAN 2.7 Image.
Couleur cinématographique, style magazine → Seedream 5 (ou Pro pour la version la plus nette, toute résolution/format).
Photos SFW propres prêtes à animer → Nano Banana 2.
Même visage sur une série de personnages, qualité maximale → General.
Photos de nu réalistes → Flux Klein Spicy.
Nus les plus nets et les plus détaillés (ça vaut l’attente) → Qwen Image Pro ou WAN 2.7 Pro.
Le moyen le plus rapide d'obtenir des images nettes et réalistes avec notre style intégré → Krea 2.
Contenu explicite à partir du texte seul, avec des prompts courts et précis → Z-Image Spicy.
Étape 2. Prompt : décrivez ce que vous voulez voir dans l’image. Soyez précis sur le sujet, les vêtements, la pose, l’éclairage, l’angle de caméra, l’ambiance et l’environnement. Utilisez Magic Prompt pour développer automatiquement une idée courte en un prompt détaillé ; cela fonctionne avec tous les modèles. Pas satisfait du résultat ? Cliquez sur Revert pour revenir à ce que vous avez tapé.
Étape 3. Negative Prompt (optionnel) : listez ce que le modèle doit éviter (mauvaise anatomie, doigts supplémentaires, flou, filigrane, texte, artefacts). La disponibilité dépend du modèle sélectionné.
Étape 4. Aspect Ratio : choisissez le format souhaité pour les images générées (par ex. 1:1, 3:4, 9:16). Cela définit le rapport largeur/hauteur de toutes les sorties.
Étape 5. Resize (W / H) : définissez manuellement la résolution de sortie en pixels. La résolution maximale dépend du modèle sélectionné (jusqu’à 4K).
Étape 6. Number of Images : sélectionnez combien de variations générer dans cette exécution (jusqu’à 10).
Étape 7. Start Generation : lance la tâche. Le coût total en crédits est affiché sous le bouton avant le début de la génération.
Agir sur les résultats
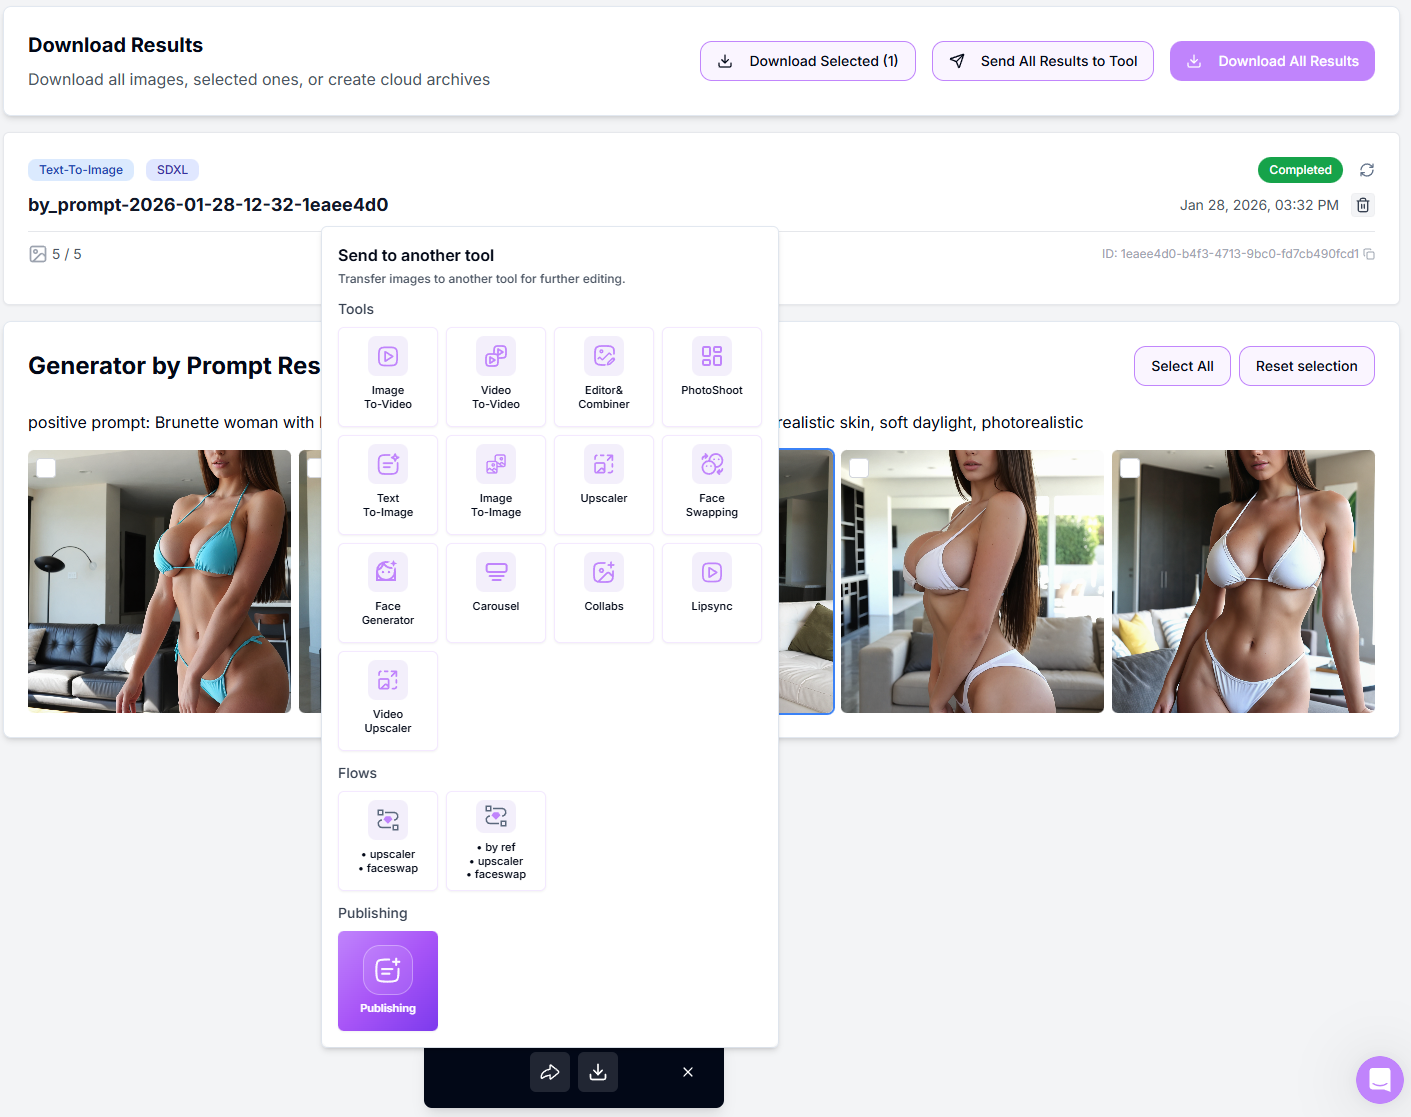
Utilisez les cases à cocher sur les miniatures pour Sélectionner/Désélectionner.
Download Selected / Download All pour exporter un ZIP.
Envoyez vers un autre outil pour poursuivre le workflow (Image Upscaler, Head & Face Swap, Reference-To-Image, Image to Video, Variations).
Retry Failed apparaît automatiquement si des images ne se sont pas bien rendues.
Astuces de prompting (à copier-coller)
Portrait : "35mm portrait of [subject], half-body, eye contact, soft window light, shallow depth of field, natural skin, neutral color grade, realistic texture, high detail". Négatif : "lowres, over-smooth skin, bad anatomy, extra fingers, watermark"
Lifestyle : "[subject] walking in [location], candid pose, golden hour backlight, film look, natural grain, realistic proportions, composition rule of thirds". Négatif : "cartoonish, plastic skin, lens distortion, duplicate face"
Mode : "[subject] studio fashion shot, 3/4 pose, key light + rim, clean backdrop, editorial style, crisp shadows, high-end retouch look". Négatif : "blown highlights, muddy blacks, JPEG artefacts"
Consultez un guide complet : Comment écrire un bon prompt.
Astuces pro
Gardez les prompts visuels et concis : décrivez ce que vous voyez, pas comment le modèle devrait fonctionner.
Si les résultats semblent flous à haute résolution, envoyez les images sélectionnées vers Image Upscaler comme étape finale.
Si l’identité faciale n’est pas assez stable, dirigez les images sélectionnées vers Head & Face Swap après la génération pour fixer le visage.
Commencez avec 2 à 4 images, validez le look, puis augmentez le nombre d’images pour les exécutions de production.
Évitez de mélanger des styles extrêmes et des LoRAs intenses dans une même exécution : la cohérence chute rapidement.
Dépannage
Vous travaillez avec de l’IA : des erreurs ou artefacts occasionnels sont normaux, et un résultat 100 % correct n’est pas garanti.
Distorsions d’anatomie ou de vêtements → simplifiez le prompt ou essayez un modèle différent.
Si le résultat n’est pas celui attendu, contactez-nous via le chat de support dans l’application, ou écrivez à [email protected].
FAQ
Quel modèle est le plus réaliste ?
Quel modèle est le plus réaliste ?
Pour le contenu SFW, Nano Banana 2 est généralement l’option la plus photoréaliste. Pour la meilleure qualité de sortie globale et les images finales, utilisez General. Pour le contenu NSFW, utilisez General.
Pourquoi vois-je des artefacts ?
Pourquoi vois-je des artefacts ?
Force de LoRA excessive ou trop de LoRAs en concurrence. Baissez les forces, retirez-en un ou simplifiez le prompt.
Les prompts doivent-ils être rédigés en anglais ?
Les prompts doivent-ils être rédigés en anglais ?
Les prompts peuvent être rédigés dans différentes langues, mais les modèles comprennent mieux l’anglais. Avec des prompts dans d’autres langues, la qualité des résultats n’est pas garantie, il vaut donc mieux rédiger vos prompts en anglais.
Puis-je générer directement des images en très haute résolution ?
Puis-je générer directement des images en très haute résolution ?
Oui, selon le modèle. Pour la sortie la plus haute résolution, utilisez General (4K). Pour les autres modèles, générez d’abord puis envoyez les images sélectionnées vers l’Image Upscaler.
Dois-je toujours utiliser un Negative Prompt ?
Dois-je toujours utiliser un Negative Prompt ?
Pas toujours, mais c’est recommandé lors de la génération de personnes. Un negative prompt court aide à réduire les problèmes d’anatomie, le flou et les artefacts indésirables.
Et ensuite
Image Upscaler : améliorez la netteté et agrandissez votre résultat
Head & Face Swap : figez un visage cohérent
Reference-To-Image : créez des variations à partir de ce résultat
Image to Video : animez l’image finale
Cela a-t-il été utile ?
Besoin d'aide supplémentaire ? Demander à l'équipe