Video to Video
Verwandle mit unserem AI Video to Video Generator ein statisches Foto in Bewegung oder ersetze eine Person in einem Video. Lade ein Foto und ein Video hoch, um dynamische, filmische Ergebnisse mit hoher visueller Konsistenz zu erzielen.
Zuletzt aktualisiert Vor etwa 5 Stunden
Was das Tool macht
Video to Video funktioniert auf zwei Arten: ein Standbild mit der Bewegung eines Referenzvideos animieren, oder die Person in einem vorhandenen Video durch jemand anderen ersetzen, während die ursprüngliche Szene, Kameraarbeit und Bewegung intakt bleiben. Zum Beispiel ein Porträt mit den Tanzbewegungen einer anderen Person zum Leben erwecken, oder den Moderator in einem Clip durch dein eigenes Foto ersetzen. Unterstützt NSFW vollständig.
🎬 Ergebnisse
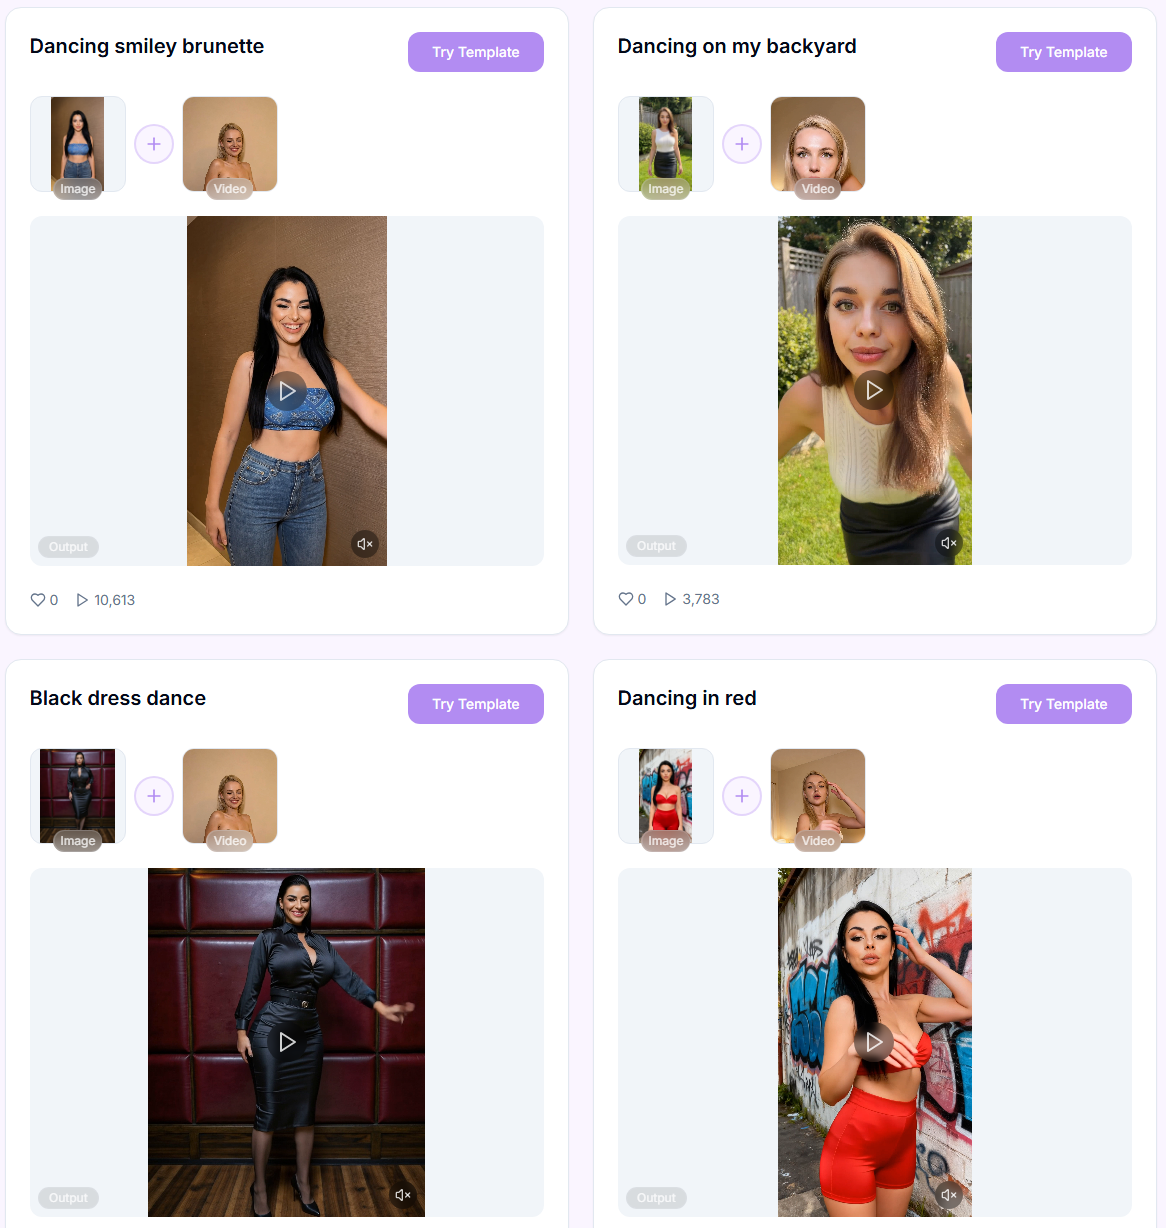
Ein Blick darauf, was Video to Video aus einem Foto und einem Referenzvideo erzeugen kann.
Du möchtest nicht alles selbst einrichten?
Überspringe das Setup: Wähle einen fertigen Stil aus der Templates-Bibliothek und füge dein Foto und Video hinzu. Vorlagen zeigen dir auch, welche Art von Bewegung und Szenen das Modell am besten bewältigt.
Schritt-für-Schritt-Anleitung
Schritt 1. Model: wähle aus der Dropdown-Liste, welches Modell die Transformation steuert. Tippe unten auf eines, um zu sehen, worin es am besten ist.
Wan 3.0 Spicy
Wan 3.0 Spicy
Dauer: 5, 10, 15, 20, 25, oder 30s
Auflösung: 480p / 720p / 1080p
Am besten für: promptgesteuerte Video-zu-Video-Generierung mit Referenzvideos (bis zu 3), Referenzbildern (bis zu 9), und Referenzaudio: für lange Multi-Shot-Bearbeitungen oder -Transformationen von bis zu 30 Sekunden, mit optionalem nativem Audio, das vom Modell geschrieben wird. Trainiert auf einem umfangreichen, gekennzeichneten NSFW-Datensatz.
Stärken: kann seinen eigenen Soundtrack über den Generate-Audio-Schalter schreiben, folgt langen, drehbuchartigen Prompts, die in zeitgestempelte Shots unterteilt sind, Referenz-Tokens ([img1], [vid1], [audio1]) lassen dich genau festlegen, welchen Upload das Modell verwenden soll, stärkere Multi-Subjekt-Konsistenz und Kamerakontrolle als frühere Wan-Modelle.
Nachteile: beste Ergebnisse brauchen einen zur Dauer passenden Prompt. Kurze Prompts bei langen Dauern überlassen Handlung und Einstellungswahl dem Modell. Kein negativer Prompt; unerwünschte Elemente müssen explizit beschrieben werden.
Inhaltshinweise: Filter: Minimal
Wan 3.0 Prime Spicy
Wan 3.0 Prime Spicy
Dauer: 5, 10, 15, 20, 25, oder 30s
Auflösung: 480p / 720p / 1080p
Am besten für: dieselbe promptgesteuerte Video-zu-Video-Generierung wie Wan 3.0 Spicy (Referenzvideos bis zu 3, Referenzbilder bis zu 9 und Referenzaudio), aber etwa 40 % schneller zurückgegeben.
Stärken: identische Ausgabequalität und identischer Funktionsumfang wie Wan 3.0 Spicy (Generate-Audio-Schalter, drehbuchartige Prompts, Referenz-Tokens, Multi-Subjekt-Konsistenz); der Unterschied ist die Wartezeit, die beim Testen von Ideen oder beim Feinschliff einer Aufnahme zählt.
Nachteile: kostet pro Sekunde mehr als Wan 3.0 Spicy für dasselbe Ergebnis; gleiche Empfindlichkeit gegenüber der Prompt-Länge und kein negativer Prompt.
Inhaltshinweise: Filter: Minimal
Seedance 2.0 Uncensored
Seedance 2.0 Uncensored
Dauer: 5–15s
Auflösung: 720p / 480p
Am besten für: promptgesteuerte Videogenerierung mit erstem/letztem Bild und multimodaler Referenz (Bilder, Videos, Audio): Bearbeitung eines fertigen Videos durch Ersetzen von Kostüm, Hintergrund, Beleuchtung, oder Umgebung unter Beibehaltung von Bewegung, Timing und Identität des Motivs. Trainiert auf einem riesigen, annotierten Datensatz mit NSFW-Inhalten.
Stärken: eine klare Unterscheidung zwischen „was beibehalten" und „was ändern" im Prompt führt zu vorhersehbaren Ergebnissen, ohne die Szene neu aufbauen zu müssen. Bewahrt die ursprüngliche Animation und Körperproportionen gut, wenn der Prompt präzise formuliert ist. Verarbeitet Referenzen [video 1]/[audio 1]/[image 1] präzise und kann Audio generieren, wenn keine Referenz bereitgestellt wird.
Kompromisse: die Reihenfolge, in der Elemente beschrieben werden, ist entscheidend: Wenn du mit den Änderungen statt mit dem, was beibehalten werden soll, beginnst, kann das Modell die ursprüngliche Bewegung und das Timing verlieren. Die ursprüngliche Videoreferenz [Video 1] muss für zuverlässige Ergebnisse klar sein. Maximale Länge der 3 Videoreferenzen: 15 Sekunden. Langsamer als Seedance 2.0 Fast Spicy.
Inhaltshinweise: Filter: Minimal
Seedance 2.0 Fast Spicy
Seedance 2.0 Fast Spicy
Dauer: 5–15s
Auflösung: 720p / 480p
Am besten für: schnellere, günstigere Videogenerierung mit demselben Erstes/Letztes-Bild- und multimodalen Referenzansatz wie Seedance 2.0 Uncensored: gute Qualität, Bearbeitung vorab aufgenommener Videos (Kostüme, Hintergründe, Beleuchtung) unter Beibehaltung von Bewegung, Timing und Gesichtsidentität. Plus zusätzliches Training auf einem riesigen gelabelten Datensatz mit NSFW-Inhalten.
Stärken: schnelle Verarbeitungszeit; eine klare Unterscheidung zwischen „was beibehalten" und „was ändern" im Prompt führt zu vorhersehbaren Ergebnissen, ohne die Szene „neu aufbauen" zu müssen. Schneller und günstiger als Seedance 2.0 Uncensored.
Kompromisse: die Reihenfolge, in der Änderungen beschrieben werden, ist entscheidend: Wenn du mit den Änderungen statt mit dem, was beibehalten werden soll, beginnst, kann das Modell die ursprüngliche Bewegung und das Timing verlieren. Die ursprüngliche Videoreferenz [Video 1] muss klar sein. Maximale Länge der 3 Videoreferenzen: 15 Sekunden. Qualität geringer als bei Seedance 2.0 Uncensored.
Inhaltshinweise: Filter: Minimal
Seedance 2.5 Uncensored
Seedance 2.5 Uncensored
Dauer: 5, 10, 15, 20 oder 30 s
Auflösung: 480p / 720p / 1080p
Am besten für: promptgesteuerte Video-zu-Video-Generierung aus bis zu 10 Referenzvideos, 30 Referenzbildern und 10 Referenzaudioclips (im Prompt angesprochen als [vid1], [img1], [audio1]) zu langen Multi-Shot-Ergebnissen von bis zu 30 Sekunden. Trainiert auf einem riesigen, gelabelten Datensatz mit NSFW-Inhalten.
Stärken: natürlichere, weniger „KI-typische“ Aufnahmen: bessere Kameraübergänge, Motivstabilität, Beleuchtung sowie Haut- und Augendetails; Prompts mit Zeitmarken („0–5s: …, 6–10s: …“) steuern, was wann passiert; optionales natives Audio über den Generate-Audio-Schalter.
Kompromisse: das teuerste Seedance-Modell: 1080p kostet etwa das 3,4-Fache des 720p-Tarifs, und die Sekunden deiner Referenzvideos werden zusammen mit dem Ergebnis berechnet, teste also zuerst in 480p/720p. Kein negativer Prompt. Das Video kann auch bei aktiviertem Generate Audio ohne Ton ausgegeben werden.
Inhaltshinweise: Filter: Minimal
Dream Actor M2.0
Dream Actor M2.0
Dauer: bis zu 30s
Auflösung: 720p / 480p
Am besten für: ein Standbild-Charakter zum Leben erwecken, indem exakt die Körperbewegungen, Gesten, Gesichtsausdrücke und Lippenbewegungen eines Referenzvideos angewendet werden. Ideal für Charakterdarstellungen, Tanzsequenzen, ausdrucksstarke Animationen, und Mehrpersonen-Szenen, plus zusätzliches Training auf einem riesigen gelabelten Datensatz mit NSFW-Inhalten.
Stärken: exzellente Bewegungstreue und semantisches Verständnis von Bewegungen, hohe Identitäts- und Hintergrundkonsistenz, starke Leistung bei nicht-menschlichen und stilisierten Figuren, natürliche Ausdrücke, stabile Ausgabe bei komplexen Aktionen. Die stabilste Option, um ein Foto zum Leben zu erwecken.
Kompromisse: beste Ergebnisse bei gut abgestimmter Komposition, klarem Referenzvideo (gute Beleuchtung, minimale Verdeckung), und kompatiblem Charakterbild.
Inhaltshinweise: Filter: Minimal
Animate
Animate
Dauer: bis zu 30s
Auflösung: 720p / 480p
Am besten für: ein Standbild-Charakter (Porträt, Illustration, oder Design) zum Leben erwecken, indem exakt die Körperbewegungen, Gesten und Gesichtsausdrücke eines Referenzvideos angewendet werden. Ideal für Charakterdarstellungen, Tanzsequenzen, und ausdrucksstarke Animationen, plus zusätzliches Training auf einem riesigen gelabelten Datensatz mit NSFW-Inhalten.
Stärken: starke Bewegungstreue mit natürlichen Ausdrücken, hohe Identitätskonsistenz, nahtlose Übertragung komplexer Aktionen.
Kompromisse: beste Ergebnisse bei gut abgestimmter Komposition, klarem Referenzvideo (gute Beleuchtung, minimale Verdeckung), und kompatiblem Charakterbild. Kann instabil sein (siehe Hinweis unten).
Inhaltshinweise: Filter: Minimal
Replace
Replace
Dauer: bis zu 30s
Auflösung: 720p / 480p
Am besten für: die Hauptfigur in einem vorhandenen Video durch ein Motiv aus deinem Bild ersetzen, während die ursprüngliche Bewegung, Szene, Beleuchtung und Kameraarbeit erhalten bleiben. Perfekt für Charaktertausch in Aufnahmen, Moderator-Ersetzungen, und nahtlose Integration, plus zusätzliches Training auf einem riesigen gelabelten Datensatz mit NSFW-Inhalten.
Stärken: behält ursprüngliche Szenenelemente und Bewegung bei, starke Identitätswahrung, realistische Integration mit Umgebung und Beleuchtung.
Kompromisse: beste Ergebnisse bei guter Pose-/Kompositionsübereinstimmung zwischen Bild und Video, sauberem Referenzmaterial. Kann instabil sein (siehe Hinweis unten).
Inhaltshinweise: Filter: Minimal
Kling 2.6 Motion
Kling 2.6 Motion
Dauer: bis zu 30s (längere Videos werden automatisch beschnitten)
Auflösung: nur 1080p
Am besten für: Choreografie und Bewegungen von einem Referenzvideo auf ein Motiv in einem Charakterbild anwenden. Ideal für komplexe Tanzschritte, Gesten, und Ganzkörper-Darbietungen. Großartig für Tanzsequenzen, Bewegungsübertragung, und die Erstellung konsistenter Charakteranimationen.
Stärken: extrahiert und überträgt vollständige Bewegung/Choreografie (einschließlich komplexer Aktionen, Hände, Gesichtsausdrücke) von einem Referenzvideo. Option zum Beibehalten des Originaltons. Starke Bewegungstreue und Charakterkonsistenz.
Kompromisse: erfordert gute Referenzvideoqualität (klare, unverdeckte Bewegungen) und ein kompatibles Charakterbild. Strengere Sicherheitsfilter als die anderen Modelle.
Inhaltshinweise: Filter: Aktiviert
MiniMax H3 Max
MiniMax H3 Max
Dauer: 5, 6, 8, 10, 12, oder 15s
Auflösung: 480p / 720p / 1080p
Am besten für: ein bestehendes Video mit einem Textprompt überarbeiten, optional kombiniert mit Referenzbildern, zusätzlichen Videos, und Audio (bis zu 9 Bilder, 3 Videos, 3 Audioclips, 12 Dateien insgesamt), um das Ergebnis zu steuern.
Stärken: Referenz-Tokens (Image 1, Video 1, Audio 1) lassen dich genau festlegen, welcher Upload welchen Teil der Bearbeitung steuert; natives Stereo-Audio bei jedem Ergebnis, kein Schalter nötig; flexible Seitenverhältnisse (16:9, 9:16, 4:3, 3:4, 1:1, 21:9, oder Adaptiv).
Nachteile: abgerechnet werden sowohl die Sekunden des Quellvideos als auch des Ergebnisses. Kein negativer Prompt; Ausschlüsse am Ende des Haupt-Prompts beschreiben. Audio kann nicht deaktiviert werden. Lange Prompts werden intern komprimiert, daher funktioniert eine kürzere, präzise Formulierung meist besser.
Inhaltshinweise: Filter: An. Nur SFW, unterstützt keine NSFW-Inhalte.
Schnellauswahl:
Brauchst du eine lange, promptgesteuerte Multi-Shot-Bearbeitung oder -Transformation (bis zu 30s) mit optionalem nativem Audio und kombinierten Video-/Bild-/Audio-Referenzen? → Wan 3.0 Spicy.
Brauchst du dasselbe Ergebnis schneller, auch wenn es pro Sekunde mehr kostet? → Wan 3.0 Prime Spicy.
Brauchst du bis zu 10 Referenzvideos plus 30 Bilder und 10 Audioclips in einer Generierung, bis zu 30s und 1080p? → Seedance 2.5 Uncensored.
Brauchst du die hochwertigste Choreografie-/Tanzübertragung, SFW? → Kling 2.6 Motion.
Möchtest du ein Standbild mit einem Referenzvideo zum Leben erwecken, stabilste Option, inklusive NSFW? → Dream Actor M2.0.
Gleiches, aber geringere Stabilität stört dich nicht → Animate.
Musst du die Person in einem vorhandenen Video austauschen und dabei die Szene beibehalten? → Replace.
Bearbeitest du ein fertiges Video (Kostüm, Hintergrund, Beleuchtung) unter Beibehaltung von Bewegung und Identität? → Seedance 2.0 Uncensored oder Seedance 2.0 Fast Spicy (günstiger, schneller).
Brauchst du die Überarbeitung eines bestehenden Videos mit einem Textprompt, plus optionalen Bild-/Video-/Audio-Referenzen, SFW? → MiniMax H3 Max.
Schritt 2. Upload your Image: wähle ein klares Porträt oder Ganzkörperfoto deiner Figur. Unterstützte Formate: JPG oder PNG. Das Bild sollte ein gut beleuchtetes, unverdecktes Gesicht zeigen (keine Sonnenbrille oder starke Schatten). Empfohlenes Minimum: 512px pro Seite.
Schritt 3. Upload your Video: lade ein Video hoch oder füge einen Link (Instagram oder TikTok) ein, der als Bewegungsquelle dienen soll; Links funktionieren nur bei einigen Modellen, während Seedance, Wan 3.0 und MiniMax H3 eine hochgeladene Videodatei benötigen. Das Video definiert Bewegung, Gesten und Ausdrücke. Dauer und Bildrate werden vom Quellvideo übernommen. Die minimal berechnete Dauer beträgt 5 Sekunden. Unterstützte Formate: MP4, MOV. Du kannst auch Keep original sound aktivieren, um Audio aus dem Quellvideo zu erhalten.
Schritt 4. Prompt: nötig für promptbasierte Modelle (Wan 3.0 Spicy, Wan 3.0 Prime Spicy, Seedance 2.0 Uncensored, Seedance 2.0 Fast Spicy, Seedance 2.5 Uncensored, MiniMax H3 Max): beschreibe, was beibehalten und was geändert werden soll, und sprich deine Uploads in der richtigen Reihenfolge mit Referenz-Tokens an ([image 1], [video 1], [audio 1]). Bewegungsübertragungs-Modelle (Dream Actor M2.0, Animate, Replace, Kling 2.6 Motion) verwenden keinen Prompt: Sie übernehmen die Bewegung direkt aus deinem Quellvideo. Nicht sicher, wie du es formulieren sollst? Klicke auf die Schaltfläche » AI Prompt Assistant unter dem Feld, um deine Idee in einen richtig formatierten Prompt zu verwandeln.
Schritt 5. Resolution: wähle die Auflösung des Ausgabevideos. Die meisten Modelle bieten 720p oder 480p; Wan 3.0 Spicy, Wan 3.0 Prime Spicy, Seedance 2.5 Uncensored, MiniMax H3 Max und Kling 2.6 Motion bieten zusätzlich 1080p.
Schritt 6. Generate: klicke auf Generate und warte, während das Modell dein Video verarbeitet. Jede Generierung kostet Credits, abhängig von der gewählten Dauer und Einstellungen. Dein Ergebnis erscheint in der Aufgabenliste, bereit zur Vorschau, zum Herunterladen, oder zur Weiterleitung.
Tipps für beste Ergebnisse
Komposition & Pose abstimmen: halte das hochgeladene Bild und Video in Kameraposition und Körperhaltung ausgerichtet. Fehlausrichtung kann zu Gesichtsverzerrung oder Bildabweichungen führen.
Seitenverhältnisse konsistent halten: wenn dein Foto und Video unterschiedliche Seitenverhältnisse haben, muss die KI zuschneiden oder strecken, um es anzupassen. Übereinstimmende Verhältnisse ergeben eine genauere Gesichtszuordnung und flüssigere Bewegung.
Qualität ist entscheidend: je höher Auflösung und Klarheit deiner Eingaben, desto besser die Ausgabe. Vermeide unscharfe Gesichter, überbelichtete Beleuchtung, oder extreme Bewegungsunschärfe.
Folge den Vorlagenbeispielen: nutze die integrierten Vorlagen in diesem Tool, um zu verstehen, was das Modell realistisch leisten kann. Sie spiegeln die Arten von Bewegung und Szenen wider, die das Modell am besten bewältigt.
Verwende stabile Videoreferenzen: wähle Videos, bei denen die Kamera stabil ist und das Gesicht klar sichtbar und zentriert bleibt. Vermeide komplexe Szenen, schnelle Bewegung, oder häufige Kamerawechsel für zuverlässigere Ergebnisse.
Problembehandlung
Du arbeitest mit KI: Gelegentliche Fehler, Artefakte, oder unerwartete Ergebnisse sind normal, ein zu 100 % korrektes Ergebnis ist nicht garantiert. Wenn ein Clip nicht richtig aussieht, versuche eine erneute Generierung oder passe deine Eingaben an.
Animate und Replace können instabil sein. Verwende nur hochwertiges Material und vermeide lange Videoreferenzen, sonst können wir kein normales Ergebnis garantieren.
Falls etwas nicht wie erwartet funktioniert hat, kontaktiere uns über den Support-Chat in der App oder schreibe an [email protected].
FAQ
Was passiert, wenn mein Video kein sichtbares Gesicht enthält?
Was passiert, wenn mein Video kein sichtbares Gesicht enthält?
Du erhältst einen Fehler, aber deine Credits werden automatisch zurückerstattet.
Kann ich lange Clips hochladen?
Kann ich lange Clips hochladen?
Ja, bis zu 30 Sekunden.
Warum flackert oder ändert sich das Gesicht während des Videos?
Warum flackert oder ändert sich das Gesicht während des Videos?
Das kann passieren, wenn das Gesicht nicht in allen Bildern klar sichtbar ist, das Video schnelle Bewegungen oder Schnitte enthält, oder sich die Beleuchtung erheblich ändert. Für beste Ergebnisse verwende stabile Videos mit konsistenter Beleuchtung und sichtbarem Gesicht.
Warum ist meine Generierung fehlgeschlagen?
Warum ist meine Generierung fehlgeschlagen?
Deine Aufgabe kann aufgrund nicht unterstützter oder beschädigter Dateien, sehr niedriger Eingabequalität, Inhaltsbeschränkungen je nach gewähltem Modell, oder instabiler Bewegung im Quellvideo fehlschlagen. Versuche, deine Eingaben zu vereinfachen und ein kürzeres oder klareres Video zu verwenden.
Was ist der Unterschied zwischen Animate und Kling 2.6 Motion?
Was ist der Unterschied zwischen Animate und Kling 2.6 Motion?
Animate folgt der Bewegung des Videos und ist schneller, aber weniger stabil. Kling 2.6 Motion bietet höhere Qualität und Konsistenz, verwendet aber strengere Sicherheitsfilter.
Warum wird mein Video auf 30 Sekunden gekürzt?
Warum wird mein Video auf 30 Sekunden gekürzt?
Kling 2.6 Motion unterstützt eine maximale Dauer von 30 Sekunden. Wenn dein Video länger ist, wird es automatisch beschnitten.
Kann ich Videos von Instagram oder TikTok verwenden?
Kann ich Videos von Instagram oder TikTok verwenden?
Ja, du kannst Links direkt in das Tool einfügen. Links funktionieren nur bei einigen Modellen, während Seedance, Wan 3.0 und MiniMax H3 eine hochgeladene Videodatei benötigen. Stelle sicher, dass das Video öffentlich und zugänglich ist.
Werde ich belastet, wenn die Generierung fehlschlägt?
Werde ich belastet, wenn die Generierung fehlschlägt?
Nein. Credits für fehlgeschlagene Aufgaben werden automatisch deinem Guthaben zurückerstattet.
Vollständige Modellkurse
Möchtest du tiefer in den Prompting-Stil eines bestimmten Modells einsteigen? Jedes hat seinen eigenen ausführlichen Kurs innerhalb von ZenCreator:
Wie geht es weiter
Video Upscaler: schärfe und vergrößere dein Ergebnis
Video Merger: kombiniere Clips zu einem längeren Video
Image Editor: poliere dein Ausgangsfoto vor dem Hochladen
War dies hilfreich?
Brauchen Sie noch Hilfe? Team fragen