Text to Image
撰寫提示詞,生成一批可以立即放大、換臉或發布的圖片。
最後更新 1 天前
該工具的功能
Text to Image 直接從文字創建圖片。你可以控制主體、場景、光線、構圖和風格。選擇一個符合你需要的風格和內容限制的模型。生成結果具有商業授權,可發送到任何 ZenCreator 工具進行後續處理。
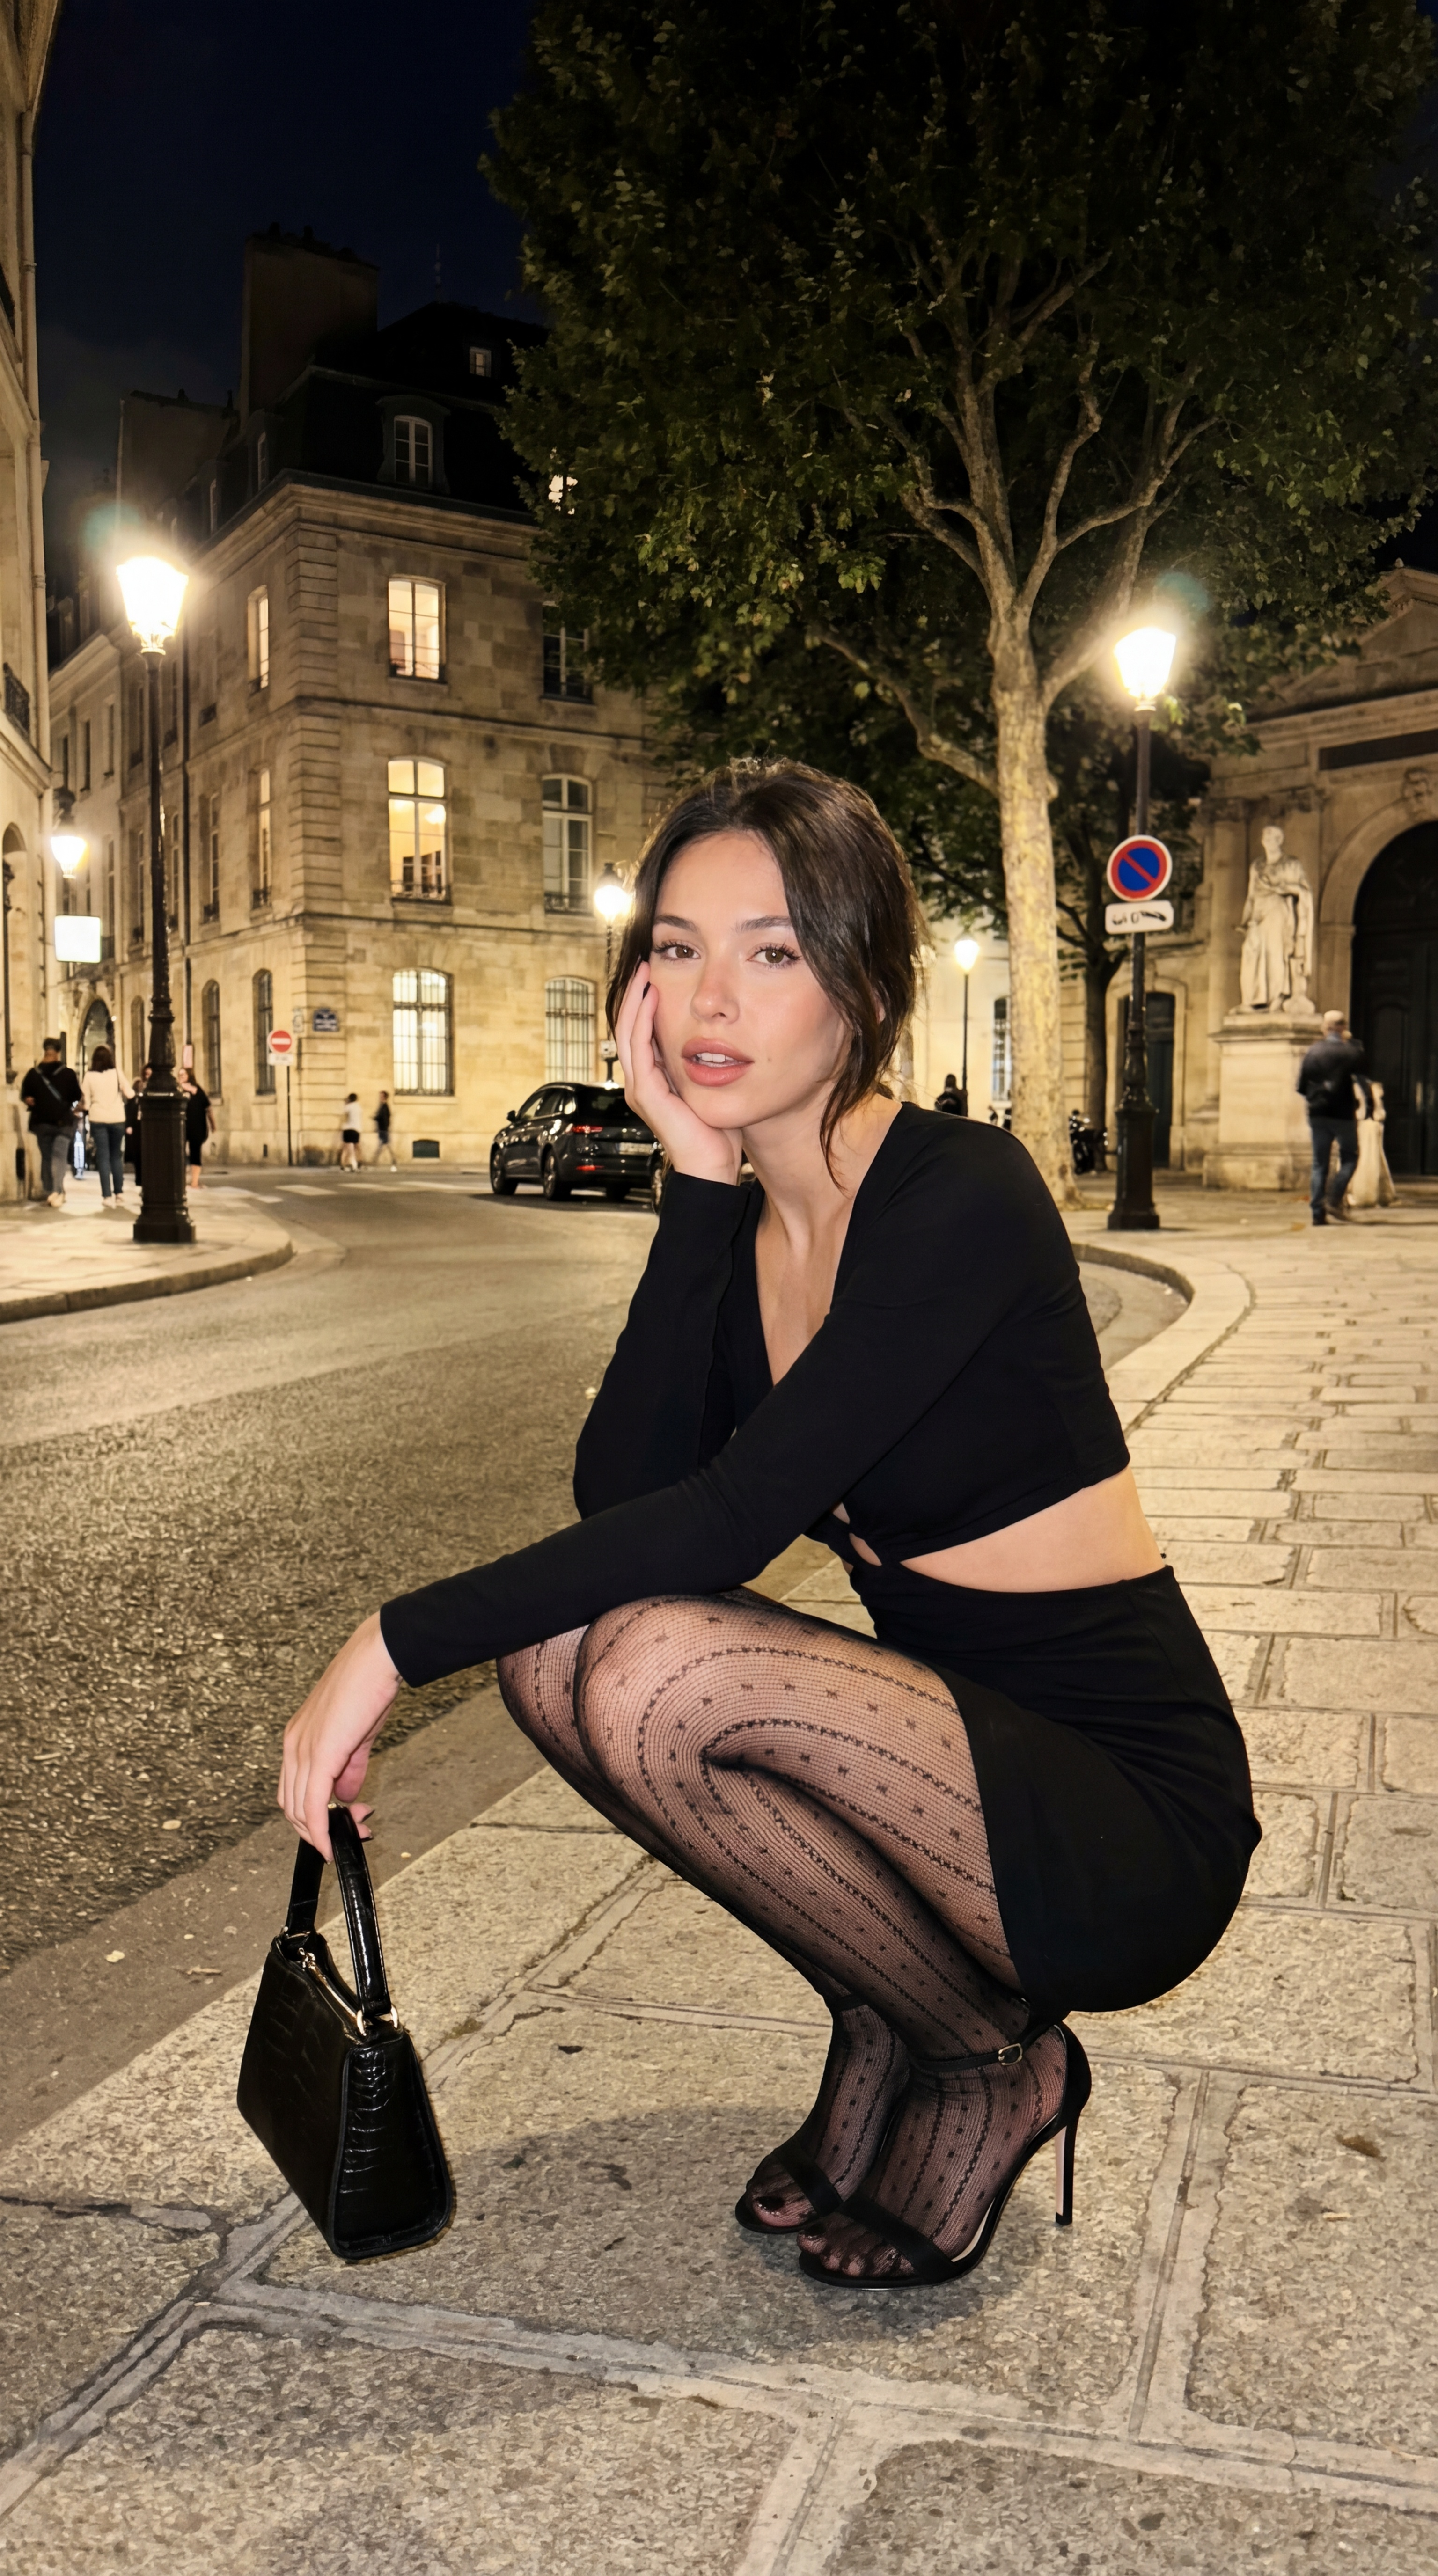
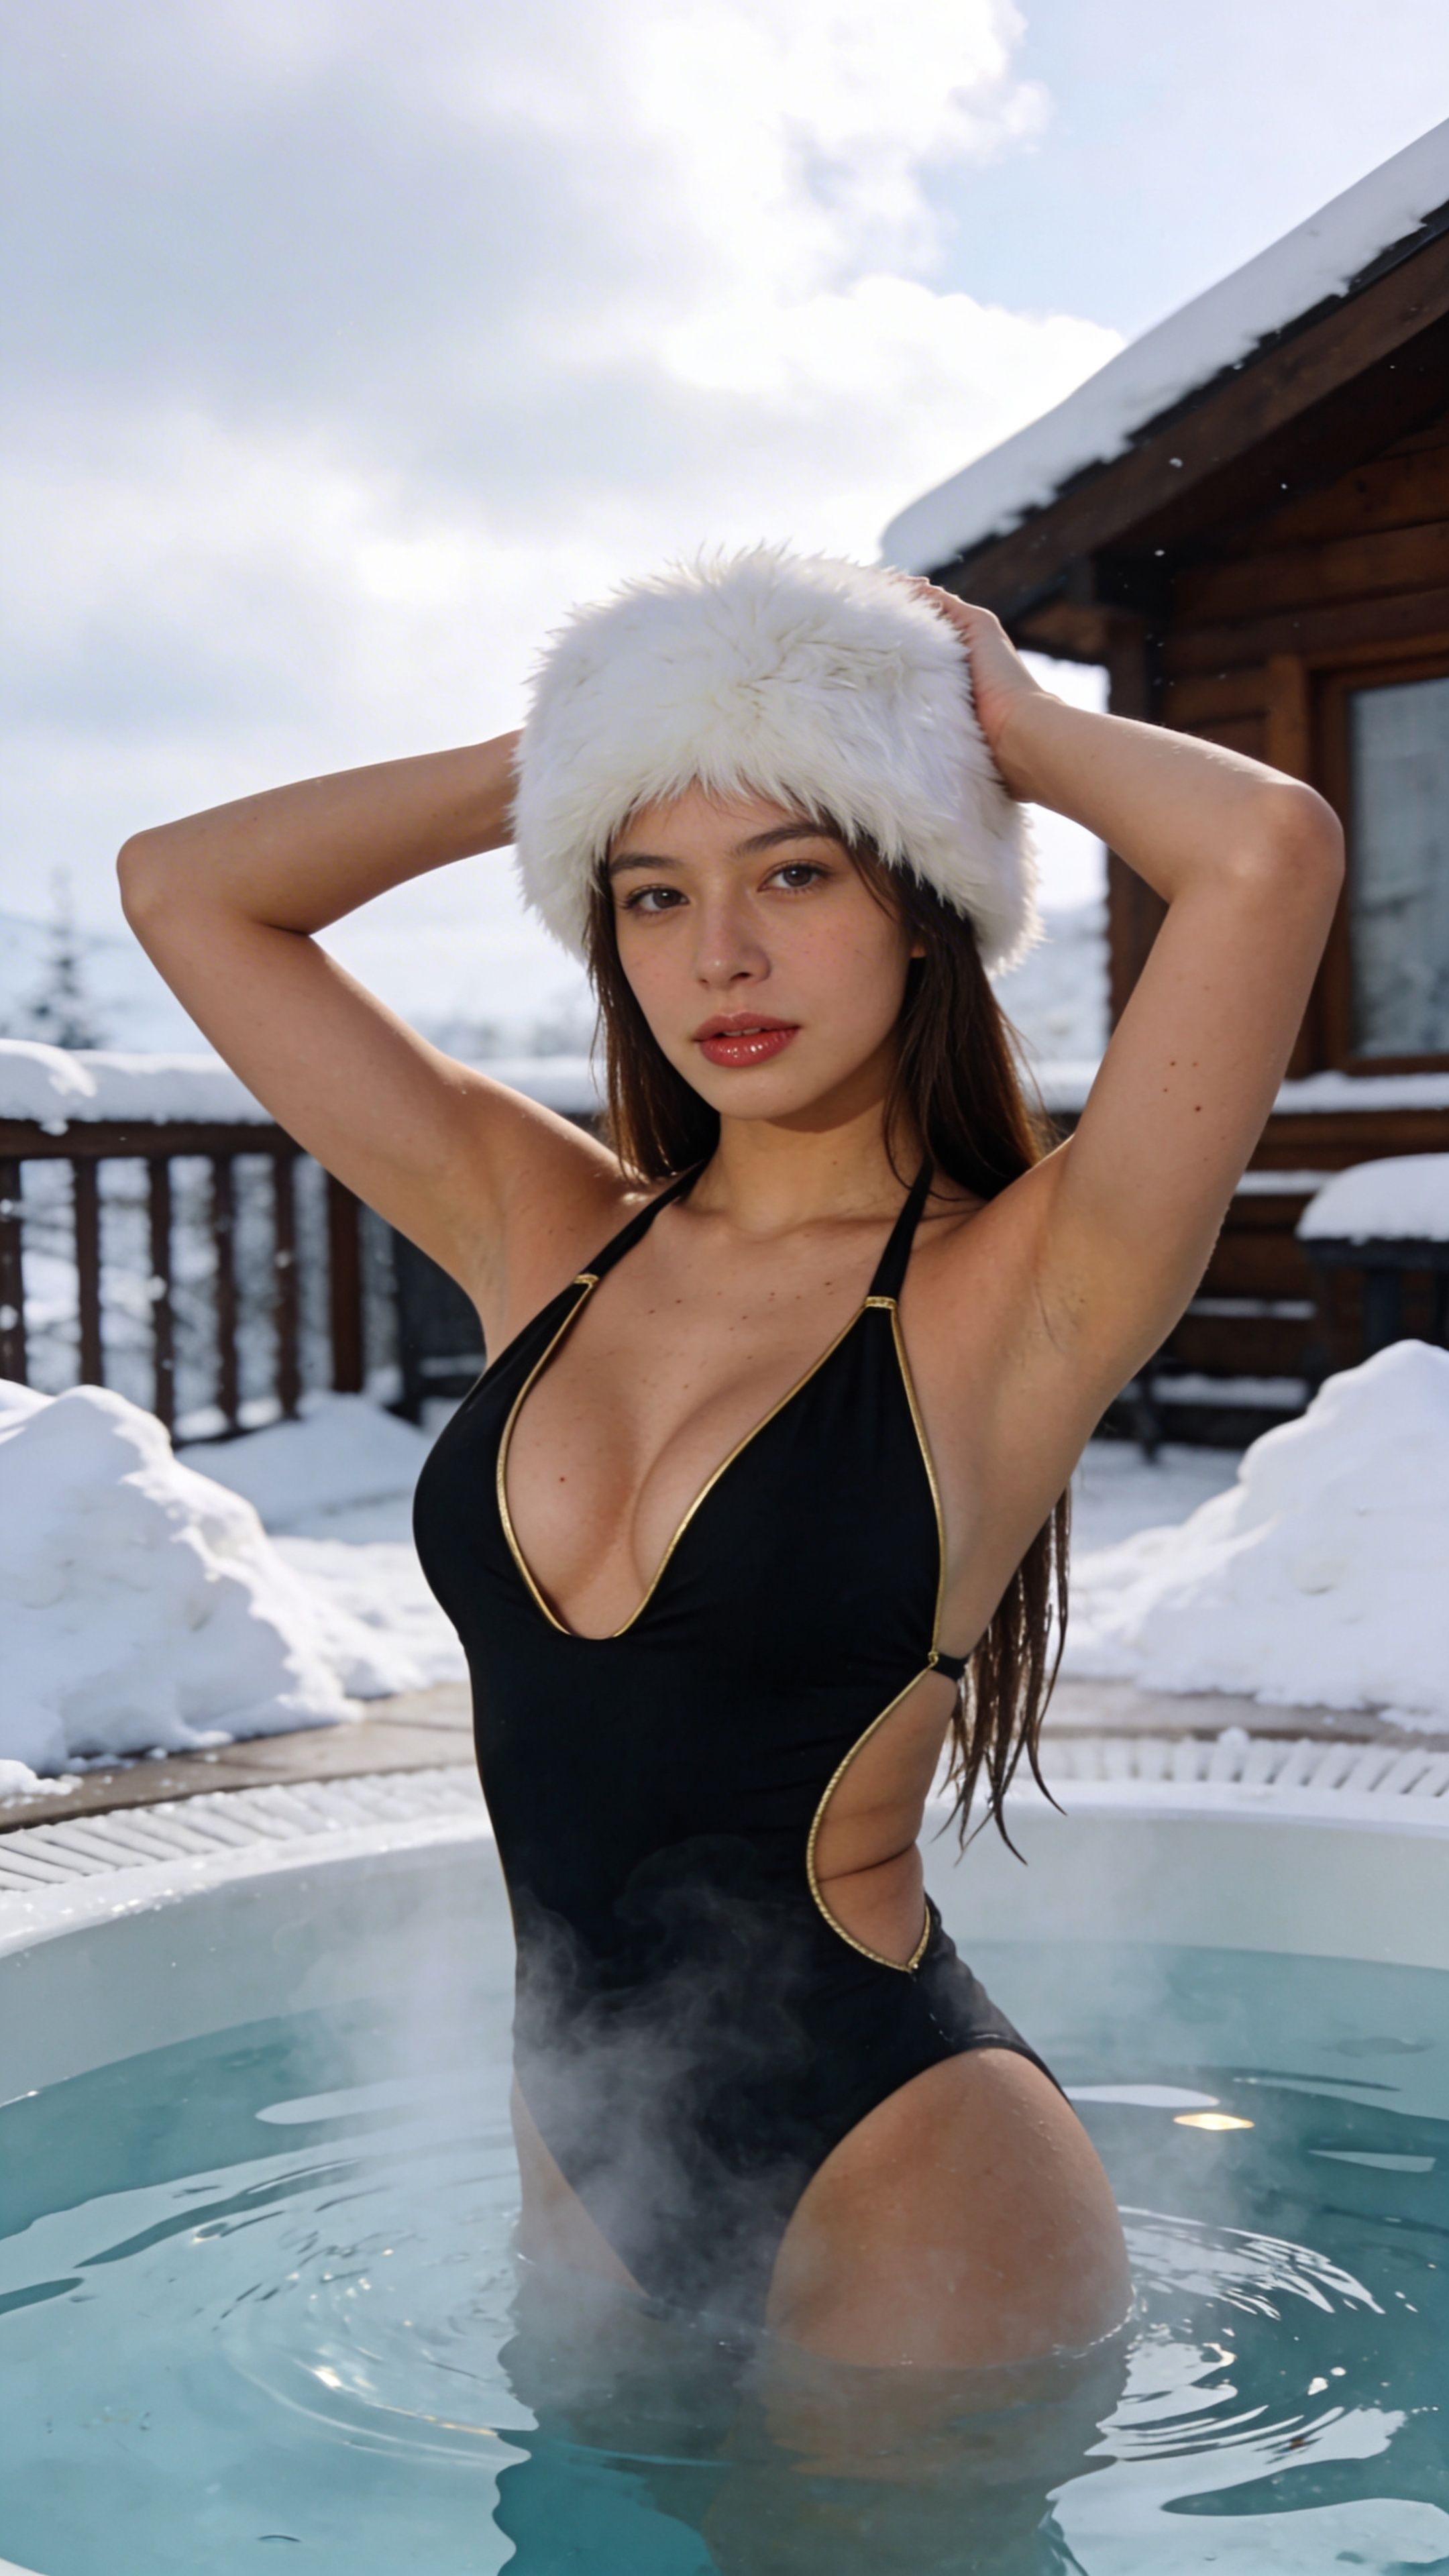
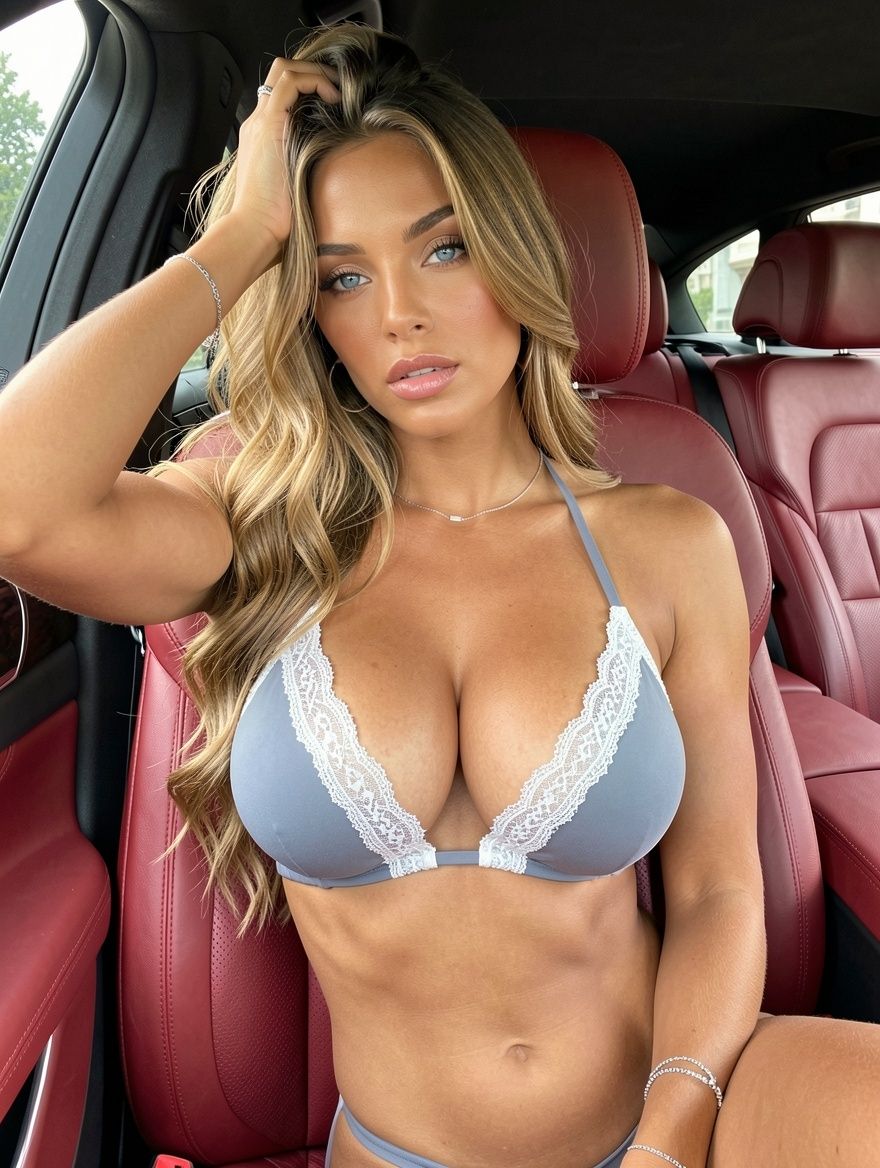
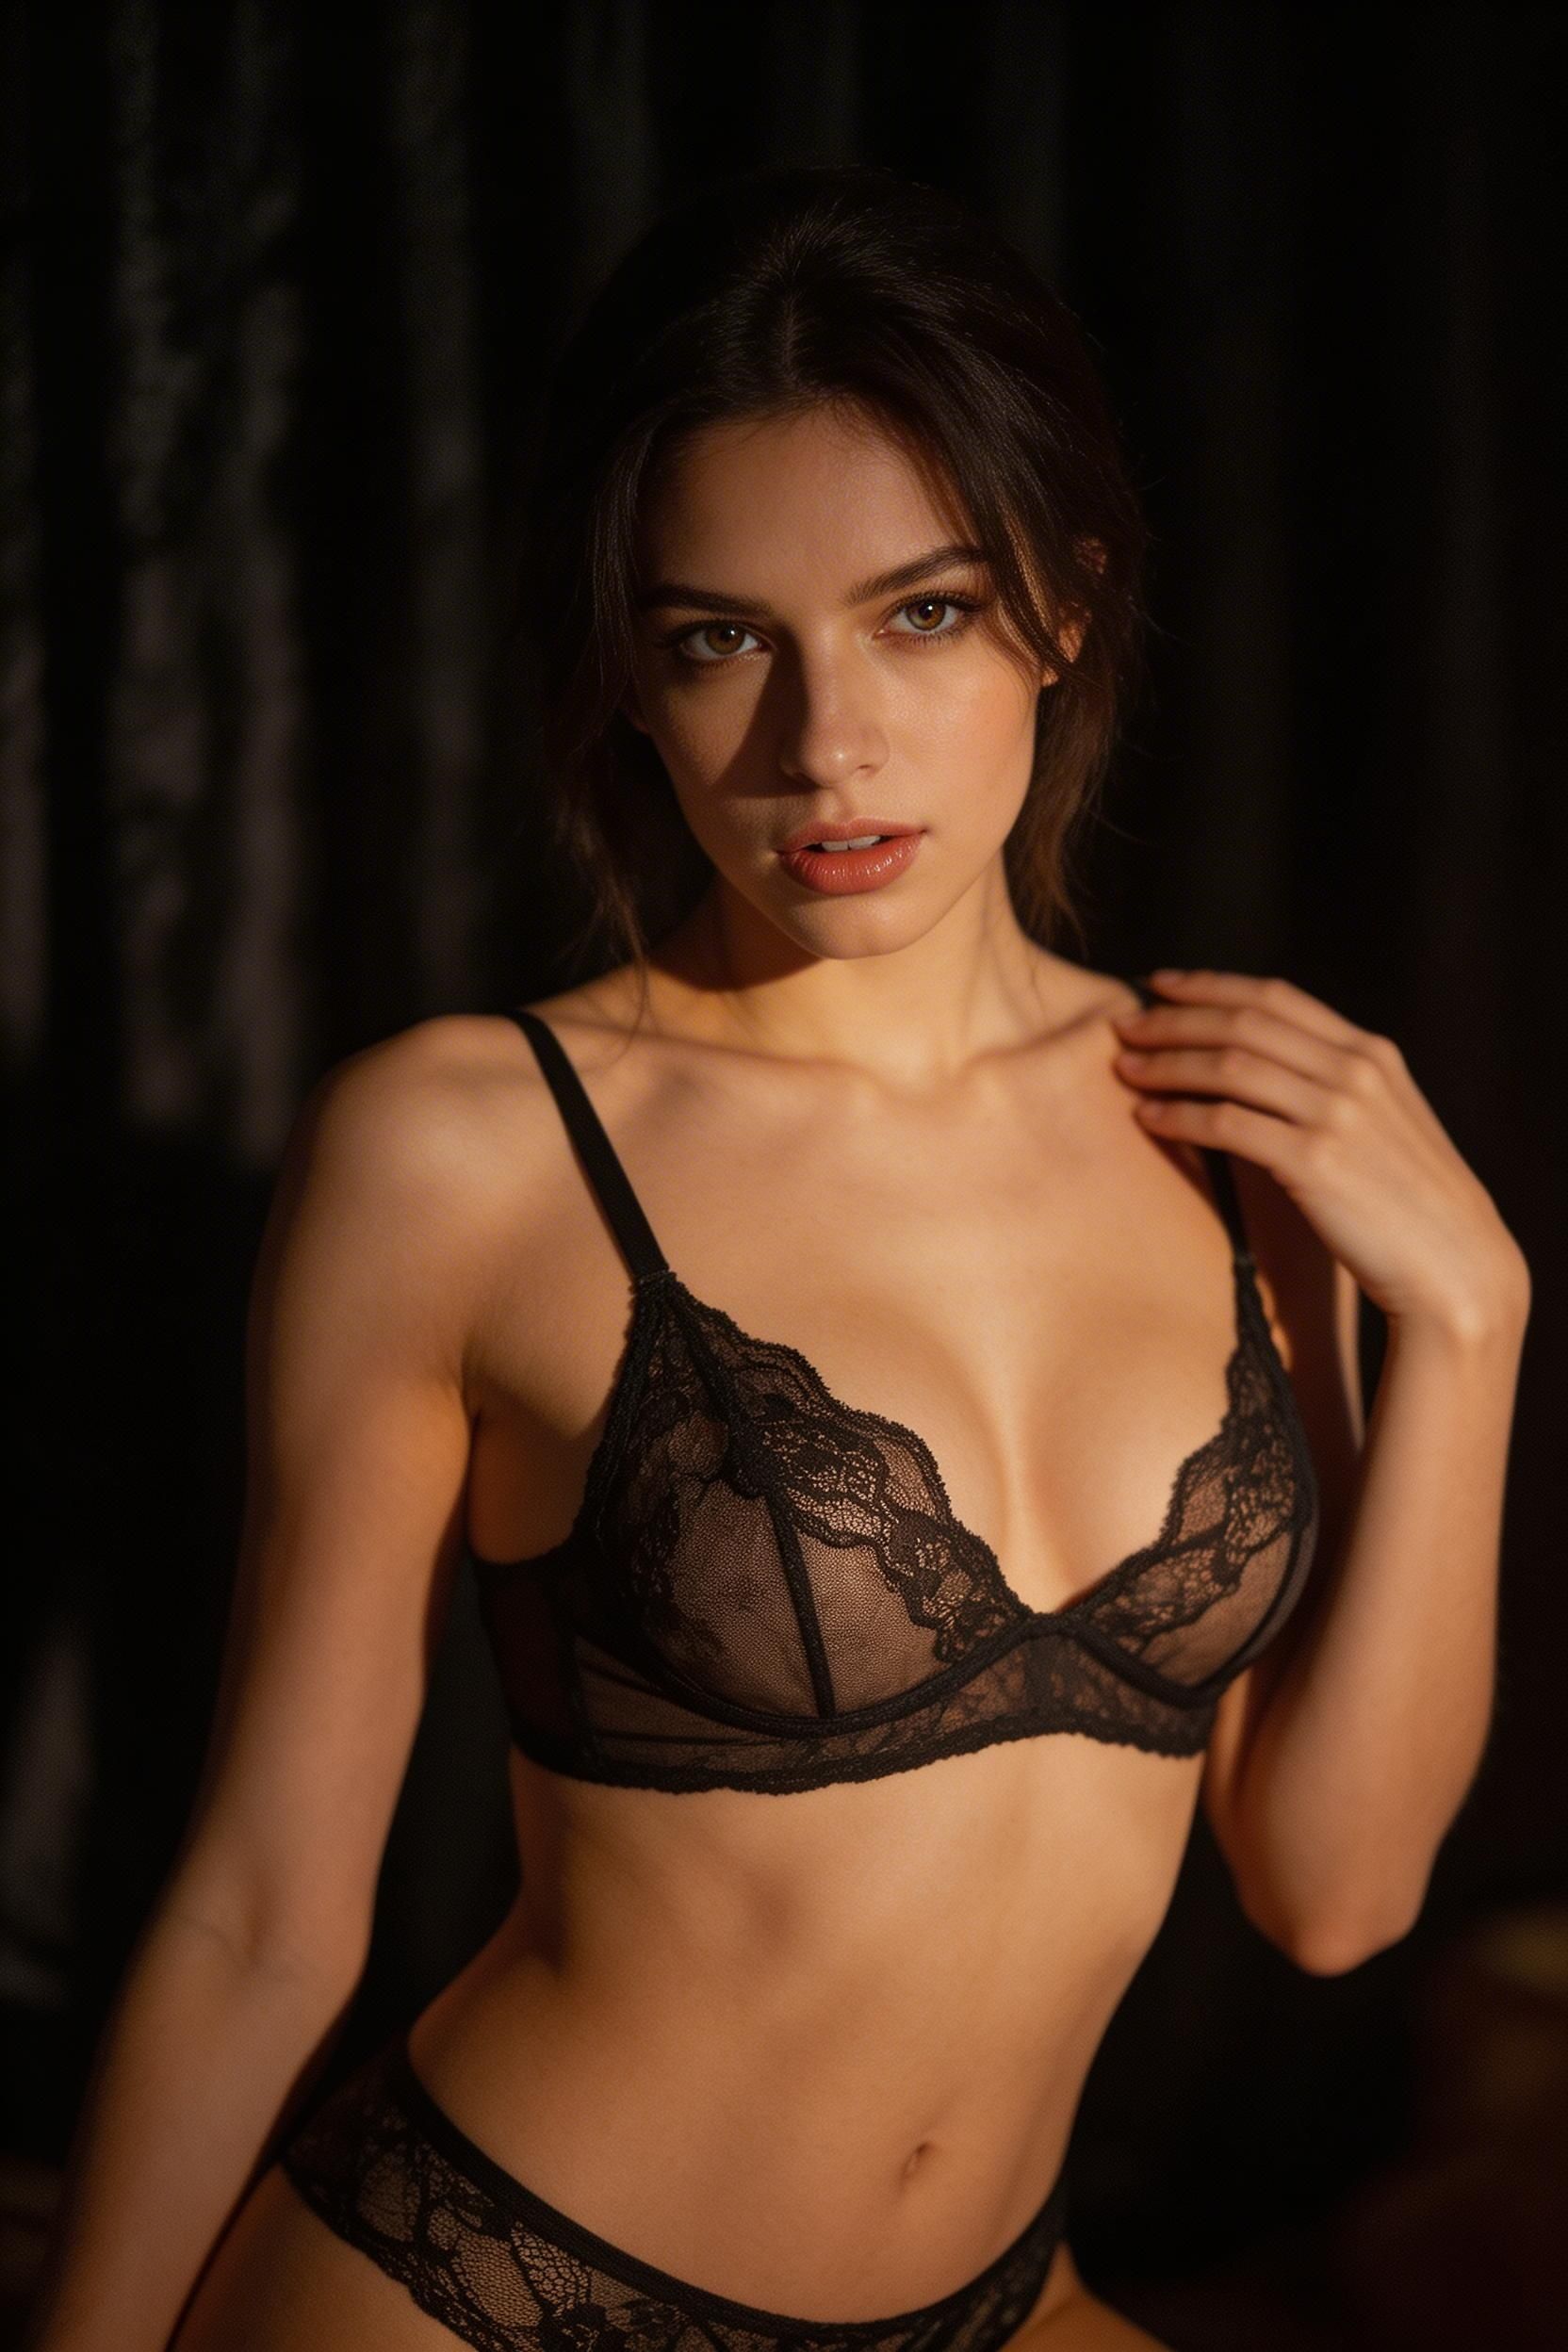
🎬 效果展示
看看 Text to Image 僅憑提示詞就能生成怎樣的效果。
不想自己設置一切?
跳過設定:從 Templates 範本庫中選擇一個現成風格,只需添加你的提示詞。
分步操作指南
第 1 步:Model:從下拉列表中選擇圖片生成模型。點擊下方任意模型即可查看其擅長領域。
WAN 2.7 Image
WAN 2.7 Image
概述
為更靈活、更具表現力的生成而設計的下一代 WAN 模型。
要點
能很好地適應各種提示詞和場景。
以最低安全過濾運行(同時支援 SFW 和 NSFW 內容)。
提供一致的結果,輸出具有更多變化。
適合多樣化、限制較少的生成。
Seedream 5
Seedream 5
概述
專注於智慧生成、可控編輯和增強推理能力的下一代 AI 圖片模型。
要點
將圖片生成與邏輯推理和指令遵循相結合。
專為更複雜的構圖和結構化提示詞而設計。
最適合高品質輸出以及更高級、更受控的生成任務。
Qwen Image
Qwen Image
概述
Qwen 系列的通用模型,專注於結構化和可預測的生成。
要點
在不同提示詞下都能生成穩定、一致的結果。
以最低安全過濾運行(同時支援 SFW 和 NSFW 內容)。
無需大量提示詞調整即可處理各種風格。
適合日常圖片生成。
Nano Banana 2
Nano Banana 2
概述
為乾淨、商業化視覺效果優化的高品質 SFW 模型。
要點
可生成最高 2K 解析度的圖片。
在安全過濾開啟的狀態下運行(僅支援 SFW 內容)。
解剖結構乾淨、面部穩定、外觀精緻。
非常適合時尚、生活風格和品牌內容。
Seedream 5 Pro
Seedream 5 Pro
概述
最新的 Seedream 旗艦模型,專為頂級提示詞理解和真實感而打造。
要點
支援全部 15 種長寬比,是此工具中支援長寬比最多的模型。
解析度檔位切換:1K(2 credits)或 2K(3 credits)。
以最低安全過濾運行(同時支援 SFW 和 NSFW 內容)。
最適合追求最高保真度、最受控輸出的場景。
General
General
概述
為最大化輸出品質而優化的通用高解析度模型。
要點
以原生 4K 生成圖片。
以最低安全過濾運行(同時支援 SFW 和 NSFW 內容)。
無需額外調整即可實現均衡的真實感、解剖結構和光線。
當你需要可直接發布的最終圖片時的最佳選擇。
Flux Klein Spicy
Flux Klein Spicy
概述
內容限制更少、支援靈活創意工作流程的快速生成模型。
要點
專為快速迭代打造的速度優化架構。
由於過濾最少,可實現更靈活的內容生成。
支援迭代式工作流程和快速實驗。
最適合需要靈活性的快速生成場景。
Qwen Image Pro
Qwen Image Pro
概述
Qwen Image 的增強版本,輸出品質更精細。
要點
與基礎模型相比,生成的結果更乾淨、更精細。
在不同提示詞下保持一致的輸出。
以最低安全過濾運行(同時支援 SFW 和 NSFW 內容)。
更適合用於最終圖片。
WAN 2.7 Pro
WAN 2.7 Pro
概述
細節更豐富、輸出更具表現力的高級 WAN 模型。
要點
與 WAN 2.7 Image 相比,生成結果更加詳細。
能更好地處理複雜場景和構圖。
以最低安全過濾運行(同時支援 SFW 和 NSFW 內容)。
推薦用於高品質的最終圖片。
Krea 2
Krea 2
概述
快速的照片級真實感模型,始終套用我們內建的風格 LoRA,無需選擇自訂 LoRA。
要點
使用專門為逼真成人內容訓練的風格 LoRA;該 LoRA 無法替換或關閉。
兩個品質檔位:1K(1 credit)或 2K(2 credits)。風格和構圖相同,只有解析度和價格不同。
忽略手動寬/高、負面提示詞和 LoRA 選擇;尺寸僅由長寬比 + 檔位決定。
Z-Image Spicy
Z-Image Spicy
概述
無審查的照片級真實感模型,僅支援文字生成圖片,不接受參考圖片。
要點
額外針對露骨內容進行了訓練,僅憑文字也能畫得很好。
兩種模式:Standard(1 credit,更快)或 Pro(2 credits,細節更精細)。
服務商會在生成前自動改寫並擴展你的提示詞,因此簡短具體的提示詞(40–120 個字,一段)通常比冗長詳細的效果更好。
忽略手動寬/高、負面提示詞和 LoRA;尺寸僅由長寬比決定。
快速選擇:
最快最便宜,只是測試一個想法 → Qwen Image。
特定姿勢或詳細場景,無內容審查 → WAN 2.7 Image。
電影感、雜誌風格的色彩 → Seedream 5(或使用 Pro 獲得最清晰的版本,任意解析度/比例)。
可直接用於動畫的乾淨 SFW 照片 → Nano Banana 2。
角色系列中保持同一張臉,最高品質 → General。
逼真的裸體照片 → Flux Klein Spicy。
最清晰、最精細的裸體圖片(值得等待) → Qwen Image Pro 或 WAN 2.7 Pro。
用內建風格快速獲得清晰逼真的圖片 → Krea 2。
僅憑文字生成露骨內容,簡短精確的提示詞 → Z-Image Spicy。
第 2 步:Prompt:描述你想在圖片中看到的內容。請具體說明主體、服裝、姿勢、光線、鏡頭角度、氛圍和環境。使用 Magic Prompt 可自動將簡短的想法擴展為詳細的提示詞,適用於所有模型。對結果不滿意?點擊 Revert 恢復到你輸入的內容。
第 3 步:Negative Prompt(可選):列出模型應避免的內容(解剖結構錯誤、多餘的手指、模糊、浮水印、文字、瑕疵)。是否可用取決於所選模型。
第 4 步:Aspect Ratio:為生成的圖片選擇所需的長寬比(例如 1:1、3:4、9:16)。這決定了所有輸出的長寬比例。
第 5 步:Resize (W / H):以像素為單位手動設定輸出解析度。最大解析度取決於所選模型(最高 4K)。
第 6 步:Number of Images:選擇本次運行要生成的變體數量(最多 10 個)。
第 7 步:Start Generation:啟動任務。生成開始前,按鈕下方會顯示總 credits 費用。
處理結果
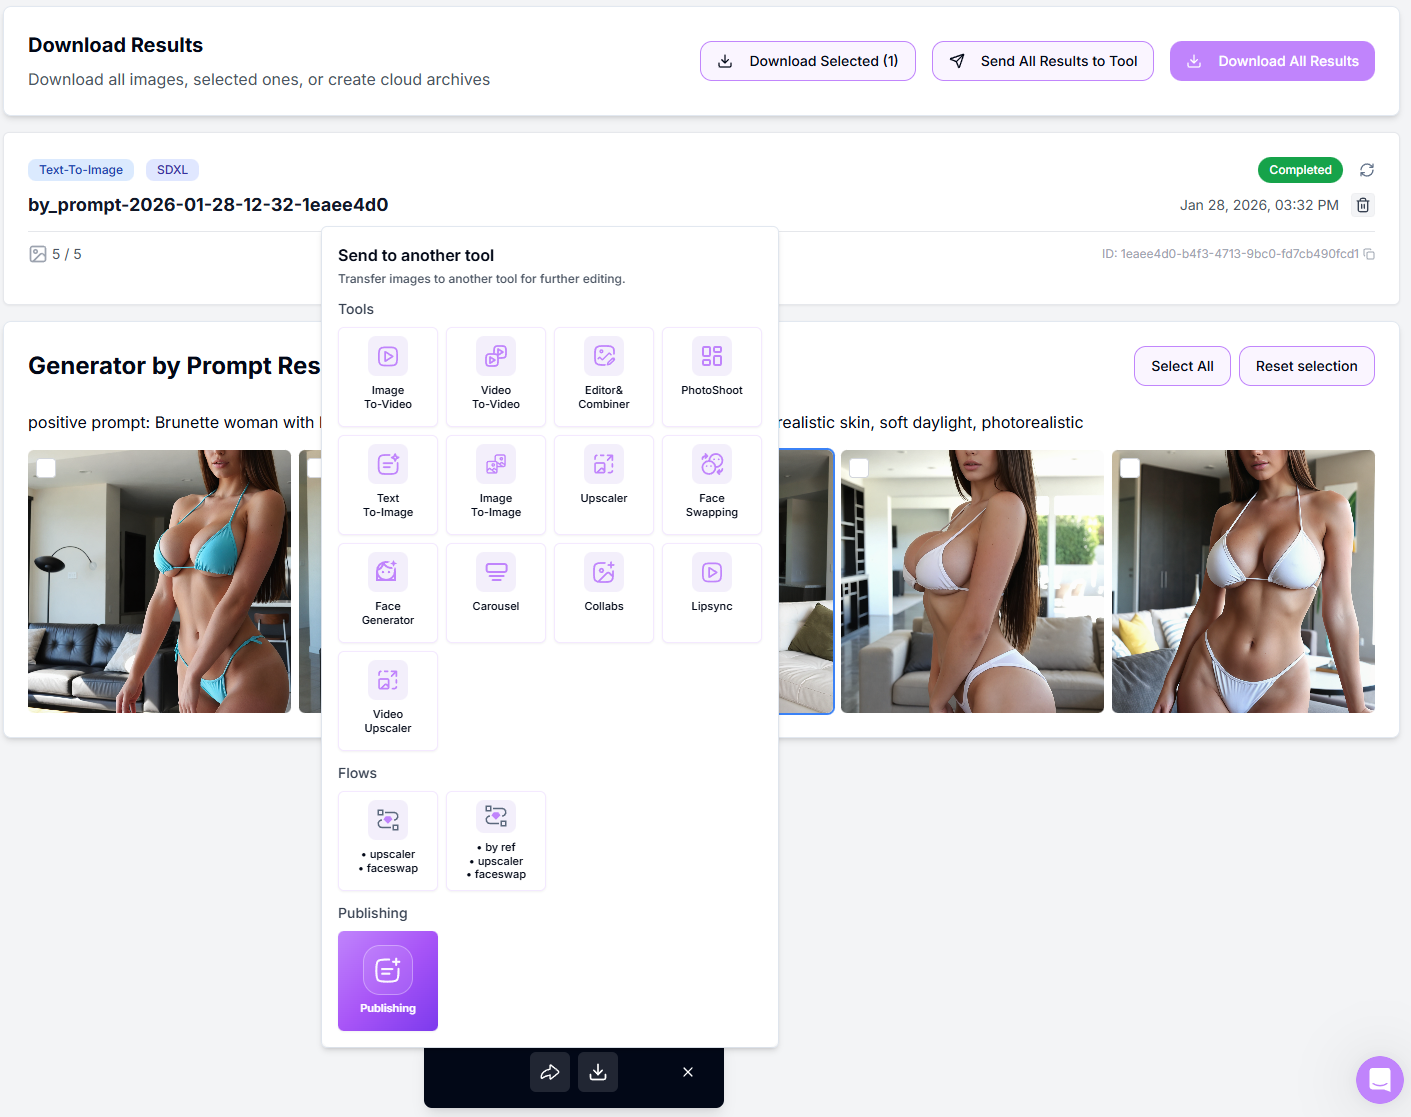
使用縮圖上的核取方塊進行選擇/取消選擇。
使用 Download Selected / Download All 匯出為 ZIP。
發送到其他工具以繼續你的工作流程(Image Upscaler、Head & Face Swap、Reference-To-Image、Image to Video、Variations)。
如果有畫面渲染失敗,Retry Failed 會自動出現。
提示詞技巧(可直接複製使用)
肖像: 「35mm portrait of [subject], half-body, eye contact, soft window light, shallow depth of field, natural skin, neutral color grade, realistic texture, high detail」。負面提示詞:「lowres, over-smooth skin, bad anatomy, extra fingers, watermark」
生活風格: 「[subject] walking in [location], candid pose, golden hour backlight, film look, natural grain, realistic proportions, composition rule of thirds」。負面提示詞:「cartoonish, plastic skin, lens distortion, duplicate face」
時尚: 「[subject] studio fashion shot, 3/4 pose, key light + rim, clean backdrop, editorial style, crisp shadows, high-end retouch look」。負面提示詞:「blown highlights, muddy blacks, JPEG artefacts」
查看完整指南:如何寫出好的提示詞。
專業技巧
保持提示詞直觀簡潔:描述你看到的畫面,而不是模型應該如何運作。
如果結果在更高解析度下顯得模糊,請將所選圖片作為最後一步發送到 Image Upscaler。
如果面部身份不夠穩定,請在生成後將所選圖片發送到 Head & Face Swap 以鎖定面部。
先生成 2–4 張圖片,確認效果後,再為正式批量生產增加圖片數量。
避免在一次運行中混合使用極端風格和高強度 LoRA,否則一致性會迅速下降。
疑難排解
這是 AI 處理結果,偶爾出現錯誤或瑕疵屬於正常現象,無法保證 100% 準確。
解剖結構或服裝扭曲 → 簡化提示詞,或嘗試其他模型。
如果結果不符合預期,請透過應用程式內的客服聊天與我們聯繫,或發送郵件至 [email protected]。
常見問題
哪個模型更逼真?
哪個模型更逼真?
對於 SFW 內容,Nano Banana 2 通常是最逼真的選項。若需要整體最高輸出品質和最終圖片,請使用 General。對於 NSFW 內容,請使用 General。
為什麼會出現瑕疵?
為什麼會出現瑕疵?
LoRA 強度過高或競爭的 LoRA 過多。請降低強度、移除一個 LoRA,或簡化提示詞。
提示詞必須用英語撰寫嗎?
提示詞必須用英語撰寫嗎?
提示詞可以用不同語言撰寫,但模型對英語的理解最好。使用其他語言的提示詞時,無法保證結果品質,因此建議使用英語撰寫提示詞。
我可以直接生成超高解析度的圖片嗎?
我可以直接生成超高解析度的圖片嗎?
可以,取決於模型。若需要最高解析度的輸出,請使用 General(4K)。對於其他模型,請先生成,然後將所選圖片發送到 Image Upscaler。
我應該始終使用 Negative Prompt 嗎?
我應該始終使用 Negative Prompt 嗎?
不一定,但在生成人物時建議使用。簡短的負面提示詞有助於減少解剖結構問題、模糊和不需要的瑕疵。
接下來
Image Upscaler:讓結果更清晰、放大結果
Head & Face Swap:固定一致的面部
Reference-To-Image:基於此結果構建變體
Image to Video:為最終圖片添加動畫
這是否有幫助?
仍需要協助嗎? 詢問團隊