Video to Video
使用我們的 AI Video to Video Generator,將靜態照片轉化為動態影像,或替換影片中的人物。 上傳一張照片和一段影片,創造出視覺一致性極高的動感電影級效果。
最後更新 大約 5 小時前
該工具的功能
Video to Video 有兩種運作方式:使用參考影片中的動作為靜態照片添加動畫,或將現有影片中的人物替換為其他人,同時保持原始場景、鏡頭運用和動作不變。例如,用他人的舞蹈動作讓一張肖像「活起來」,或用你自己的照片替換影片中的主持人。完全支援 NSFW。
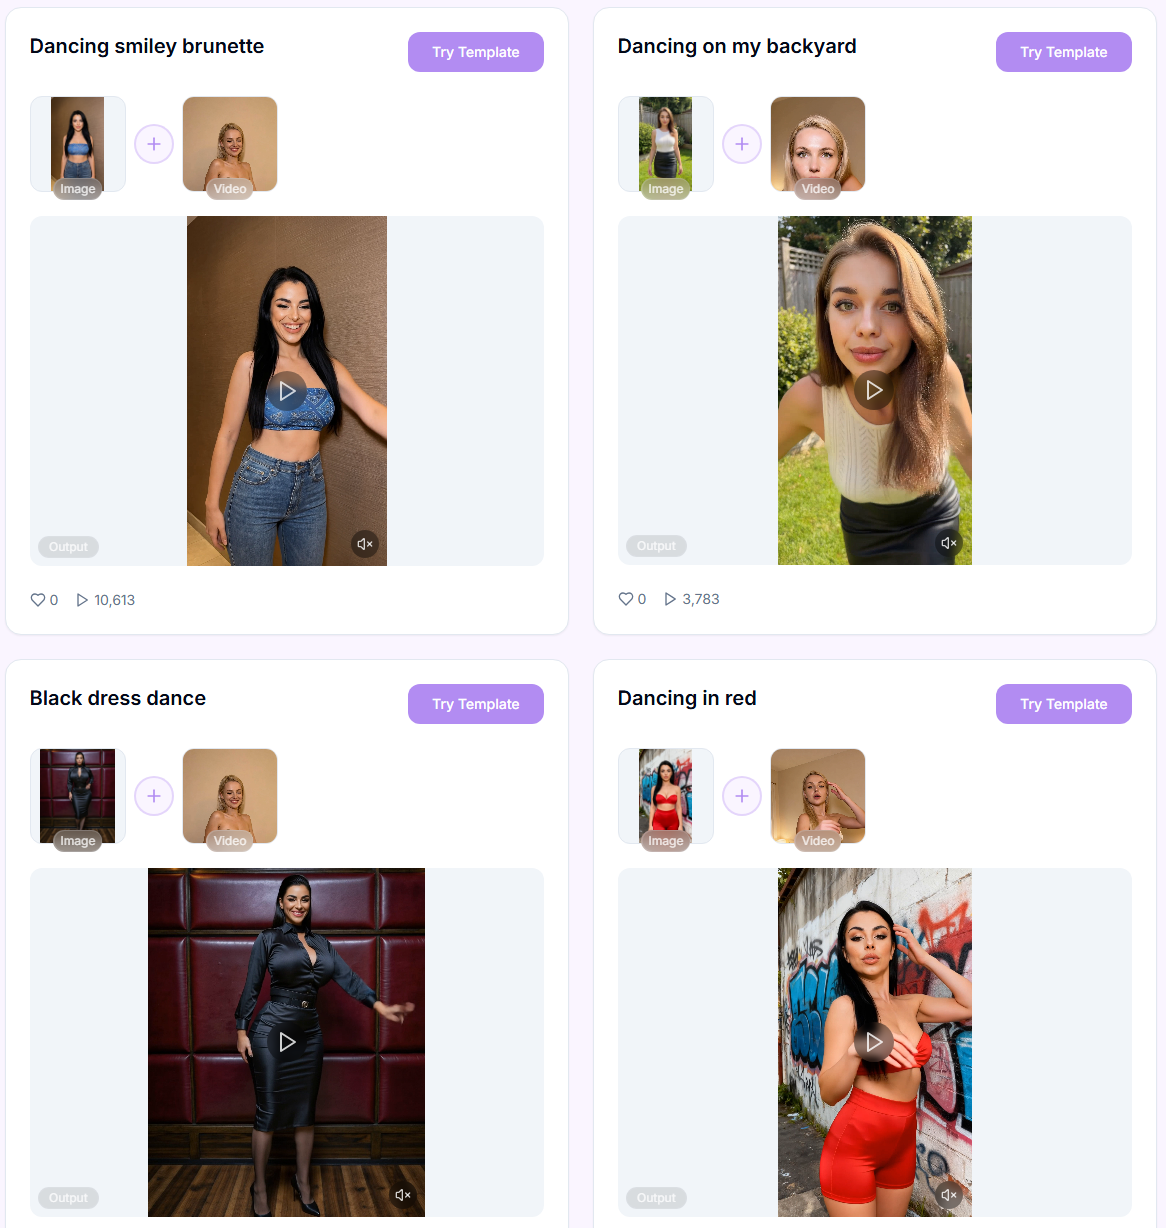
🎬 效果展示
看看 Video to Video 能用一張照片和一段參考影片生成怎樣的效果。
不想自己設置一切?
跳過設置,從 Templates 範本庫中選擇一個現成風格,放入你的照片和影片。範本還能讓你了解該模型最擅長處理哪些類型的動作和場景。
分步操作指南
第 1 步:Model,從下拉列表中選擇驅動轉換的模型。點擊下方任意模型即可查看其擅長領域。
Wan 3.0 Spicy
Wan 3.0 Spicy
時長: 5、10、15、20、25,或30秒
解析度: 480p / 720p / 1080p
最適合: 使用參考影片(最多3個)、參考圖片(最多9張),和參考音訊進行提示詞驅動的 video-to-video 生成,創建最長30秒的多鏡頭長編輯或轉換,可選由模型編寫的原生音訊。基於大規模標註 NSFW 內容資料集訓練。
優勢: 可透過 Generate Audio 開關自行編寫配樂;支援劃分為帶時間戳鏡頭的長劇本式提示詞;參考標記([img1]、[vid1]、[audio1])可讓你精確指定使用哪個上傳素材;比早期 Wan 模型具有更強的多主體一致性和鏡頭控制力。
權衡: 最佳效果需要與時長匹配的提示詞:短提示詞配長時長會把情節和鏡頭選擇交給模型決定。沒有負面提示詞;不需要的元素必須明確描述。
內容說明: 過濾器:最低
Wan 3.0 Prime Spicy
Wan 3.0 Prime Spicy
時長: 5、10、15、20、25,或30秒
解析度: 480p / 720p / 1080p
最適合: 與 Wan 3.0 Spicy 相同的提示詞驅動 video-to-video 生成(參考影片最多3個、參考圖片最多9張,以及參考音訊),但返回速度約快 40%。
優勢: 與 Wan 3.0 Spicy 完全相同的輸出品質和功能組合(Generate Audio 開關、劇本式提示詞、參考標記、多主體一致性);區別在於等待時間,這在測試想法或微調鏡頭時很重要。
權衡: 對於相同結果,每秒成本高於 Wan 3.0 Spicy;對提示詞長度的敏感度相同,同樣沒有負面提示詞。
內容說明: 過濾器:最低
Seedance 2.0 Uncensored
Seedance 2.0 Uncensored
時長: 5–15秒
解析度: 720p / 480p
最適合: 基於提示詞的影片生成,支援首尾格和多模態參考(圖片、影片、音訊):在保留主體動作、時序和身份的同時,編輯已完成的影片,替換服裝、背景、光線或場景。基於大規模標註的 NSFW 內容資料集訓練。
優勢: 在提示詞中清晰區分「保留什麼」和「改變什麼」,可獲得可預測的結果,而無需「重建」整個場景。當提示詞表述精確時,能很好地保留原始動畫和身體比例。能準確處理 [video 1]/[audio 1]/[image 1] 等參考,並在未提供參考時可自動生成音訊。
權衡: 描述元素的順序至關重要:如果先描述改動而非需要保留的內容,模型可能會遺失原始動作和時序。原始影片參考 [Video 1] 必須清晰,才能獲得可靠結果。3 個影片參考的最大長度為 15 秒。速度比 Seedance 2.0 Fast Spicy 慢。
內容說明: 過濾級別:最低
Seedance 2.0 Fast Spicy
Seedance 2.0 Fast Spicy
時長: 5–15秒
解析度: 720p / 480p
最適合: 採用與 Seedance 2.0 Uncensored 相同的首尾格和多模態參考方式,實現更快、更便宜的影片生成,品質良好,可在保留動作、時序和面部身份的同時編輯預錄製影片(服裝、背景、光線)。此外還基於大規模標註的 NSFW 內容資料集進行了額外訓練。
優勢: 處理時間快;在提示詞中清晰區分「保留什麼」和「改變什麼」,可獲得可預測的結果,而無需「重建」場景。比 Seedance 2.0 Uncensored 更快、更便宜。
權衡: 描述改動的順序至關重要:如果先描述改動而非需要保留的內容,模型可能會遺失原始動作和時序。原始影片參考 [Video 1] 必須清晰。3 個影片參考的最大長度為 15 秒。品質低於 Seedance 2.0 Uncensored。
內容說明: 過濾級別:最低
Seedance 2.5 Uncensored
Seedance 2.5 Uncensored
時長: 5、10、15、20 或 30 秒
解析度: 480p / 720p / 1080p
最適合: 提示詞驅動的 video-to-video 生成,可使用最多10個參考影片、30張參考圖片和10個參考音訊片段(在提示詞中以 [vid1]、[img1]、[audio1] 引用),生成最長30秒的多鏡頭長結果。基於大規模標註的 NSFW 內容資料集訓練。
優勢: 畫面更自然、更少「AI感」:鏡頭轉場、主體穩定性、光線以及皮膚和眼睛細節均有提升;帶時間戳的提示詞(「0–5s: …, 6–10s: …」)可控制何時發生什麼;可透過 Generate Audio 開關生成可選原生音訊。
權衡: 最貴的 Seedance 模型:1080p 的價格約為 720p 的 3.4 倍,且參考影片的秒數會與結果一起計費,建議先用 480p/720p 測試。不支援負面提示詞。即使開啟 Generate Audio,影片也可能沒有音訊。
內容說明: 過濾級別:最低
Dream Actor M2.0
Dream Actor M2.0
時長: 最長 30 秒
解析度: 720p / 480p
最適合: 透過精確套用參考影片中的身體動作、手勢、面部表情和唇部動作,讓靜態角色圖片「活起來」。非常適合角色表演、舞蹈序列、富有表現力的動畫,以及多角色場景,並基於大規模標註的 NSFW 內容資料集進行了額外訓練。
優勢: 出色的動作保真度和對動作的語意理解、高身份和背景一致性、在非人類和風格化角色上表現出色、表情自然、在複雜動作中輸出穩定。是讓照片「活起來」最穩定的選擇。
權衡: 構圖匹配良好、參考影片清晰(光線良好、遮擋最少)、角色圖片相容時效果最佳。
內容說明: 過濾級別:最低
Animate
Animate
時長: 最長 30 秒
解析度: 720p / 480p
最適合: 透過精確套用參考影片中的身體動作、手勢和面部表情,讓靜態角色圖片(肖像、插畫或設計)「活起來」。非常適合角色表演、舞蹈序列和富有表現力的動畫,並基於大規模標註的 NSFW 內容資料集進行了額外訓練。
優勢: 動作保真度高、表情自然,身份一致性高,複雜動作的轉移無縫流暢。
權衡: 構圖匹配良好、參考影片清晰(光線良好、遮擋最少)、角色圖片相容時效果最佳。可能不夠穩定(見下方說明)。
內容說明: 過濾級別:最低
Replace
Replace
時長: 最長 30 秒
解析度: 720p / 480p
最適合: 在保留原始動作、場景、光線和鏡頭運用的同時,將現有影片中的主要角色替換為你圖片中的主體。非常適合鏡頭中的角色替換、主持人替換,以及無縫整合,並基於大規模標註的 NSFW 內容資料集進行了額外訓練。
優勢: 保持原始場景元素和動作,身份保持能力強,與環境和光線的融合真實自然。
權衡: 圖片與影片之間的姿勢/構圖匹配良好、參考素材乾淨時效果最佳。可能不夠穩定(見下方說明)。
內容說明: 過濾級別:最低
Kling 2.6 Motion
Kling 2.6 Motion
時長: 最長 30 秒(更長的影片會自動裁剪)
解析度: 僅限 1080p
最適合: 將參考影片中的編舞和動作套用到角色圖片中的主體上。非常適合複雜的舞蹈動作、手勢和全身表演。非常適合舞蹈序列、動作轉移,以及創建一致的角色動畫。
優勢: 從參考影片中提取並轉移完整的動作/編舞(包括複雜動作、手部、面部表情)。可選擇保留原始聲音。動作保真度和角色一致性強。
權衡: 需要良好的參考影片品質(動作清晰、無遮擋)以及相容的角色圖片。安全過濾比其他模型更嚴格。
內容說明: 過濾級別:開啟
MiniMax H3 Max
MiniMax H3 Max
時長: 5秒、6秒、8秒、10秒、12秒,或15秒
解析度: 480p / 720p / 1080p
最適合: 使用文字提示詞重新處理現有影片,可選擇結合參考圖片、額外影片,和音訊(最多9張圖片、3個影片、3個音訊片段,總計12個檔案)來引導結果。
優勢: 參考標記(Image 1、Video 1、Audio 1)可讓你精確指定哪個上傳素材驅動編輯的哪個部分;每個結果都自帶原生立體聲音軌,無需開關;靈活的長寬比(16:9、9:16、4:3、3:4、1:1、21:9,或自適應)。
權衡: 會同時按來源影片秒數和輸出秒數計費。沒有負面提示詞;需將排除項寫在主提示詞末尾。音訊無法關閉。長提示詞會在內部被壓縮,因此更簡短精確的文字通常效果更好。
內容說明: 過濾器:開啟。僅限 SFW,不支援 NSFW 內容。
快速選擇:
需要長時間、提示詞驅動的多鏡頭編輯或轉換(最多30秒),結合可選原生音訊與影片/圖片/音訊參考? → Wan 3.0 Spicy。
需要同樣的結果但更快,即使每秒成本更高也可以? → Wan 3.0 Prime Spicy。
需要在單次生成中使用最多10個參考影片加30張圖片和10個音訊片段,最長30秒、最高1080p? → Seedance 2.5 Uncensored。
需要最高品質的編舞/舞蹈轉移,SFW? → Kling 2.6 Motion.
想用參考影片讓靜態照片「活起來」,最穩定的選項,包括 NSFW? → Dream Actor M2.0.
相同需求,但不介意穩定性稍低? → Animate.
需要在保留場景的同時替換現有影片中的人物? → Replace.
編輯已完成的影片(服裝、背景、光線),同時保留動作和身份? → Seedance 2.0 Uncensored 或 Seedance 2.0 Fast Spicy (更便宜、更快).
需要用文字提示詞重新處理現有影片,加上可選的圖片/影片/音訊參考,SFW? → MiniMax H3 Max。
第 2 步:Upload your Image,選擇角色清晰的肖像照或全身照。支援格式:JPG 或 PNG。圖片應顯示光線良好、無遮擋的面部(無墨鏡或濃重陰影)。建議最小尺寸:每邊 512px。
第 3 步:Upload your Video,上傳影片或貼上連結(Instagram 或 TikTok)作為動作來源。連結僅適用於部分模型,Seedance、Wan 3.0 和 MiniMax H3 需要上傳影片檔案。影片決定了動作、手勢和表情。時長和幀率取自來源影片。最低計費時長為 5 秒。支援格式:MP4、MOV。你還可以開啟 Keep original sound 以保留來源影片的音訊。
第 4 步:Prompt,提示詞驅動的模型(Wan 3.0 Spicy、Wan 3.0 Prime Spicy、Seedance 2.0 Uncensored、Seedance 2.0 Fast Spicy、Seedance 2.5 Uncensored、MiniMax H3 Max)需要此項:描述要保留什麼、要改變什麼,並按順序使用參考標記([image 1]、[video 1]、[audio 1])指向你上傳的素材。動作遷移模型(Dream Actor M2.0、Animate、Replace、Kling 2.6 Motion)不使用提示詞,它們直接從你的來源影片取得動作。不知道怎麼寫?點擊欄位下方的「» AI Prompt Assistant」按鈕,將你的想法轉換為格式正確的提示詞。
第 5 步:Resolution,選擇輸出影片的解析度。大多數模型提供 720p 或 480p;Wan 3.0 Spicy、Wan 3.0 Prime Spicy、Seedance 2.5 Uncensored、MiniMax H3 Max 和 Kling 2.6 Motion 還支援 1080p。
第 6 步:Generate,點擊 Generate,等待模型處理你的影片。每次生成的費用取決於所選時長和設定。結果會出現在任務列表中,可供預覽、下載或發送到其他工具。
獲得最佳效果的技巧
匹配構圖與姿勢:保持上傳的圖片和影片在鏡頭位置和身體姿勢上一致。不匹配可能導致面部扭曲或畫面錯位。
保持長寬比一致:如果你的照片和影片長寬比不同,AI 必須進行裁剪或拉伸以適配。比例匹配能帶來更準確的面部映射和更流暢的動作。
品質很重要:輸入素材的解析度和清晰度越高,輸出效果越好。避免模糊的面部、過曝的光線或過度的運動模糊。
參考範本範例:使用工具內建的範本,了解模型實際能達成的效果。它們反映了模型最擅長處理的動作和場景類型。
使用穩定的影片參考:選擇鏡頭穩定、面部清晰可見且居中的影片。避免複雜場景、快速動作或頻繁的鏡頭切換,以獲得更可靠的結果。
疑難排解
這是 AI 處理結果,偶爾出現錯誤、瑕疵或意外結果屬於正常現象,無法保證 100% 準確的結果。如果片段效果不理想,可嘗試重新生成或調整輸入素材。
Animate 和 Replace 可能不夠穩定。請僅使用高品質素材,並避免使用過長的影片參考,否則我們無法保證生成正常的結果。
如果結果不符合預期,請透過應用程式內的客服聊天與我們聯繫,或發送郵件至 [email protected]。
常見問題
如果我的影片不包含清晰可見的面部會怎樣?
如果我的影片不包含清晰可見的面部會怎樣?
你會收到錯誤提示,但你的 credits 會自動退還。
我可以上傳較長的片段嗎?
我可以上傳較長的片段嗎?
可以,最長支援 30 秒。
為什麼影片過程中面部會閃爍或變化?
為什麼影片過程中面部會閃爍或變化?
這可能發生在面部並非在所有畫面中都清晰可見、影片包含快速動作或剪輯、或光線發生顯著變化時。為獲得最佳效果,請使用光線一致、面部清晰可見的穩定影片。
為什麼我的生成失敗了?
為什麼我的生成失敗了?
你的任務可能因不支援或損壞的檔案、品質極低的輸入素材、根據所選模型而定的內容限制,或來源影片中不穩定的動作而失敗。請嘗試簡化輸入素材,並使用更短或更清晰的影片。
Animate 和 Kling 2.6 Motion 有什麼區別?
Animate 和 Kling 2.6 Motion 有什麼區別?
Animate 跟隨影片的動作,速度更快但穩定性較低。Kling 2.6 Motion 提供更高的品質和一致性,但使用更嚴格的安全過濾。
為什麼我的影片被裁剪為 30 秒?
為什麼我的影片被裁剪為 30 秒?
Kling 2.6 Motion 支援的最大時長為 30 秒。如果你的影片更長,將會自動裁剪。
我可以使用 Instagram 或 TikTok 的影片嗎?
我可以使用 Instagram 或 TikTok 的影片嗎?
可以,你可以直接將連結貼到工具中。連結僅適用於部分模型,Seedance、Wan 3.0 和 MiniMax H3 需要上傳影片檔案。請確保影片是公開且可存取的。
如果生成失敗,我會被扣費嗎?
如果生成失敗,我會被扣費嗎?
不會。失敗任務的 credits 會自動退還到你的餘額中。
完整模型課程
想深入了解特定模型的提示詞寫法嗎?每個模型在 ZenCreator 內都有自己的深入課程:
接下來
Video Upscaler:讓結果更清晰、放大結果
Video Merger:將片段合併為更長的影片
Image Editor:上傳前潤飾你的來源照片
這是否有幫助?
仍需要協助嗎? 詢問團隊