Text to Video
撰寫提示詞,選擇模型,選擇最高 1080p 的解析度,下載你的片段。
最後更新 大約 5 小時前
該工具的功能
Text to Video 直接根據文字建立影片,無需參考圖片。你可以控制主體、外觀、場景、光線、鏡頭角度、構圖和風格。選擇一個模型,撰寫提示詞,並選擇長寬比和時長。生成結果享有商業授權,可發送至任何 ZenCreator 工具繼續處理。完全支援 NSFW。
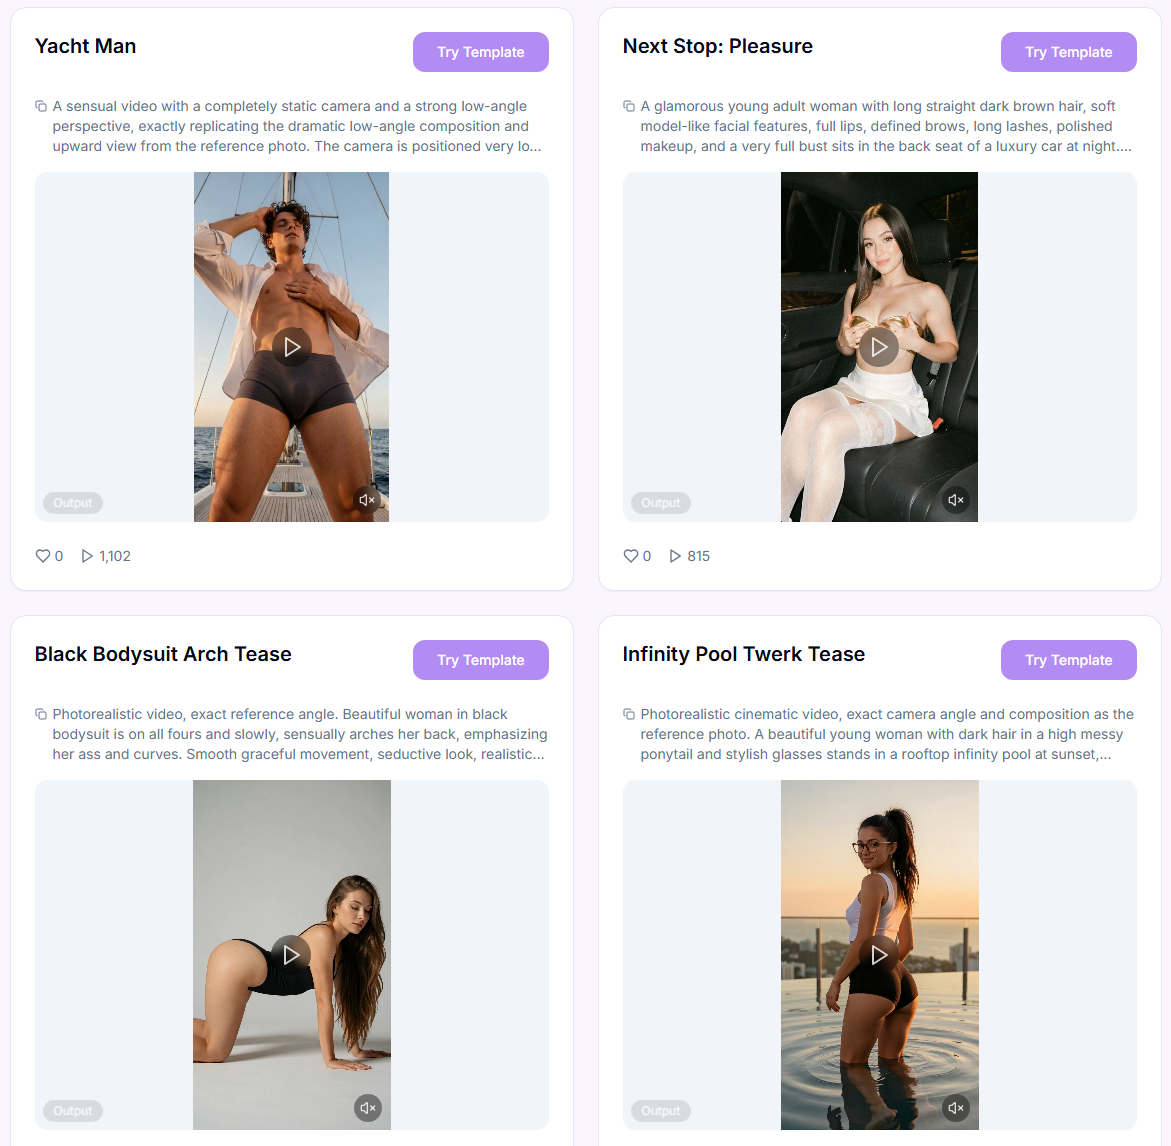
🎬 效果展示
看看僅憑提示詞,Text to Video 能生成怎樣的效果。
不想自己設定一切?
跳過設定,從 Templates 範本庫 中選擇一個現成風格,只需添加你的提示詞即可。
分步操作指南
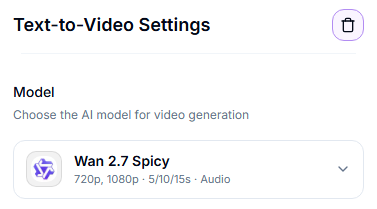
第 1 步:Model,從下拉列表中選擇生成影片的模型。點擊下方任意模型即可查看其擅長領域。
Wan 3.0 Spicy
Wan 3.0 Spicy
時長: 5、10、15、20、25,或30秒
解析度: 480p / 720p / 1080p
最適合: 單次生成最長30秒的多鏡頭長場景,可選由模型編寫的原生音訊。基於大規模標註 NSFW 內容資料集訓練。
優勢: 可透過 Generate Audio 開關自行編寫配樂;支援劃分為帶時間戳鏡頭的長劇本式提示詞;比早期 Wan 模型具有更強的多主體一致性和鏡頭控制力。
權衡: 最佳效果需要與時長匹配的提示詞:短提示詞配長時長會把情節和鏡頭選擇交給模型決定。沒有負面提示詞;不需要的元素必須明確描述。
內容說明: 過濾器:最低
Wan 3.0 Prime Spicy
Wan 3.0 Prime Spicy
時長: 5、10、15、20、25,或30秒
解析度: 480p / 720p / 1080p
最適合: 與 Wan 3.0 Spicy 相同的最長30秒多鏡頭長場景,可選由模型編寫的原生音訊,但返回速度約快 40%。
優勢: 與 Wan 3.0 Spicy 完全相同的輸出品質和功能組合(Generate Audio 開關、劇本式提示詞、多主體一致性);區別在於等待時間,這在測試想法或微調鏡頭時很重要。
權衡: 對於相同結果,每秒成本高於 Wan 3.0 Spicy;對提示詞長度的敏感度相同,同樣沒有負面提示詞。
內容說明: 過濾器:最低
Wan 2.7 Spicy
Wan 2.7 Spicy
時長: 5秒、10秒或15秒
解析度: 最高 1080p
最適合: 支援同步音訊生成。基於大規模標註的 NSFW 內容資料集訓練。
優勢: 與影片同步生成音訊、更優的時序一致性、更好的提示詞理解能力、更出色的動作品質。
權衡: 比更快的模型慢;最佳效果需要清晰、精確的提示詞。
內容說明: 過濾級別:最低
Seedance 2.0 Uncensored
Seedance 2.0 Uncensored
時長: 5秒、6秒、8秒、10秒、12秒、15秒
解析度: 480p / 720p
最適合: 從零開始生成帶同步音訊的影片:從簡短的「氛圍」片段到包含多個鏡頭的電影感故事板。基於大規模標註的 NSFW 內容資料集訓練。
優勢: 與影片同步生成音訊、嚴格遵循提示詞公式(Subject → Action → Environment → Camera → Lighting → Style → Constraints)、在帶時間碼的多鏡頭場景中表現穩定、支援廣泛的長寬比(16:9、9:16、1:1、4:3、3:4、21:9 或自動)。
權衡: 紋理和面部細節不會自動出現,需使用「ultra-sharp detail」或「crisp texture」等具體詞語。將過長、自相矛盾的提示詞拆分為多個獨立提示詞。速度比 Seedance 2.0 Fast Spicy 慢。
內容說明: 過濾級別:最低
Seedance 2.0 Fast Spicy
Seedance 2.0 Fast Spicy
時長: 5秒、6秒、8秒、10秒、12秒、15秒
解析度: 480p / 720p
最適合: 在速度至關重要時,從文字描述快速生成帶同步音訊的影片,從簡單的「氛圍」片段到帶時間碼的多鏡頭腳本。基於大規模標註的 NSFW 內容資料集訓練。
優勢: 與影片同步生成音訊、完全遵循提示詞公式(Subject → Action → Environment → Camera → Lighting → Style → Constraints)、支援廣泛的長寬比、在多鏡頭場景和時間碼下表現穩定。比 Seedance 2.0 Uncensored 更快、更便宜。
權衡: 若需要高解析度下的精細紋理和面部特徵,請加入「ultra-sharp detail」和「crisp texture」等具體詞語。拆分過長、矛盾的提示詞。品質低於 Seedance 2.0 Uncensored。
內容說明: 過濾級別:最低
Seedance 2.5 Uncensored
Seedance 2.5 Uncensored
時長: 5、10、15、20 或 30 秒
解析度: 480p / 720p / 1080p
最適合: 單次生成最長30秒的多鏡頭長場景:完全根據你的提示詞講述完整的故事,而不是拉長單一瞬間。基於大規模標註的 NSFW 內容資料集訓練。
優勢: 畫面更自然、更少「AI感」:鏡頭轉場、主體穩定性、光線以及皮膚和眼睛細節均有提升;帶時間戳的提示詞(「0–5s: …, 6–10s: …」)可控制何時發生什麼;可透過 Generate Audio 開關生成可選原生音訊。
權衡: 最貴的 Seedance 模型:1080p 的價格約為 720p 的 3.4 倍,建議先用 480p/720p 測試。不支援負面提示詞。即使開啟 Generate Audio,影片也可能沒有音訊。
內容說明: 過濾級別:最低
Wan 2.2 Spicy
Wan 2.2 Spicy
時長: 5秒或8秒
解析度: 最高 720p
最適合: 最便宜的選項:不生成音訊,但基於大規模標註的 NSFW 內容資料集訓練。
優勢: 細節衝擊力強、對提示詞的遵循度高,擅長表現戲劇性的鏡頭運動和氛圍感調色。每次生成成本最低。
權衡: 過濾較為寬鬆,意味著你需要保持提示詞精確;若追求極端效果,解剖結構和細節可能出現偏差。
內容說明: 過濾級別:最低
MiniMax H3 Max
MiniMax H3 Max
時長: 5秒、6秒、8秒、10秒、12秒,或15秒
解析度: 480p / 720p / 1080p
最適合: 直接根據文字描述生成片段,內建原生音訊,無需參考圖片。
優勢: 直接從文字提示詞獲得一致的動作和構圖;每個片段都會自動獲得原生立體聲音軌;支援 16:9、9:16、4:3、3:4、1:1、21:9,或自適應長寬比。
權衡: 這裡沒有 Start/End Frame,也沒有 Reference Mode。如需這些功能,請改用 Image to Video。沒有負面提示詞;需將排除項寫在主提示詞末尾。音訊無法關閉。長提示詞會在內部被壓縮,因此簡潔精確的文字通常效果更好。
內容說明: 過濾器:開啟。僅限 SFW,不支援 NSFW 內容。
MiniMax H3 Max Turbo
MiniMax H3 Max Turbo
時長: 5秒、6秒、8秒、10秒、12秒,或15秒
解析度: 480p / 720p / 1080p
最適合: 在不需要全價模型時,快速、低成本地生成文字轉影片片段。
優勢: 價格約為 MiniMax H3 Max 的一半,速度更快;相同的時長和解析度選項;自動包含原生音訊。
權衡: 與 MiniMax H3 Max 在此處的限制相同:沒有 Start/End Frame,沒有 Reference Mode,沒有負面提示詞,音訊無法關閉。
內容說明: 過濾器:開啟。僅限 SFW,不支援 NSFW 內容。
快速選擇:
需要最長的單次片段(最多30秒),搭配可選原生音訊和多鏡頭腳本? → Wan 3.0 Spicy。
需要同樣的結果但更快,即使每秒成本更高也可以? → Wan 3.0 Prime Spicy。
需要單次生成完整的30秒故事,最高1080p並帶原生音訊? → Seedance 2.5 Uncensored。
需要具有戲劇性鏡頭運動和氛圍感電影調色的高細節 NSFW 內容嗎? → Wan 2.2 Spicy.
需要最佳的動作品質和時序一致性嗎? → Wan 2.7 Spicy.
需要帶時間碼、支援廣泛長寬比的精確、結構化多鏡頭故事板嗎? → Seedance 2.0 Uncensored (或選擇 Fast Spicy 以獲得更快、更便宜的草稿)。
需要與影片同步生成的音訊嗎? → Wan 2.7 Spicy, Seedance 2.0 Uncensored, 或 Seedance 2.0 Fast Spicy。Wan 2.2 Spicy 不生成音訊,但它是最便宜的選項。
需要僅根據文字提示詞生成、帶原生音訊的 SFW 片段嗎? → MiniMax H3 Max(或選擇更快、更便宜的 MiniMax H3 Max Turbo)。
第 2 步:Prompt,描述你想生成的影片。保持專注:主體 + 動作 + 場景。字元上限取決於模型:Wan 2.2 為 800 字元,Wan 3.0(包括 Prime)和 Seedance 2.5 為 20,000 字元,其他模型為 5,000 字元;所選模型的上限會顯示在欄位下方的計數器中。不知道怎麼寫?點擊欄位下方的「» AI Prompt Assistant」按鈕,將你的想法轉換為格式正確的提示詞。
第 3 步:Aspect Ratio,選擇所需的長寬比(例如 1:1、3:4、9:16)。這決定了輸出的長寬比例。
第 4 步:Resolution,選擇所需的解析度。
第 5 步:Duration,選擇所需的影片時長:Wan 2.2 Spicy 為 5–8 秒,Wan 2.7 Spicy 和 Seedance 2.0 系列模型為 5–15 秒,Wan 3.0 Spicy 和 Seedance 2.5 Uncensored 為 5–30 秒(具體選項因模型略有不同)。
第 6 步:Start Generation,開始生成。查看結果,然後下載或發送到其他工具。
處理生成結果
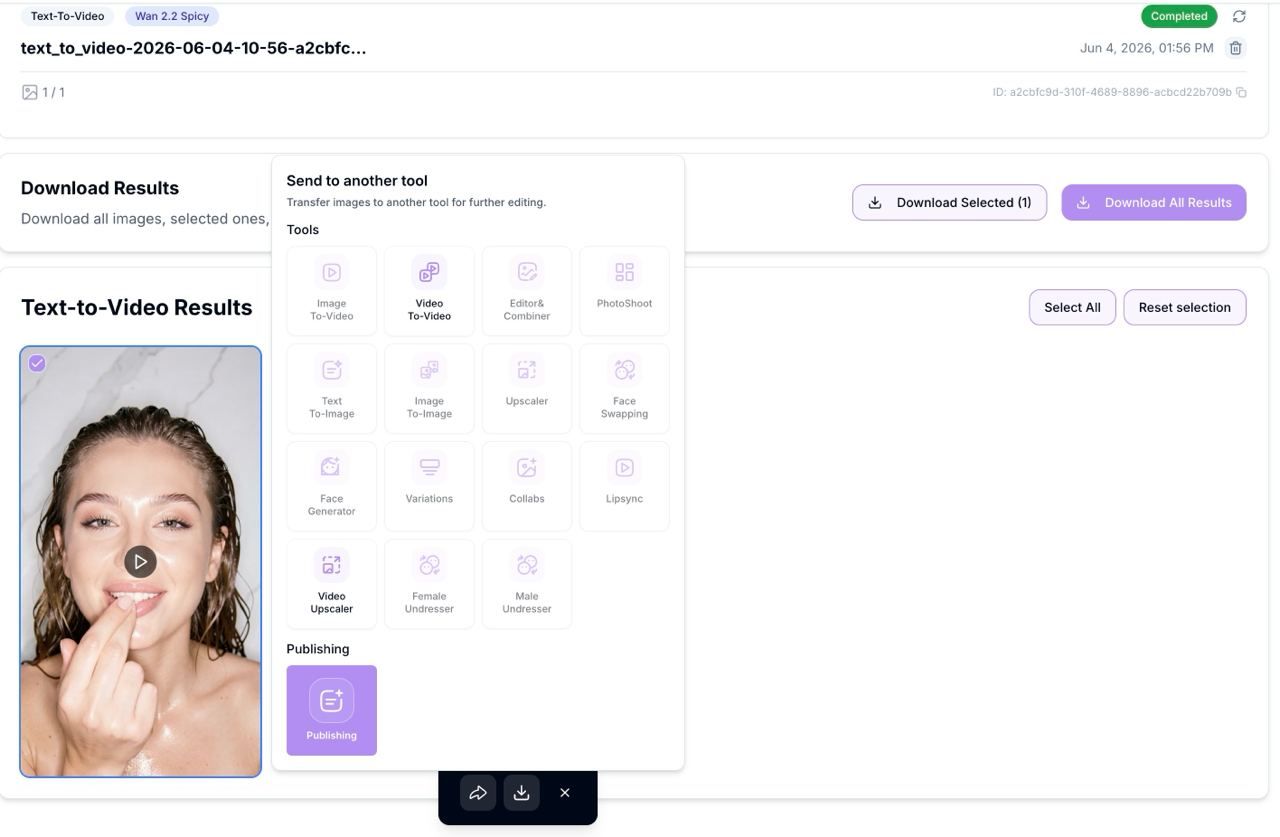
使用縮圖上的核取方塊進行選擇/取消選擇。
下載已選內容。
發送到其他工具以繼續處理流程(Video Upscaler、Video to Video)。
如果有畫面渲染失敗,Retry Failed 會自動出現。
影片提示詞技巧
專注於動作和鏡頭:「gentle parallax, slow dolly-in, subtle hair flutter, cloth ripple, soft depth-of-field」。
每個片段保持一個想法。如果需要多個動作,請分別渲染獨立版本(更快、更乾淨)。
為保持身份一致性,請在提示詞中描述關鍵的面部/髮型特徵,並在整批生成中使用相同的模型/時長。
最佳實踐與專業提示
先從 5 秒的片段開始,這樣確定提示詞、風格、光線和動作更快也更便宜。只有在畫面確認後,再切換到 8 秒(Wan 2.2)、10–15 秒(Wan 2.7)或最長 30 秒(Wan 3.0 Spicy、Seedance 2.5 Uncensored)的片段。
盡可能使用精確、結構化的提示詞。在過濾最少的情況下,模糊的措辭難以很好地處理複雜姿勢和解剖結構。
在沒有參考圖片的情況下,請在提示詞開頭描述角色的外觀:年齡、體型、面部特徵、髮型、服裝、光線和氛圍。描述越詳細,結果就越一致、品質越高。
已知限制(及應對方法)
你使用的是 AI 工具,偶爾出現錯誤、瑕疵或意外結果屬於正常現象,無法保證 100% 準確的結果。
解剖結構和精細細節可能出現偏差,請使用簡單的姿勢和清晰的提示詞。
結果可能存在差異,請生成多個版本並挑選最佳的一個。
如果結果不符合預期,請透過應用程式內的客服聊天與我們聯繫,或發送郵件至 [email protected]。
常見問題
哪個模型更好:Wan 2.2、Wan 2.7 還是 Wan 3.0?
哪個模型更好:Wan 2.2、Wan 2.7 還是 Wan 3.0?
Wan 2.2 最便宜、最快,但沒有音訊。Wan 2.7 是大多數短片段(5–15 秒)的最佳全能選擇,動作品質更好,音訊始終與影片一同生成(沒有開關)。Wan 3.0 Spicy 適合最長 30 秒的長場景或多鏡頭場景。
這些模型可以用於 NSFW 內容嗎?
這些模型可以用於 NSFW 內容嗎?
可以。上方的 Wan 和 Seedance 模型以最低安全過濾級別運行,非常適合 NSFW 內容。在複雜場景中,Wan 2.7 通常能生成品質更高的結果。MiniMax H3 Max 和 MiniMax H3 Max Turbo 以過濾器開啟狀態運行,僅限 SFW。
為什麼 Text to Video 的品質低於基於參考圖的生成?
為什麼 Text to Video 的品質低於基於參考圖的生成?
在沒有起始圖片的情況下,模型完全依賴文字描述。因此,在提示詞開頭非常詳細地描述角色的外觀、光線和風格非常重要。
如何解決解剖結構問題和瑕疵?
如何解決解剖結構問題和瑕疵?
使用簡單的姿勢,避免過度的鏡頭運動,並生成多個版本。較小的瑕疵在後期製作中更容易修正。
完整模型課程
想深入了解特定模型的提示詞寫法嗎?每個模型在 ZenCreator 內都有自己的深入課程:
接下來
Video Upscaler:讓結果更清晰、放大結果
Video to Video:重新設計風格或繼續編輯你的片段
這是否有幫助?
仍需要協助嗎? 詢問團隊