Text to Image
プロンプトを書いて、すぐにアップスケール、顔交換、または公開できるバッチを生成しましょう。
最終更新日 1日前
このツールでできること
Text to Imageはテキストから直接画像を作成します。被写体、設定、照明、構図、スタイルをコントロールできます。必要なスタイルとコンテンツ制限に合わせてモデルを選びます。結果は商用ライセンスされ、あらゆるZenCreatorツールに送信できます。
🎬 結果例
プロンプトだけからText to Imageが何を生み出せるかをご覧ください。
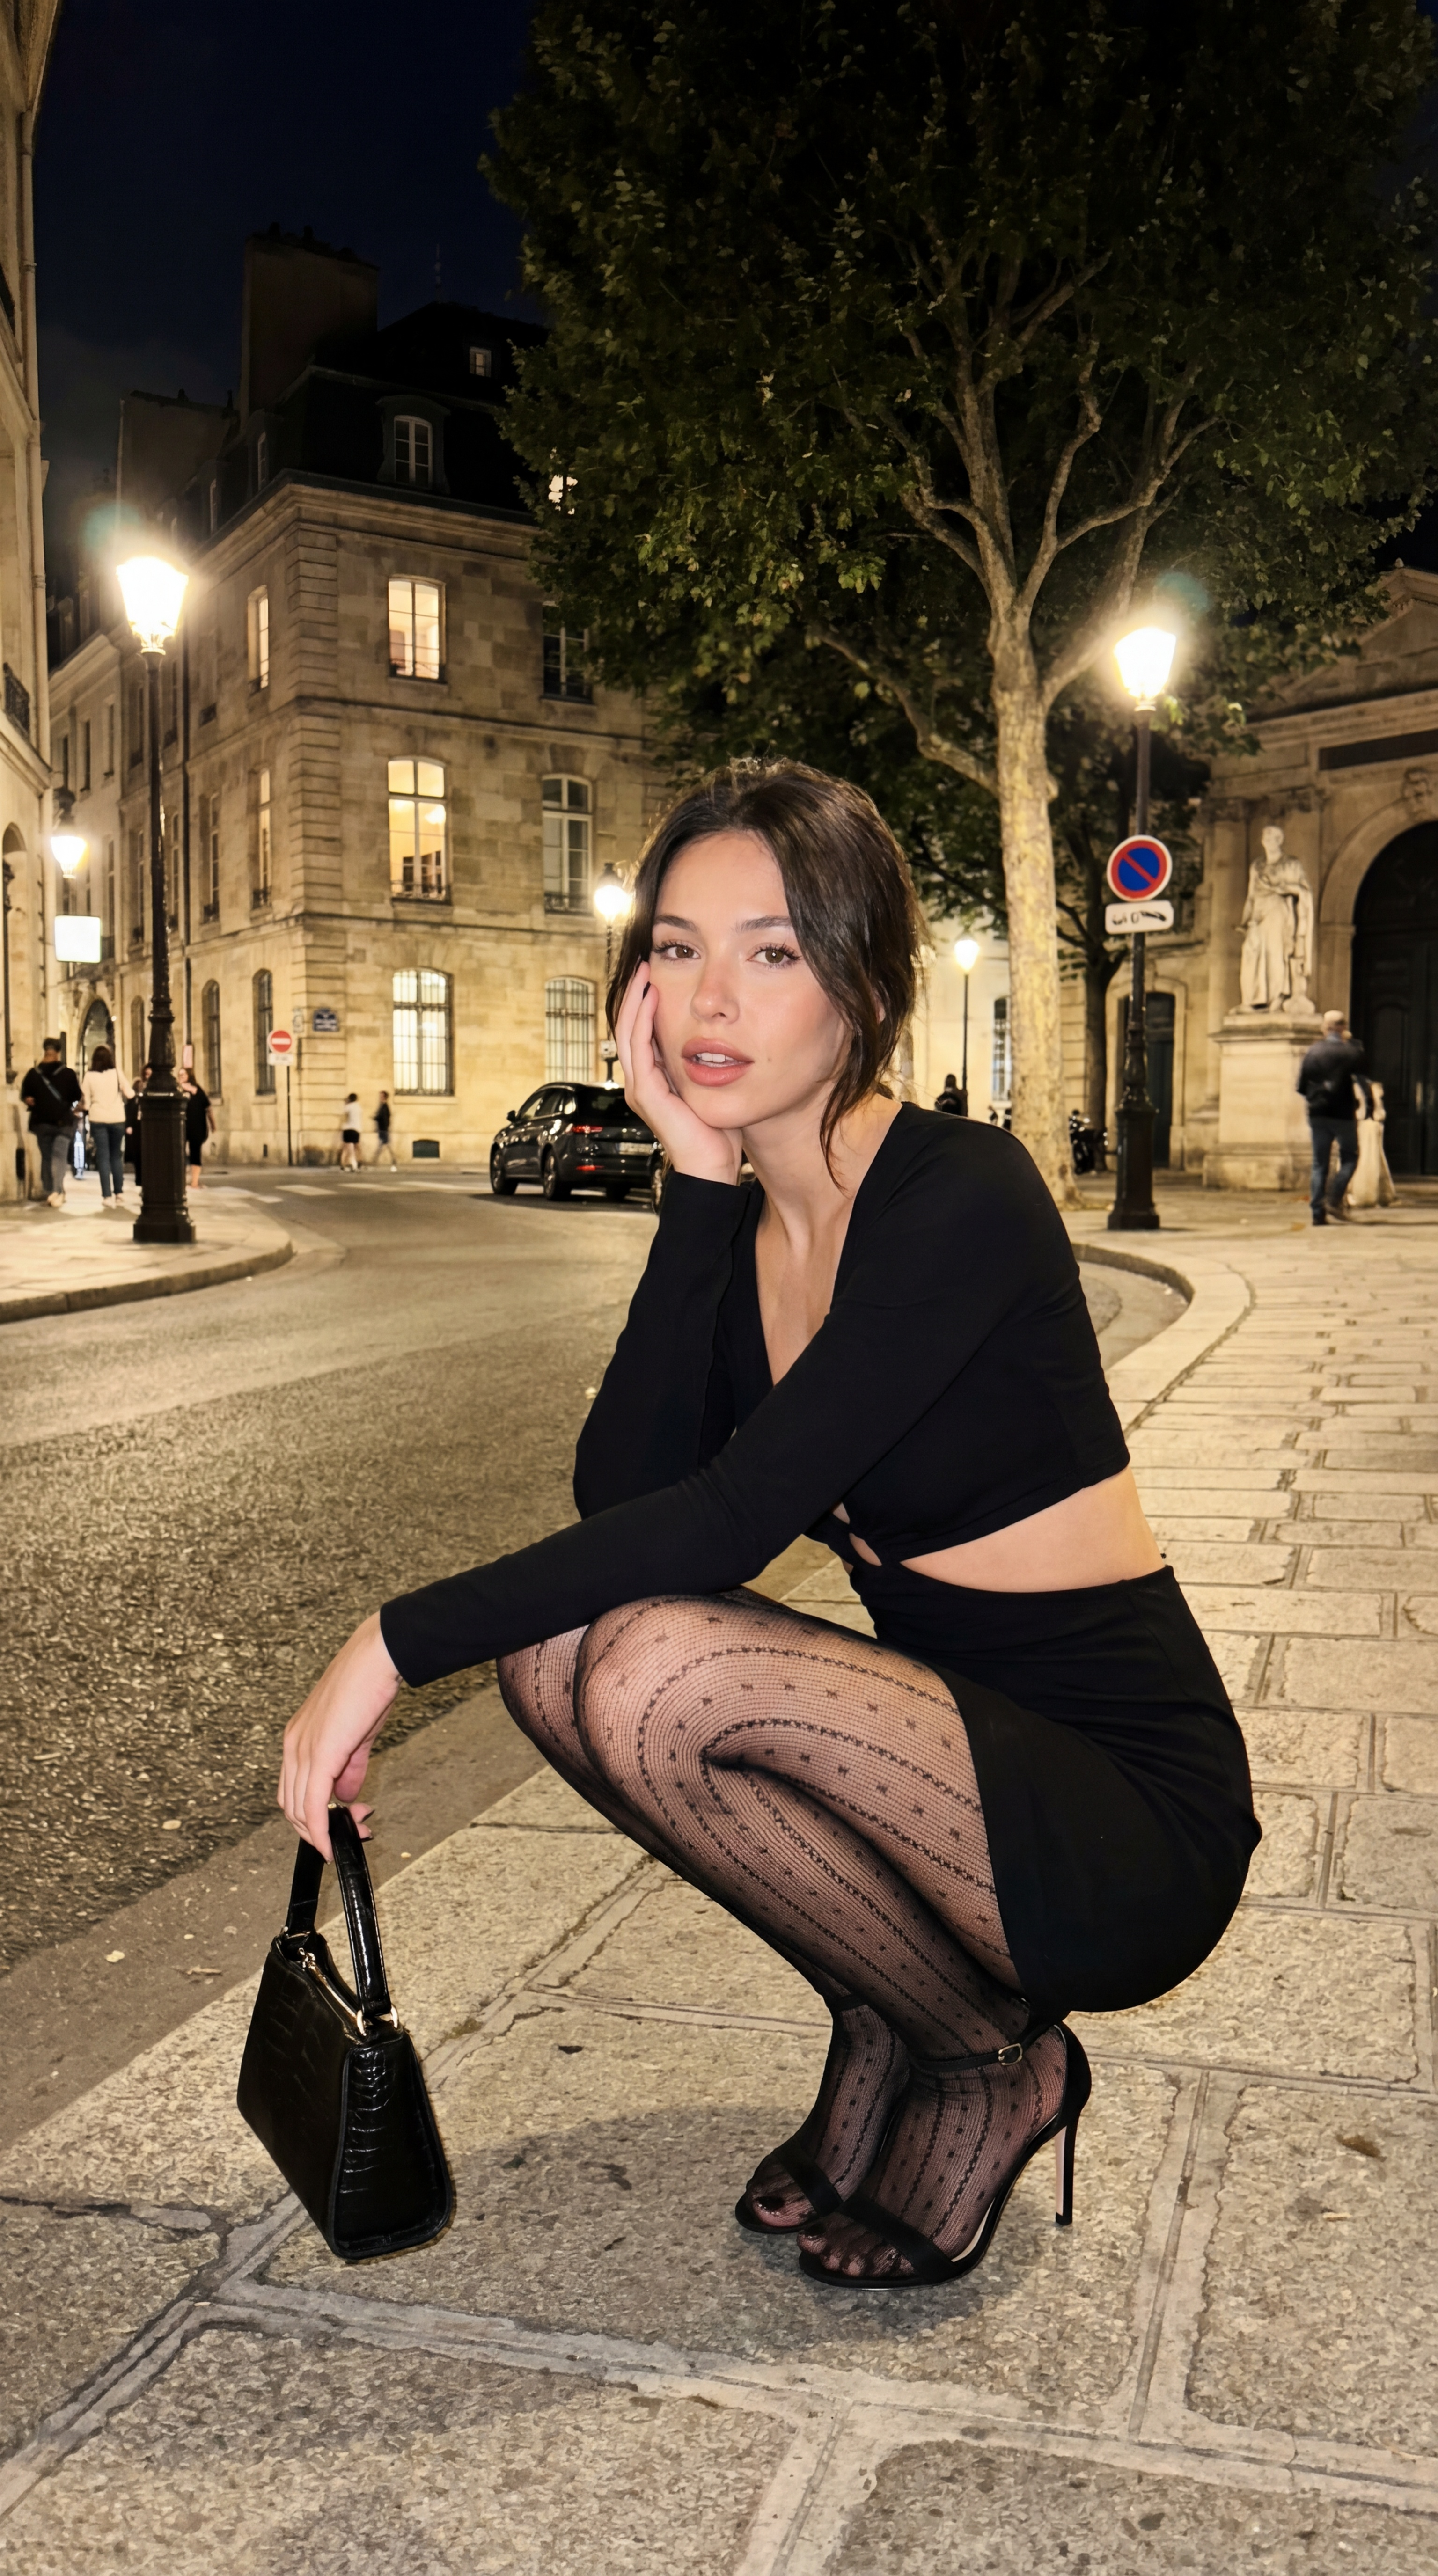
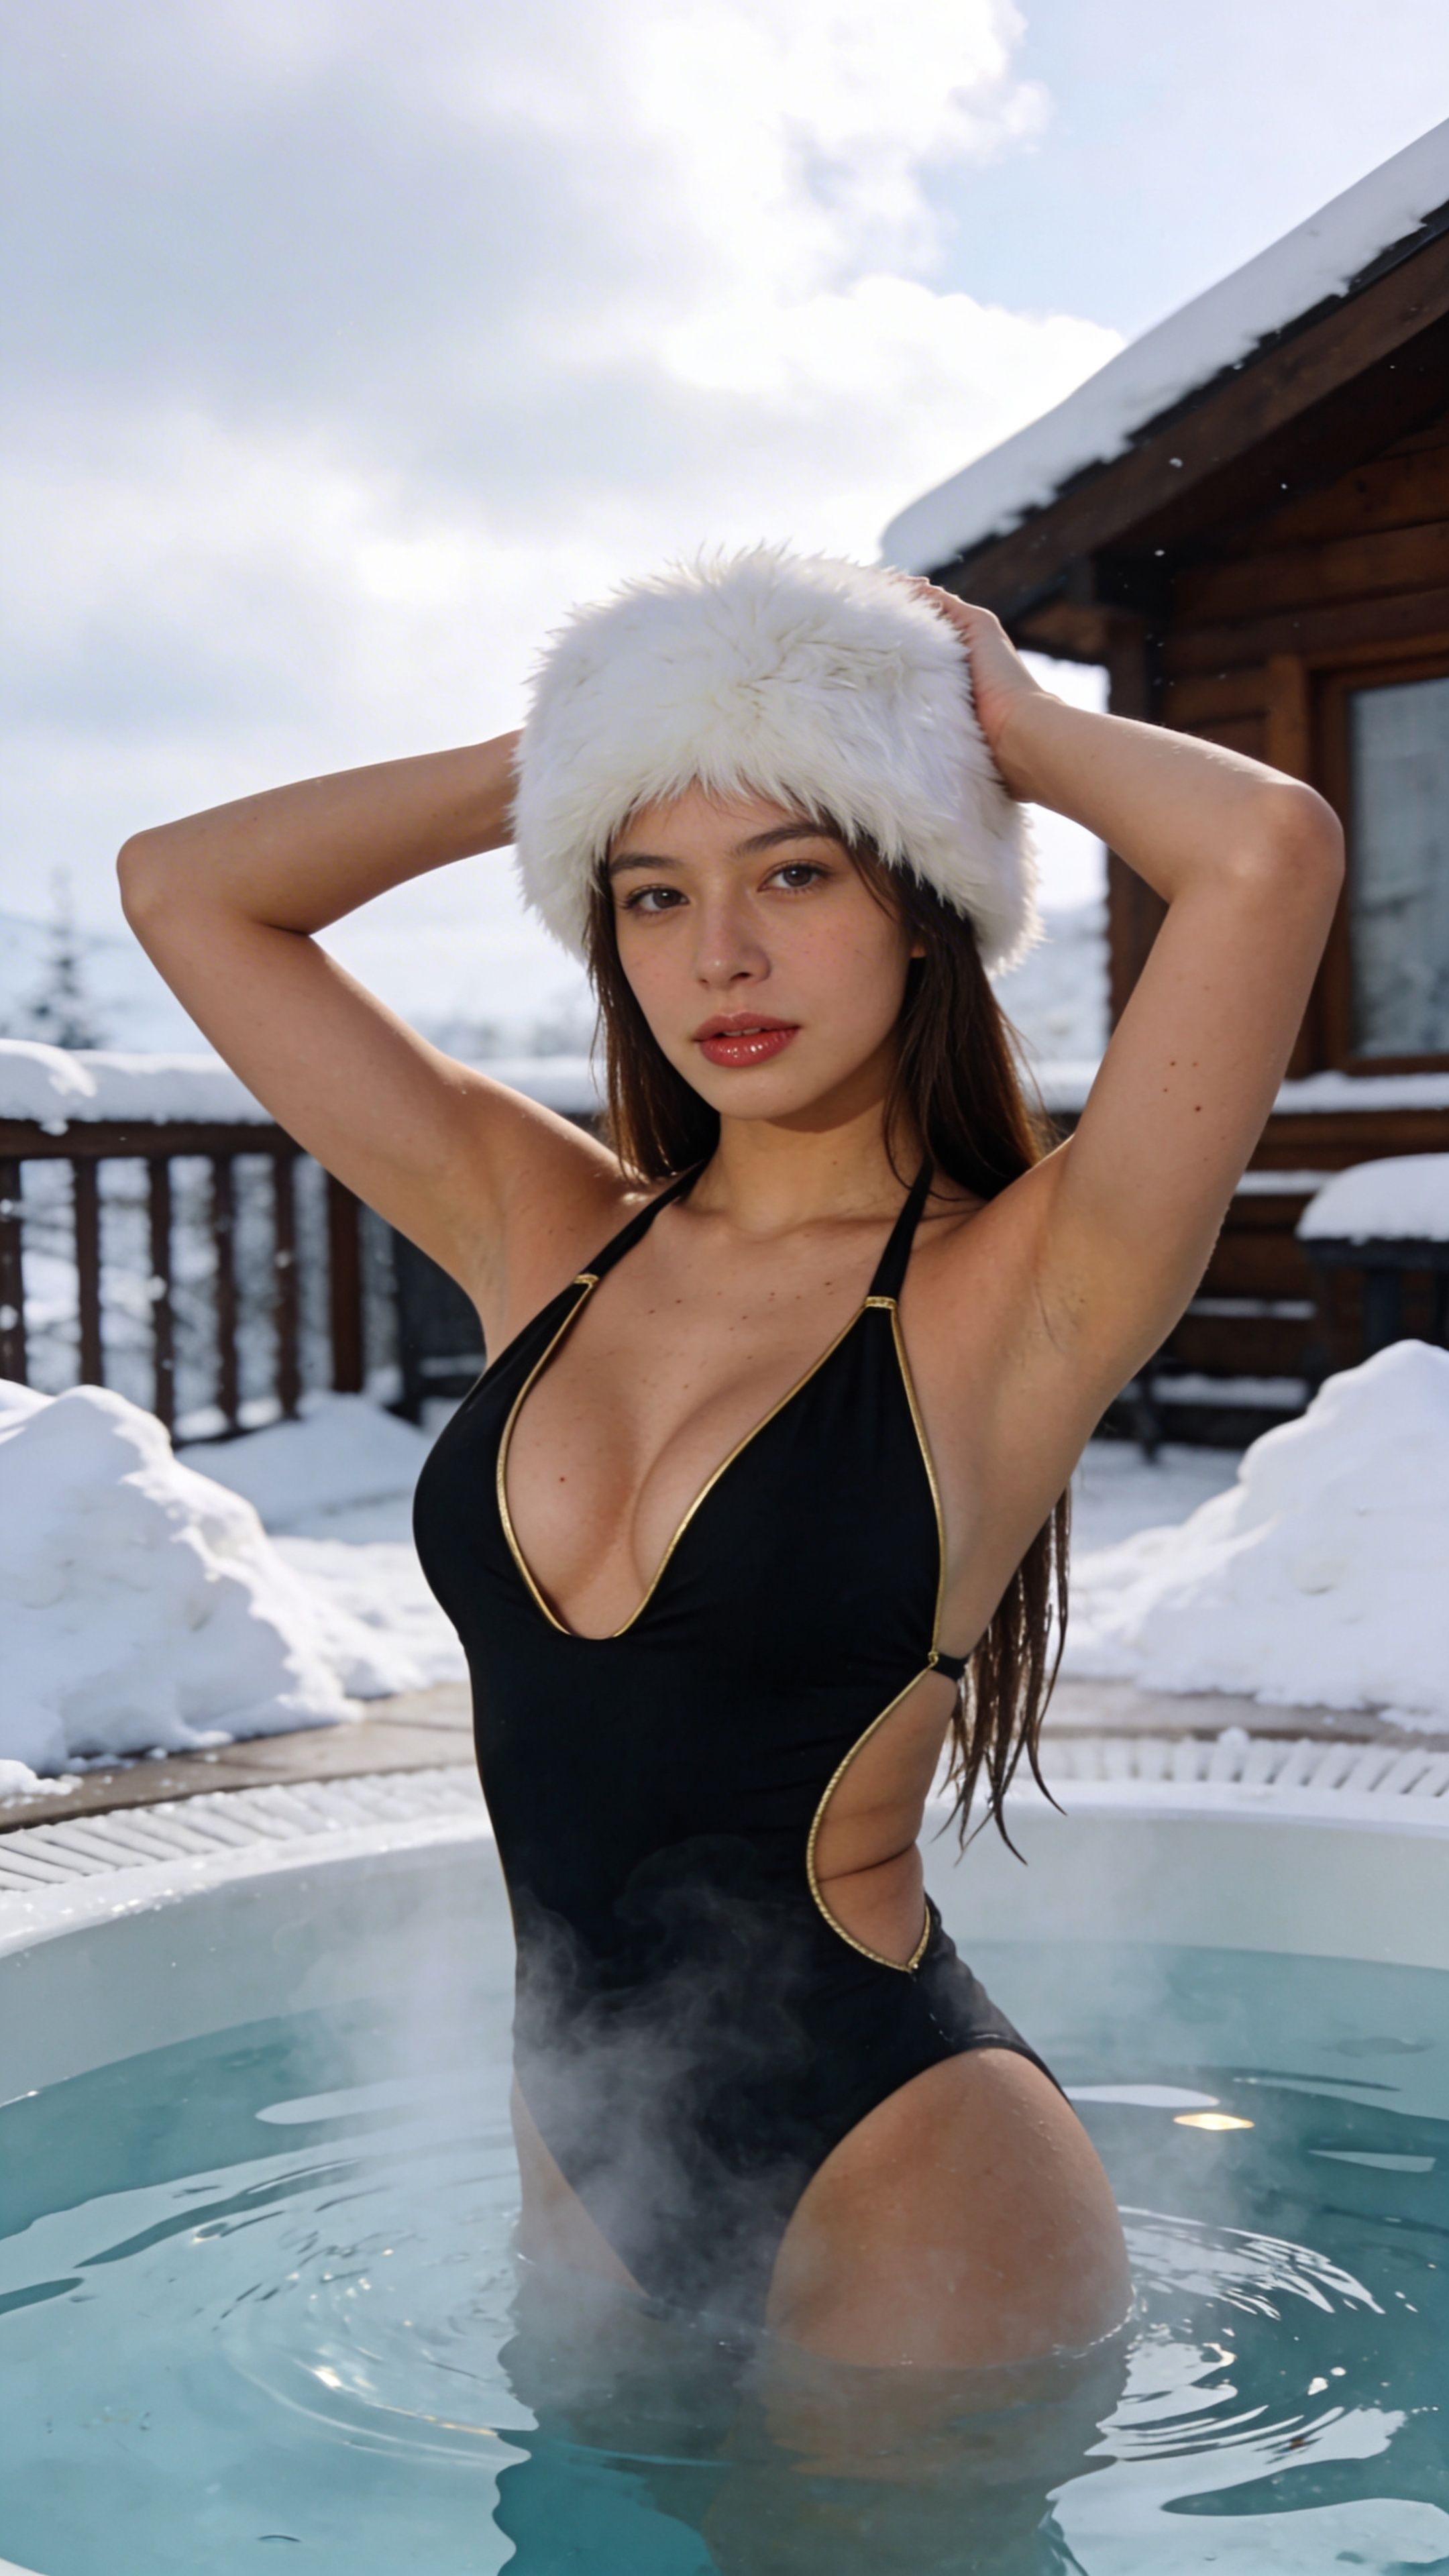
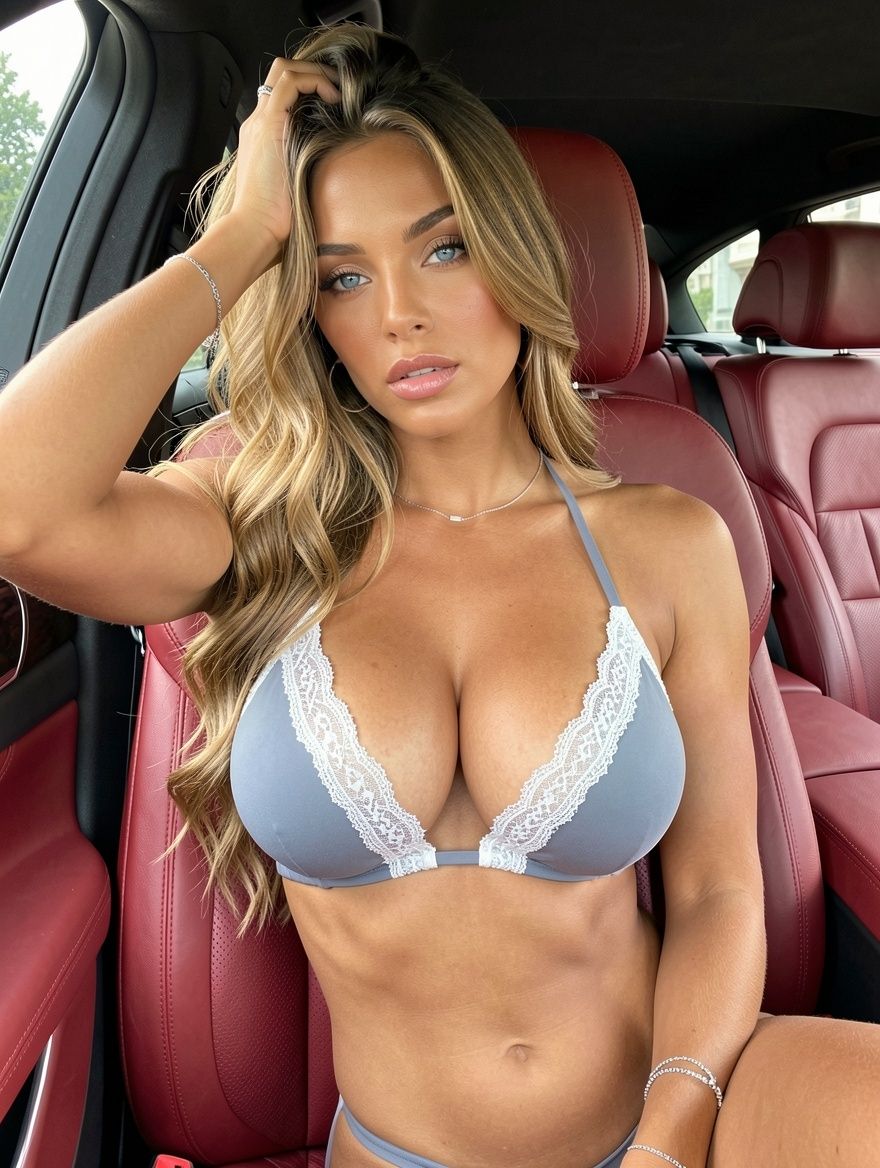
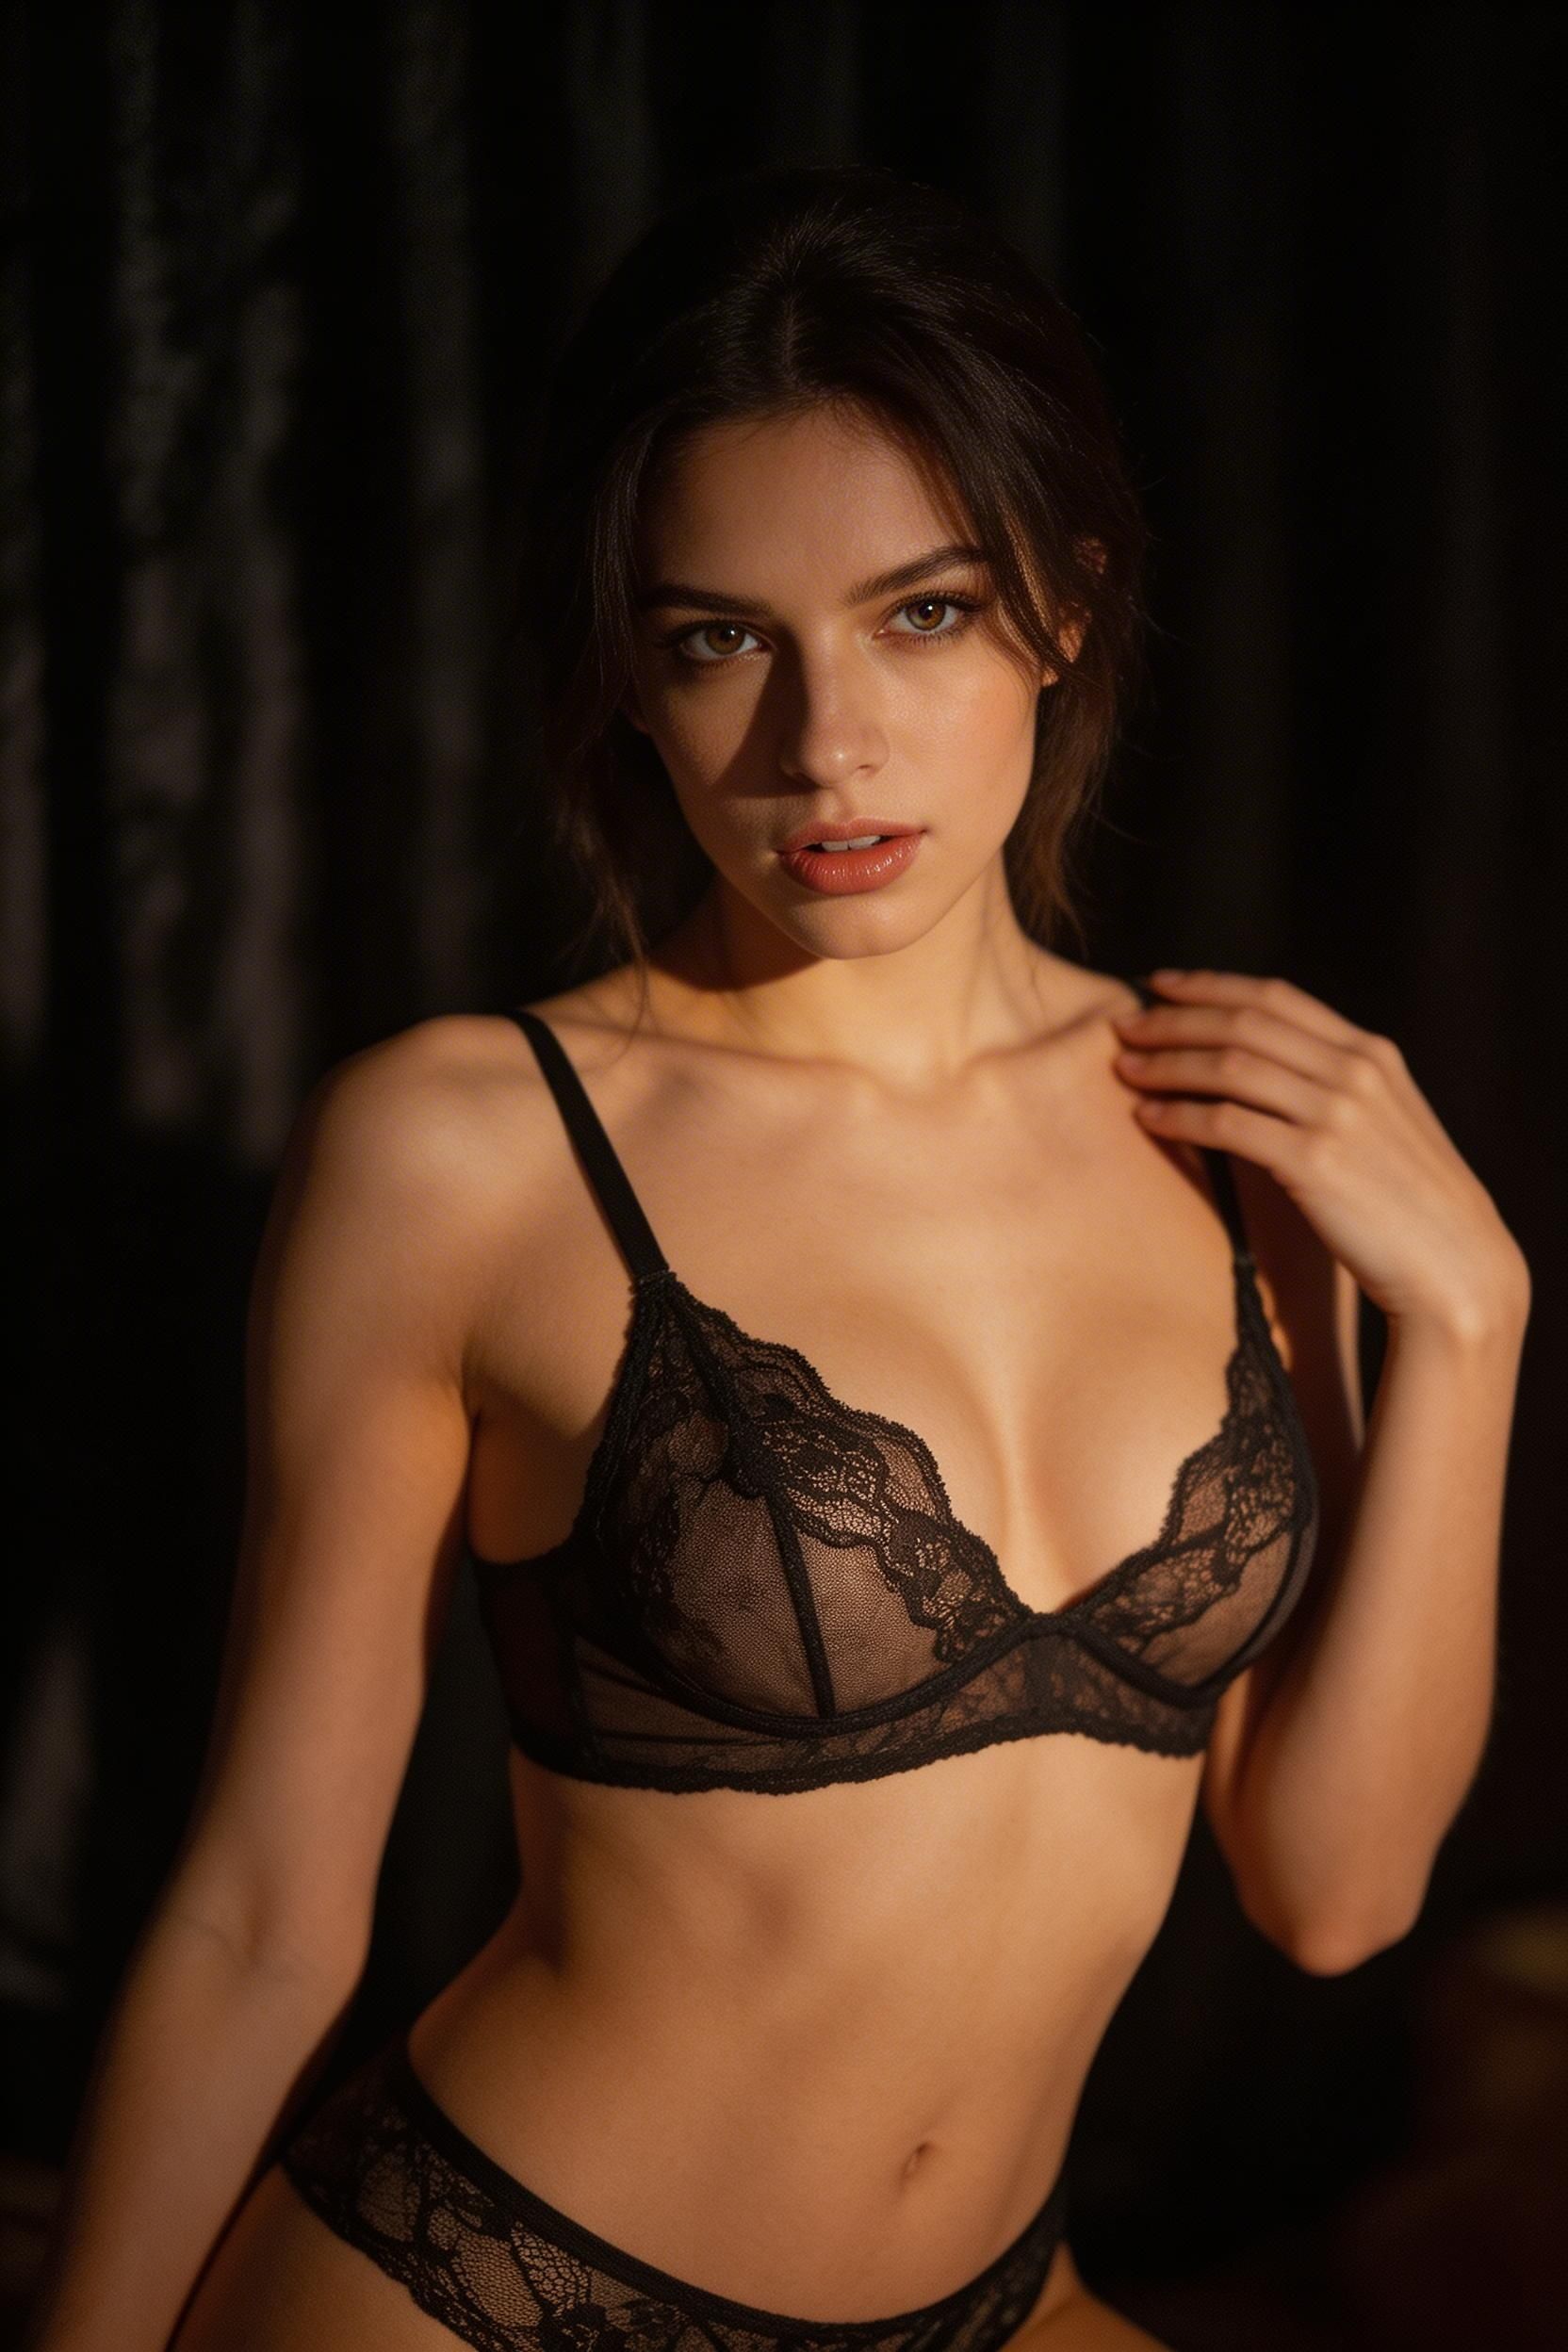
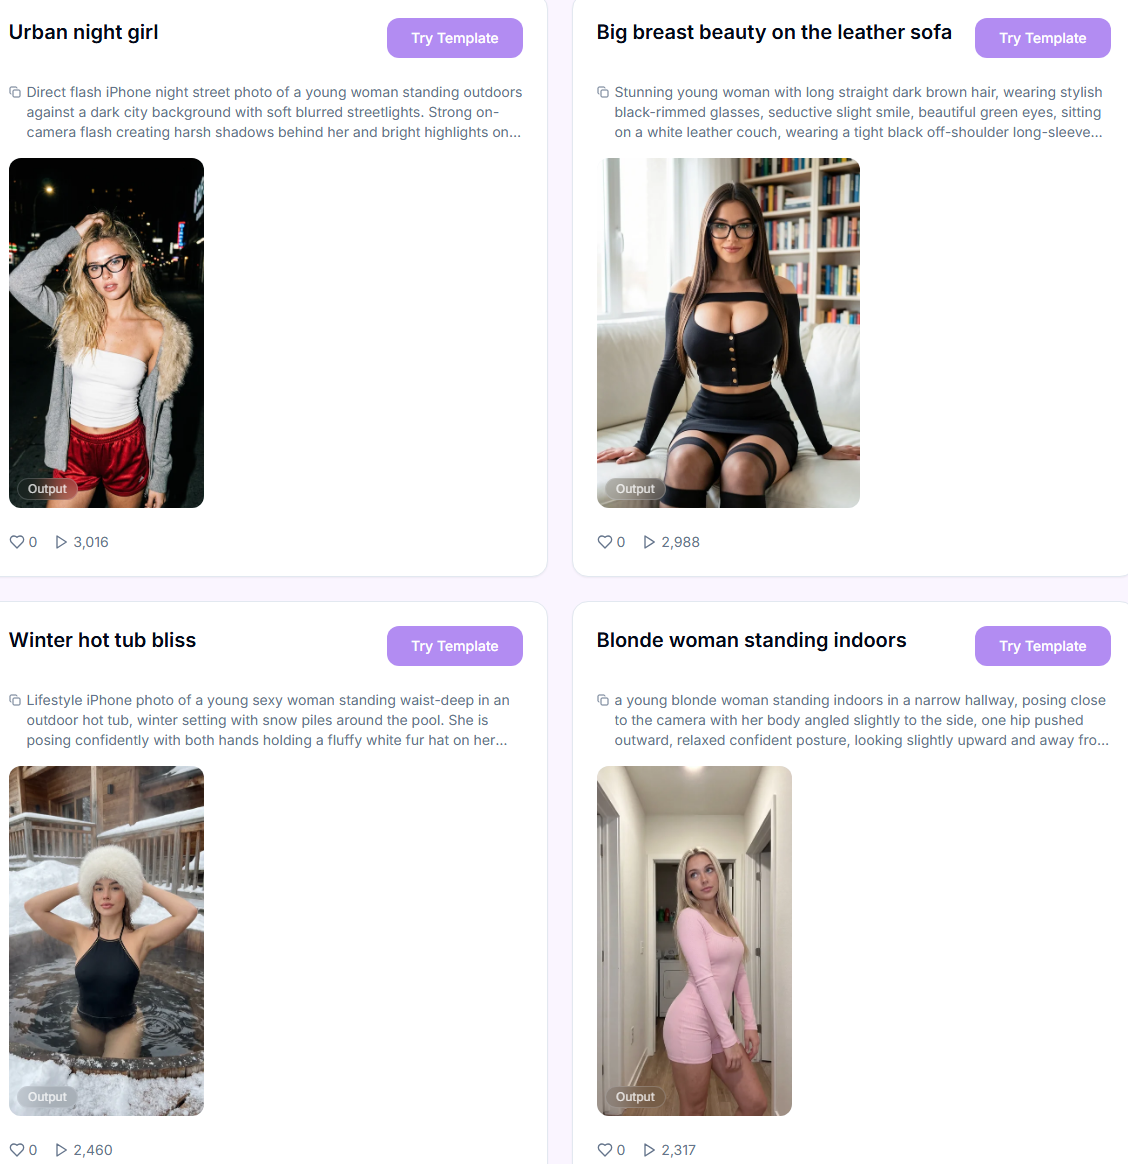
すべて自分で設定したくないですか?
設定は不要です。Templatesライブラリから既製のスタイルを選び、プロンプトを追加するだけです。
手順ガイド
ステップ1. Model:ドロップダウンリストから画像生成モデルを選びます。以下のいずれかをタップすると、それぞれの得意分野を確認できます。
WAN 2.7 Image
WAN 2.7 Image
概要
より柔軟で表現力豊かな生成のために設計された次世代WANモデル。
主なポイント
幅広いプロンプトとシナリオにうまく適応します。
最小限の安全フィルターで動作します(SFWおよびNSFWコンテンツの両方に対応)。
より多様な出力を伴う一貫した結果を提供します。
多様で制約の少ない生成に適しています。
Seedream 5
Seedream 5
概要
インテリジェントな生成、制御可能な編集、改善された推論に焦点を当てた次世代AI画像モデル。
主なポイント
画像生成と論理的推論、指示の遵守を組み合わせます。
より複雑な構図と構造化されたプロンプトのために設計されています。
高品質な出力とより高度で制御された生成タスクに最適です。
Qwen Image
Qwen Image
概要
Qwenファミリーの汎用モデルで、構造化された予測可能な生成に焦点を当てています。
主なポイント
さまざまなプロンプトで安定した一貫性のある結果を生み出します。
最小限の安全フィルターで動作します(SFWおよびNSFWコンテンツの両方に対応)。
強力なプロンプトチューニングなしで幅広いスタイルに対応します。
日常的な画像生成に適しています。
Nano Banana 2
Nano Banana 2
概要
クリーンで商用の視覚素材に最適化された高品質SFWモデル。
主なポイント
最大2K解像度で画像を生成します。
安全フィルターが有効な状態で動作します(SFWコンテンツのみ対応)。
クリーンな解剖学的表現、安定した顔、洗練された見た目。
ファッション、ライフスタイル、ブランドコンテンツに最適です。
Seedream 5 Pro
Seedream 5 Pro
概要
最高のプロンプト理解とリアリズムのために構築された、最新のSeedreamフラッグシップ。
主なポイント
このツール内の他のどのモデルよりも多い、全15種類のアスペクト比に対応しています。
解像度ティア切り替え:1K(2クレジット)または2K(3クレジット)。
最小限の安全フィルターで動作します(SFWおよびNSFWコンテンツの両方に対応)。
最も忠実度が高く、最も制御された出力に最適です。
General
General
概要
最大限の出力品質のために最適化された汎用高解像度モデル。
主なポイント
ネイティブ4Kで画像を生成します。
最小限の安全フィルターで動作します(SFWおよびNSFWコンテンツの両方に対応)。
追加のチューニングなしでバランスの取れたリアリズム、解剖学的表現、照明。
最終的な公開準備完了の画像が欲しい時の最良の選択です。
Flux Klein Spicy
Flux Klein Spicy
概要
コンテンツ制限が少なく、柔軟なクリエイティブワークフローに対応した高速生成モデル。
主なポイント
迅速な反復作業のために構築された速度最適化アーキテクチャ。
最小限のフィルタリングにより、より柔軟なコンテンツ生成が可能です。
反復的なワークフローと迅速な実験に対応しています。
柔軟性が求められる高速生成に最適です。
Qwen Image Pro
Qwen Image Pro
概要
より洗練された出力品質を持つQwen Imageの強化版。
主なポイント
ベースモデルと比較して、よりクリーンで詳細な結果を生成します。
異なるプロンプト間で一貫した出力を維持します。
最小限の安全フィルターで動作します(SFWおよびNSFWコンテンツの両方に対応)。
最終画像により適しています。
WAN 2.7 Pro
WAN 2.7 Pro
概要
より高い詳細度とより表現力豊かな出力を持つ高度なWANモデル。
主なポイント
WAN 2.7 Imageと比較して、より詳細な結果を生成します。
複雑なシーンや構図をより上手く処理します。
最小限の安全フィルターで動作します(SFWおよびNSFWコンテンツの両方に対応)。
高品質な最終画像に推奨されます。
Krea 2
Krea 2
概要
常に当社の内蔵スタイルLoRAを適用する高速でフォトリアリスティックなモデルです。独自のLoRAを選ぶ必要はありません。
主なポイント
リアルなアダルトコンテンツ向けに専用のスタイルLoRAで学習されています。このLoRAは差し替えたり無効化することはできません。
2つの品質ティア:1K(1クレジット)または2K(2クレジット)。スタイルと構図は同じで、解像度と価格のみが異なります。
手動の幅/高さ、ネガティブプロンプト、LoRAの選択は反映されません。サイズはアスペクト比とティアのみで決まります。
Z-Image Spicy
Z-Image Spicy
概要
検閲のないフォトリアリスティックなモデルで、テキストから画像への生成専用です。参照画像には対応していません。
主なポイント
露骨な表現のコンテンツについて追加で学習されており、テキストのみからでもうまく描けます。
2つのモード:Standard(1クレジット、より高速)またはPro(2クレジット、細部がより精細)。
生成前にプロバイダーがプロンプトを自動的に書き換え、拡張します。そのため、長く詳細なプロンプトより、短く具体的なプロンプト(40〜120語、1段落)の方がうまくいく傾向があります。
手動の幅/高さ、ネガティブプロンプト、LoRAは反映されません。サイズはアスペクト比のみで決まります。
クイックピック:
最速で最も安価、アイデアをテストするだけ → Qwen Image。
特定のポーズや詳細なシーン、検閲なし → WAN 2.7 Image。
映画的、雑誌スタイルの色調 → Seedream 5(最もシャープなバージョンならPro、任意の解像度/比率)。
アニメーション化準備ができたクリーンなSFW写真 → Nano Banana 2。
キャラクターシリーズ全体で同じ顔、最高品質 → General。
リアルなヌード写真 → Flux Klein Spicy。
最もシャープで詳細なヌード(待つ価値あり) → Qwen Image Pro または WAN 2.7 Pro。
内蔵スタイルで手早くシャープでリアルな画像を得たい → Krea 2。
テキストのみから露骨な表現のコンテンツを、短く正確なプロンプトで → Z-Image Spicy。
ステップ2. Prompt:画像に表示したいものを説明します。被写体、服装、ポーズ、照明、カメラアングル、雰囲気、環境について具体的に記述しましょう。Magic Promptを使うと、短いアイデアを自動的に詳細なプロンプトに拡張できます。すべてのモデルで動作します。結果に満足できませんか?Revertをクリックして、入力した内容に戻しましょう。
ステップ3. Negative Prompt(任意):モデルが避けるべきものをリストアップします(不正確な解剖学的表現、余分な指、ぼやけ、透かし、テキスト、アーティファクト)。利用可能かどうかは選択したモデルによります。
ステップ4. Aspect Ratio:生成される画像の希望するアスペクト比を選びます(例:1:1、3:4、9:16)。これはすべての出力の縦横比を定義します。
ステップ5. Resize (W / H):出力解像度をピクセル単位で手動設定します。最大解像度は選択したモデルによって異なります(最大4K)。
ステップ6. Number of Images:この実行で生成するバリエーションの数を選びます(最大10)。
ステップ7. Start Generation:ジョブを開始します。生成開始前に合計クレジットコストがボタンの下に表示されます。
結果への操作
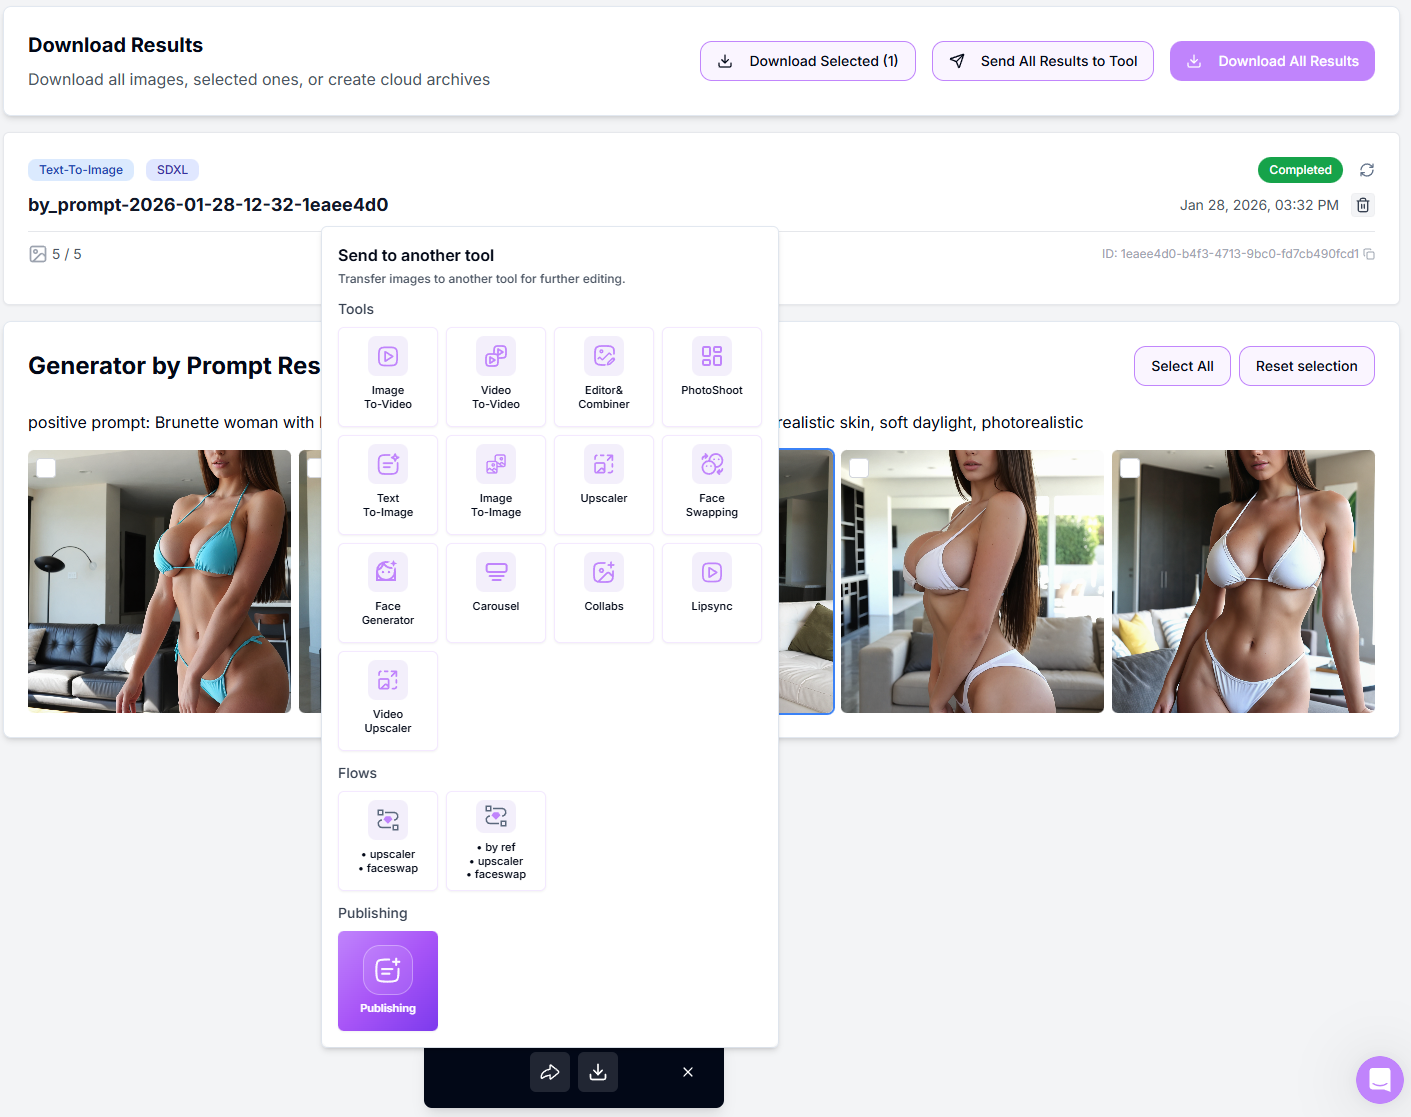
サムネイルのチェックボックスを使って選択/選択解除します。
Download Selected / Download AllでZIPをエクスポートします。
他のツール(Image Upscaler、Head & Face Swap、Reference-To-Image、Image to Video、Variations)に送ってパイプラインを続行します。
フレームのレンダリングに失敗した場合、Retry Failedが自動的に表示されます。
プロンプティングのコツ(コピペ用)
ポートレート: 「35mm portrait of [subject], half-body, eye contact, soft window light, shallow depth of field, natural skin, neutral color grade, realistic texture, high detail」。ネガティブ:「lowres, over-smooth skin, bad anatomy, extra fingers, watermark」
ライフスタイル: 「[subject] walking in [location], candid pose, golden hour backlight, film look, natural grain, realistic proportions, composition rule of thirds」。ネガティブ:「cartoonish, plastic skin, lens distortion, duplicate face」
ファッション: 「[subject] studio fashion shot, 3/4 pose, key light + rim, clean backdrop, editorial style, crisp shadows, high-end retouch look」。ネガティブ:「blown highlights, muddy blacks, JPEG artefacts」
完全なガイドはこちらをご覧ください:良いプロンプトの書き方。
プロのコツ
プロンプトは視覚的かつ簡潔に保ちましょう。モデルがどう動作すべきかではなく、あなたが見たいものを記述してください。
高解像度で結果がぼやけて見える場合は、選択した画像を最終ステップとして Image Upscaler に送りましょう。
顔のアイデンティティが十分に安定していない場合は、生成後に選択した画像を Head & Face Swap に送って顔を固定しましょう。
2〜4枚の画像から始めて見た目を承認し、その後本番実行のために画像数を増やしましょう。
極端なスタイルと強力なLoRAを1回の実行で混ぜるのは避けましょう。一貫性が急速に低下します。
トラブルシューティング
AIを使った処理のため、まれなミスやアーティファクトは正常であり、100%正確な結果は保証されません。
解剖学的表現や衣服の歪み → プロンプトを簡略化する、または別のモデルを試してください。
期待通りの結果が得られない場合は、アプリ内のサポートチャットにご連絡いただくか、[email protected]までメールでお問い合わせください。
よくある質問
どのモデルがよりリアルですか?
どのモデルがよりリアルですか?
SFWコンテンツの場合、Nano Banana 2が通常最もフォトリアリスティックな選択肢です。全体的な出力品質と最終画像が最も高いのはGeneralです。NSFWコンテンツにはGeneralを使用してください。
なぜアーティファクトが表示されるのですか?
なぜアーティファクトが表示されるのですか?
過剰なLoRA強度、または競合するLoRAが多すぎる場合です。強度を下げる、1つ削除する、またはプロンプトを簡略化してください。
プロンプトは英語で書く必要がありますか?
プロンプトは英語で書く必要がありますか?
プロンプトはさまざまな言語で書けますが、モデルは英語を最もよく理解します。他の言語のプロンプトでは結果の品質が保証されないため、プロンプトは英語で書くことをおすすめします。
非常に高解像度の画像を直接生成できますか?
非常に高解像度の画像を直接生成できますか?
はい、モデルによります。最高解像度の出力にはGeneral(4K)を使用してください。他のモデルでは、まず生成してから選択した画像をImage Upscalerに送ってください。
常にNegative Promptを使用すべきですか?
常にNegative Promptを使用すべきですか?
常にではありませんが、人物を生成する際には推奨されます。短いネガティブプロンプトは、解剖学的な問題、ぼやけ、不要なアーティファクトを減らすのに役立ちます。
次のステップ
Image Upscaler:結果をシャープにして拡大する
Head & Face Swap:一貫した顔を固定する
Reference-To-Image:この結果からバリエーションを作成する
Image to Video:最終画像をアニメーション化する
これが役に立ちましたか?
まだお困りですか? チームに質問