Seedance 2.0をマスターする
最終更新日 約7時間前
Seedance 2.0とは
Seedance 2.0はByteDanceの動画生成モデルで、現在ZenCreatorのText to Video、Image to Video、Video to Videoで利用可能です。音声を後付けの要素として扱うのではなく、動画と音声を一つのプロセスとして同時に生成する統合アーキテクチャに基づいています。
ほとんどの動画モデルが1枚の画像をアニメーション化するのに対し、Seedance 2.0はシーン全体を読み取ります。誰がフレーム内にいるか、何が起きているか、どこで、カメラがどう動くべきか、どんなスタイルかを理解した上で、一貫性のあるクリップを構築します。
何が違うのか
画像だけでなく、シーン全体を理解します。 被写体、アクション、環境、カメラがすべて組み合わさって一貫性のあるクリップになり、以前のモデルよりも動きが明らかに安定しています。
2つの生成モードに対応しています。 First/Last Frameをアップロードする標準モードでコントロールされた開始・終了を実現するか、Reference Modeに切り替えて最大9枚の画像と3つの音声クリップをスタイル、アイデンティティ、動きの入力として組み合わせられます。それぞれプロンプト内で名前を直接指定して参照できます。
音声と動画を同時に生成します。 別途リップシンクや音声のステップを経ることなく、音と動きが同期した状態で仕上がります。
既存の映像を精密に編集できます。 Video to Videoでは、元の動きやタイミングをそのままに、衣装、背景、照明を変更できます。
4種類の入力:それぞれの役割
これはSeedance 2.0を使う上で最も役立つ考え方です。各入力タイプにはそれぞれの役割があります。一つの入力に別の入力の仕事をさせようとしないでください。
テキストは空間的な要素をコントロールします:外見、雰囲気、スタイル、環境。
画像はアイデンティティをコントロールします:キャラクター、オブジェクト、シーンの正確な見た目。
動画は時間的な要素をコントロールします:タイミング、リズム、カメラの動き。実際には、この入力はVideo to Videoで使われ、編集対象のクリップ自体が動画リファレンスになります。
音声はリズムと音をコントロールします:テンポ、動きが音とどう同期するか。
基本ルール:見た目はテキストと画像で、動きや音はビデオと音声で。 複雑な動きを副詞の羅列(「素早く、滑らかに、突然」)で説明するより、単に動画リファレンスを添付してモデルにダイナミクスをコピーさせるほうがうまくいくことがほとんどです。
5つの生成方法
Text to Video:プロンプトのみ、ソース素材なし。最大限の自由度。
First Frame:1枚の画像が動画の文字どおりの開始フレームになります。
First + Last Frame:2枚の画像で開始と終了を保証し、その間の遷移をモデルが構築します。
Reference Mode:複数の画像や音声クリップをスタイル、アイデンティティ、動きのリファレンスとして使用します(文字どおりの最初のフレームではありません)。実際に添付できる内容はツールによって異なります。Image to Videoで具体的に何が使えるかは下記のインターフェースツアーをご覧ください。
Video to Video:既存のクリップを編集し、指定した部分だけを変更しながら他はすべて保持します。
よくある誤解: Reference Modeで1枚の画像をアップロードしても、それが最初のフレームになるわけではありません。モデルはそれをスタイル/アイデンティティのリファレンスとして扱い、実際の開始フレームはプロンプトのテキストから構築します。写真を文字どおりクリップの最初にしたい場合は、代わりにFirst Frameモードを使ってください。
プロンプトの公式
強力なSeedance 2.0のプロンプトはすべて同じ構造に従います。毎回すべてのブロックが必要なわけではありませんが、SubjectとActionは基盤です。これらがないとシーンがぶれてしまいます。
Subject:誰、または何がフレーム内にいるか
Action:動詞1つ、現在形、明確な動き1つ
Environment:場所、背景、雰囲気
Camera:ショットサイズ、動き、アングル
Lighting:光源と光の質
Style:映像的な言語:シネマティック、エディトリアルなど
Constraints:安定性と品質の要件
モデルは最初の20〜30語を最も重視します。SubjectとActionは冒頭に置いてください。
一貫して役立つ4つのルール:
1ショットにつき1つのアクション:「歩き、振り向き、微笑む」は3つのアクションであり、ぼやけた結果になります
現在形の動詞:「will roll」ではなく「rolls」「turns」「falls」
具体性は形容詞の羅列に勝ります
フレーム内にあるべきものを描写し、あってはならないものは描写しない(除外項目はConstraintsに)
リファレンスの組み合わせ:タグの構文
複数の画像や音声クリップをアップロードする際は、モデルがどれを指しているか分かるように、プロンプト内で直接タグ付けしてください。正確なタグ形式はツールによって異なります。プロンプト欄のプレースホルダーテキストに、そのツールの最新の構文が表示されるので、常に確認してください。
Image to Videoでは、リファレンスは次のようにタグ付けされます:
画像: [img1]、[img2]...(最大9枚、アップロード順に番号付け)
音声: [audio1]、[audio2]、[audio3](最大3つ)
例:「[img1]の女性が鏡に近づく。彼女のポーズは[img2]を参照している。」 ここでは[img1]が彼女が誰であるかを定義し、[img2]が彼女のポーズを定義します。テキストがそれらを一つのシーンにまとめます。
インターフェースツアー:Image to VideoでのSeedance 2.0 Spicy
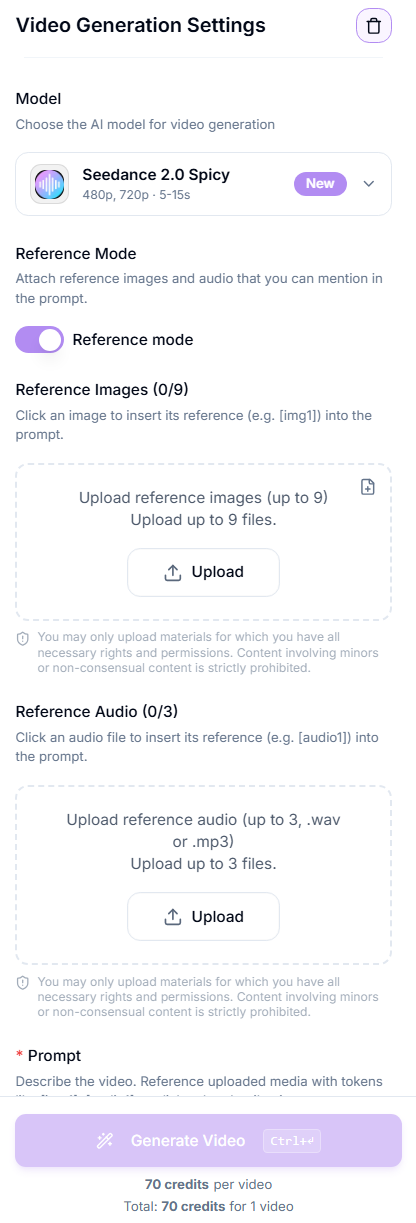
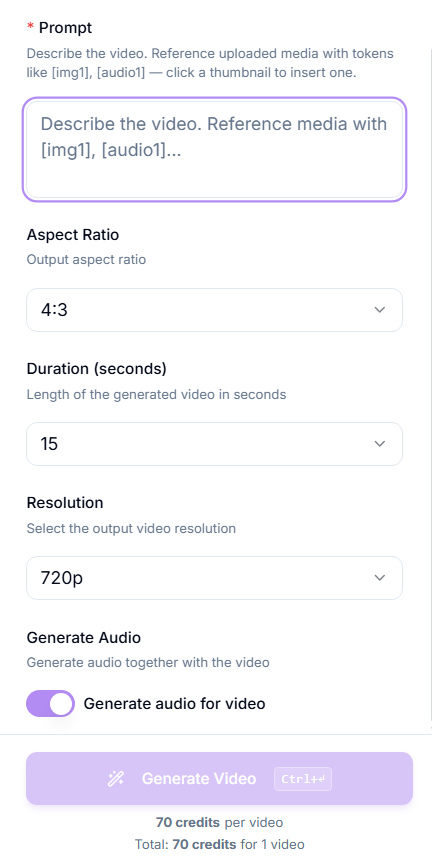
ここでは、Image to Video内でSeedance 2.0 Spicyを使って実際に生成する様子を、画面に表示される設定の順番どおりに、手順ごとに説明します。
Model。 Seedance 2.0 Spicyが選択されています。このツール向けのSeedance 2.0のNSFW対応バージョンです(480p/720p、5〜15秒)。
Reference Modeトグル。 プロンプト内で言及できるリファレンス画像や音声を添付する場合はオンにします。1枚の画像を文字どおりの最初のフレームとして使う場合はオフのままにします。
Reference Images(0/9)。 最大9枚の画像をアップロードします。アップロード済みのサムネイルをクリックすると、そのタグ(例:[img1])が自動的にプロンプトに挿入されます。
Reference Audio(0/3)。 最大3つの音声ファイル(.wavまたは.mp3)をアップロードします。ファイルをクリックすると、そのタグ(例:[audio1])がプロンプトに挿入されます。
Prompt。 上記の7ブロックの公式を使って動画を説明します。挿入したトークンでアップロードしたメディアを参照してください。例:「[img1] turns toward the camera, [audio1] plays as she speaks.」
Aspect Ratio。 出力のアスペクト比を設定します(例:4:3)。
Duration(seconds)。 5、6、8、10、12、15秒から選択します。
Resolution。 480pまたは720p。
Generate Audio。 オンにすると、動画とともに音声も生成されます。オンにするとクレジットコストがおよそ2倍になります。確認する前に、Generateボタンの上に表示される価格を確認してください。
Generate Video。 ボタンの上に表示されるクレジットコストを確認してから生成してください。まず開始フレームを確認しましょう。構図やポーズがおかしい場合は、Reference Modeが本当に期待どおりに動作しているか、文字どおりの最初のフレームとの違いを再確認してください。
よくある問題とその解決方法
結果が没個性的、または顔がない → 被写体・アクションが弱いか、形容詞が積み重なっています。最初の言葉に具体的な被写体と明確な1つのアクションを入れて書き直してください。
肌や表面がプラスチック的、または「3D」に見える → 「no 3D, no cartoon, no VFX」と「film grain, natural imperfections」を追加してください。
生成のたびにキャラクターが変わる → 同じリファレンス画像を再利用し、[img1](またはそのツールで表示される同等のタグ)でタグ付けし、「maintaining consistent [subject]」を追加してください。
720pで細部の描写が足りない → ディテールが明示的にリクエストされていません。「ultra-sharp detail」または「crisp texture」を追加してください。
カメラや動きが不安定に感じる → 「stable [subject], smooth motion」を追加してください。
プロンプトの一部が無視されているように感じる → プロンプトが長すぎる、矛盾している、または複数ショットのシーケンスを1つの段落に詰め込んでいます。番号付きの個別ショットに分割してください。
生成前のクイックチェックリスト:
最初の20〜30語にSubjectとActionがありますか?
1ショットに1つのアクション、現在形の動詞ですか?
カメラが明示的に指定されていますか(サイズ+動き+アングル)?
使用しているツールに合わせてリファレンスが正しくタグ付けされていますか(例:Image to Videoでの[img1]/[audio1])?
リアリズムのための安定性制約が含まれていますか(3D/カートゥーン/VFXなし)?
これが役に立ちましたか?
まだお困りですか? チームに質問