Video to Video
Transforma una foto estática en movimiento, o reemplaza a una persona en un vídeo, con nuestro AI Video to Video Generator. Sube una foto y un vídeo para crear resultados dinámicos y cinematográficos con alta consistencia visual.
Última actualización Hace alrededor de 5 horas
Qué hace la herramienta
Video to Video funciona de dos formas: anima una foto estática usando el movimiento de un vídeo de referencia, o sustituye a la persona en un vídeo existente por otra, manteniendo la escena, el trabajo de cámara y el movimiento originales intactos. Por ejemplo, dale vida a un retrato con los pasos de baile de otra persona, o reemplaza al presentador de un clip con tu propia foto. Admite NSFW por completo.
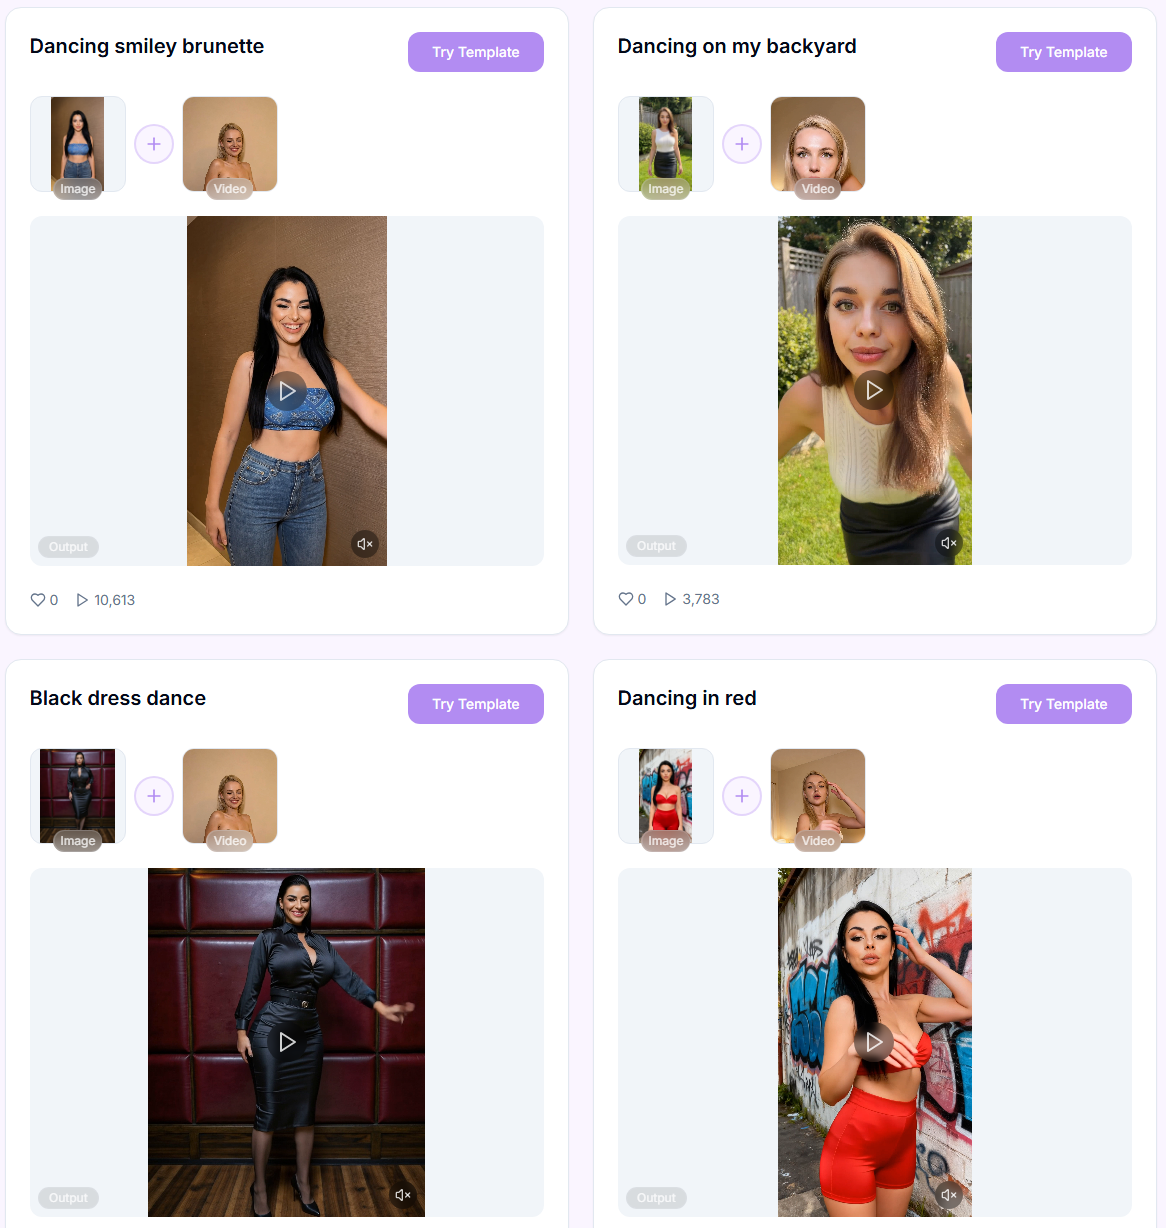
🎬 Resultados
Un vistazo a lo que Video to Video puede producir a partir de una foto y un vídeo de referencia.
¿No quieres configurarlo todo tú mismo?
Sáltate la configuración: elige un estilo ya hecho de la biblioteca de Templates y añade tu foto y vídeo. Las plantillas también te muestran qué tipos de movimiento y escenas maneja mejor el modelo.
Guía paso a paso
Paso 1. Model: elige qué modelo impulsa la transformación desde la lista desplegable. Toca uno de abajo para ver en qué destaca.
Wan 3.0 Spicy
Wan 3.0 Spicy
Duración: 5, 10, 15, 20, 25, o 30s
Resolución: 480p / 720p / 1080p
Ideal para: generación de video a video guiada por prompt con videos de referencia (hasta 3), imágenes de referencia (hasta 9), y audio de referencia, creando ediciones o transformaciones largas y de varias tomas de hasta 30 segundos, con audio nativo opcional escrito por el modelo. Entrenado en un extenso conjunto de datos etiquetado de contenido NSFW.
Fortalezas: puede escribir su propia banda sonora mediante el interruptor Generate Audio, sigue prompts largos tipo guion divididos en tomas con marca de tiempo, los tokens de referencia ([img1], [vid1], [audio1]) te permiten dirigirte exactamente a qué archivo subido usar, mayor consistencia multi-sujeto y control de cámara que los modelos Wan anteriores.
Desventajas: los mejores resultados necesitan un prompt acorde a la duración: los prompts cortos en duraciones largas dejan las decisiones de trama y toma al modelo. Sin prompt negativo; los elementos no deseados deben describirse explícitamente.
Notas de contenido: Filtros: Mínimos
Wan 3.0 Prime Spicy
Wan 3.0 Prime Spicy
Duración: 5, 10, 15, 20, 25, o 30s
Resolución: 480p / 720p / 1080p
Ideal para: la misma generación de video a video guiada por prompt que Wan 3.0 Spicy (videos de referencia hasta 3, imágenes de referencia hasta 9 y audio de referencia), pero devuelto aproximadamente un 40 % más rápido.
Fortalezas: misma calidad de salida y mismas funciones que Wan 3.0 Spicy (interruptor Generate Audio, prompts tipo guion, tokens de referencia, consistencia multi-sujeto); la diferencia es el tiempo de espera, importante al probar ideas o iterar sobre una toma.
Desventajas: cuesta más por segundo que Wan 3.0 Spicy para el mismo resultado; misma sensibilidad a la longitud del prompt y ausencia de prompt negativo.
Notas de contenido: Filtros: Mínimos
Seedance 2.0 Uncensored
Seedance 2.0 Uncensored
Duración: 5–15s
Resolución: 720p / 480p
Ideal para: generación de vídeo guiada por prompt con primer/último fotograma y referencia multimodal (imágenes, vídeos, audio): editar un vídeo terminado reemplazando vestuario, fondo, iluminación o escenario mientras se preserva el movimiento, el tiempo y la identidad del sujeto. Entrenado con un enorme conjunto de datos anotados de contenido NSFW.
Puntos fuertes: una distinción clara entre "qué mantener" y "qué cambiar" en el prompt produce resultados predecibles sin "reconstruir" la escena. Preserva bien la animación original y las proporciones del cuerpo cuando el prompt está formulado con precisión. Maneja las referencias [video 1]/[audio 1]/[image 1] con precisión y puede generar audio cuando no se proporciona referencia.
Compensaciones: el orden en que se describen los elementos es crítico: si empiezas con los cambios en lugar de lo que hay que mantener, el modelo puede perder el movimiento y el tiempo originales. La referencia de vídeo original [Video 1] debe ser clara para resultados fiables. Duración máxima de las 3 referencias de vídeo es de 15 segundos. Más lento que Seedance 2.0 Fast Spicy.
Notas de contenido: Filtros: Mínimos
Seedance 2.0 Fast Spicy
Seedance 2.0 Fast Spicy
Duración: 5–15s
Resolución: 720p / 480p
Ideal para: generación de vídeo más rápida y económica con el mismo enfoque de primer/último fotograma y referencia multimodal que Seedance 2.0 Uncensored: buena calidad, edición de vídeos pregrabados (vestuario, fondos, iluminación) mientras se preserva el movimiento, el tiempo y la identidad facial. Además de entrenamiento adicional con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: tiempo de procesamiento rápido; distinguir claramente entre "qué mantener" y "qué cambiar" en el prompt produce resultados predecibles sin tener que "reconstruir" la escena. Más rápido y económico que Seedance 2.0 Uncensored.
Compensaciones: el orden en que se describen los cambios es crítico: si empiezas con los cambios en lugar de lo que hay que mantener, el modelo puede perder el movimiento y el tiempo originales. La referencia de vídeo original [Video 1] debe ser clara. Duración máxima de las 3 referencias de vídeo es de 15 segundos. La calidad es inferior a Seedance 2.0 Uncensored.
Notas de contenido: Filtros: Mínimos
Seedance 2.5 Uncensored
Seedance 2.5 Uncensored
Duración: 5, 10, 15, 20 o 30 s
Resolución: 480p / 720p / 1080p
Ideal para: generación de video a video guiada por prompt a partir de hasta 10 videos de referencia, 30 imágenes de referencia y 10 clips de audio de referencia (citados en el prompt como [vid1], [img1], [audio1]) en resultados largos de varias tomas de hasta 30 segundos. Entrenado con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: metraje más natural y menos «de IA»: mejores transiciones de cámara, estabilidad del sujeto, iluminación y detalle de piel y ojos; los prompts con marcas de tiempo («0–5s: …, 6–10s: …») controlan qué ocurre y cuándo; audio nativo opcional con el interruptor Generate Audio.
Compensaciones: el modelo Seedance más caro: 1080p cuesta unas 3,4 veces la tarifa de 720p y los segundos de tus videos de referencia se cobran junto con el resultado, así que prueba primero en 480p/720p. Sin prompt negativo. El video puede salir sin audio aunque Generate Audio esté activado.
Notas de contenido: Filtros: Mínimos
Dream Actor M2.0
Dream Actor M2.0
Duración: hasta 30s
Resolución: 720p / 480p
Ideal para: dar vida a una imagen estática de personaje aplicando exactamente los movimientos corporales, gestos, expresiones faciales y movimientos labiales de un vídeo de referencia. Ideal para interpretaciones de personajes, secuencias de baile, animaciones expresivas y escenas con varios personajes, más entrenamiento adicional con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: excelente fidelidad de movimiento y comprensión semántica de los movimientos, alta consistencia de identidad y fondo, gran rendimiento con personajes no humanos y estilizados, expresiones naturales, salida estable en acciones complejas. La opción más estable para dar vida a una foto.
Compensaciones: mejores resultados con composición bien emparejada, vídeo de referencia claro (buena iluminación, mínima oclusión), e imagen de personaje compatible.
Notas de contenido: Filtros: Mínimos
Animate
Animate
Duración: hasta 30s
Resolución: 720p / 480p
Ideal para: dar vida a una imagen estática de personaje (retrato, ilustración o diseño) aplicando exactamente los movimientos corporales, gestos y expresiones faciales de un vídeo de referencia. Ideal para interpretaciones de personajes, secuencias de baile y animaciones expresivas, más entrenamiento adicional con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: fuerte fidelidad de movimiento con expresiones naturales, alta consistencia de identidad, transferencia sin fisuras de acciones complejas.
Compensaciones: mejores resultados con composición bien emparejada, vídeo de referencia claro (buena iluminación, mínima oclusión), e imagen de personaje compatible. Puede ser inestable (ver la nota de abajo).
Notas de contenido: Filtros: Mínimos
Replace
Replace
Duración: hasta 30s
Resolución: 720p / 480p
Ideal para: reemplazar al personaje principal en un vídeo existente por un sujeto de tu imagen, preservando el movimiento, la escena, la iluminación y el trabajo de cámara originales. Perfecto para intercambios de personajes en material grabado, reemplazos de presentador, e integración sin fisuras, más entrenamiento adicional con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: mantiene los elementos originales de la escena y el movimiento, fuerte preservación de identidad, integración realista con el entorno y la iluminación.
Compensaciones: mejores resultados con buena coincidencia de pose/composición entre imagen y vídeo, material de referencia limpio. Puede ser inestable (ver la nota de abajo).
Notas de contenido: Filtros: Mínimos
Kling 2.6 Motion
Kling 2.6 Motion
Duración: hasta 30s (los vídeos más largos se recortan automáticamente)
Resolución: solo 1080p
Ideal para: aplicar coreografía y movimientos de un vídeo de referencia a un sujeto en una imagen de personaje. Ideal para pasos de baile complejos, gestos y actuaciones de cuerpo completo. Genial para secuencias de baile, transferencia de movimiento, y creación de animaciones de personajes consistentes.
Puntos fuertes: extrae y transfiere el movimiento/coreografía completos (incluidas acciones complejas, manos, expresiones faciales) de un vídeo de referencia. Opción de conservar sonido original. Fuerte fidelidad de movimiento y consistencia del personaje.
Compensaciones: requiere buena calidad de vídeo de referencia (movimientos claros, sin obstrucciones) e imagen de personaje compatible. Filtros de seguridad más estrictos que los otros modelos.
Notas de contenido: Filtros: Activos
MiniMax H3 Max
MiniMax H3 Max
Duración: 5, 6, 8, 10, 12, o 15s
Resolución: 480p / 720p / 1080p
Ideal para: transformar un vídeo existente con un prompt de texto, combinándolo opcionalmente con imágenes de referencia, vídeos adicionales, y audio (hasta 9 imágenes, 3 vídeos, 3 clips de audio, 12 archivos en total) para guiar el resultado.
Fortalezas: los tokens de referencia (Image 1, Video 1, Audio 1) te permiten indicar exactamente qué archivo subido impulsa cada parte de la edición; audio estéreo nativo en cada resultado, sin necesidad de activar nada; relaciones de aspecto flexibles (16:9, 9:16, 4:3, 3:4, 1:1, 21:9, o Adaptativo).
Desventajas: se cobra tanto por los segundos del vídeo de origen como por los del resultado. Sin prompt negativo; describe las exclusiones al final del prompt principal. El audio no se puede desactivar. Los prompts largos se comprimen internamente, así que un texto más corto y preciso suele funcionar mejor.
Notas de contenido: Filtros: Activados. Solo SFW, no admite contenido NSFW.
Elección rápida:
¿Necesitas una edición o transformación larga y de varias tomas guiada por prompt (hasta 30s) combinando audio nativo opcional y referencias de video/imagen/audio? → Wan 3.0 Spicy.
¿Necesitas ese mismo resultado más rápido, aunque cueste más por segundo? → Wan 3.0 Prime Spicy.
¿Necesitas hasta 10 videos de referencia más 30 imágenes y 10 clips de audio en una sola generación, hasta 30 s y 1080p? → Seedance 2.5 Uncensored.
¿Necesitas la transferencia de coreografía/baile de mayor calidad, SFW? → Kling 2.6 Motion.
¿Quieres dar vida a una foto estática con un vídeo de referencia, la opción más estable, incluido NSFW? → Dream Actor M2.0.
Lo mismo, pero no te importa menos estabilidad → Animate.
¿Necesitas cambiar a la persona en un vídeo existente manteniendo la escena? → Replace.
¿Editas un vídeo terminado (vestuario, fondo, iluminación) manteniendo el movimiento y la identidad? → Seedance 2.0 Uncensored o Seedance 2.0 Fast Spicy (más económica, más rápida).
¿Necesitas transformar un vídeo existente con un prompt de texto, además de referencias opcionales de imagen/vídeo/audio, SFW? → MiniMax H3 Max.
Paso 2. Upload your Image: elige un retrato claro o una foto de cuerpo entero de tu personaje. Formatos admitidos: JPG o PNG. La imagen debe mostrar un rostro bien iluminado y sin obstrucciones (sin gafas de sol ni sombras fuertes). Mínimo recomendado: 512px por lado.
Paso 3. Upload your Video: sube un vídeo o pega un enlace (Instagram o TikTok) para usarlo como fuente de movimiento; los enlaces solo funcionan con algunos modelos, y Seedance, Wan 3.0 y MiniMax H3 requieren un archivo de vídeo subido. El vídeo define el movimiento, los gestos y las expresiones. La duración y la tasa de fotogramas se toman del vídeo de origen. La duración mínima facturada es de 5 segundos. Formatos admitidos: MP4, MOV. También puedes activar Keep original sound para conservar el audio del vídeo de origen.
Paso 4. Prompt: necesario para los modelos basados en prompt (Wan 3.0 Spicy, Wan 3.0 Prime Spicy, Seedance 2.0 Uncensored, Seedance 2.0 Fast Spicy, Seedance 2.5 Uncensored, MiniMax H3 Max): describe qué mantener y qué cambiar, dirigiéndote a tus archivos subidos en orden con tokens de referencia ([image 1], [video 1], [audio 1]). Los modelos de transferencia de movimiento (Dream Actor M2.0, Animate, Replace, Kling 2.6 Motion) no usan prompt: toman el movimiento directamente de tu vídeo de origen. ¿No sabes cómo formularlo? Haz clic en el botón » AI Prompt Assistant debajo del campo para convertir tu idea en un prompt correctamente formateado.
Paso 5. Resolution: selecciona la resolución del video de salida. La mayoría de los modelos ofrecen 720p o 480p; Wan 3.0 Spicy, Wan 3.0 Prime Spicy, Seedance 2.5 Uncensored, MiniMax H3 Max y Kling 2.6 Motion también ofrecen 1080p.
Paso 6. Generate: haz clic en Generate y espera mientras el modelo procesa tu vídeo. Cada generación cuesta créditos según la duración y ajustes seleccionados. Tu resultado aparece en la lista de tareas, listo para previsualizar, descargar, o enviar a otra herramienta.
Consejos para obtener los mejores resultados
Empareja composición y pose: mantén la imagen y el vídeo subidos alineados en posición de cámara y pose corporal. El desajuste puede provocar distorsión facial o desajustes de encuadre.
Mantén las relaciones de aspecto consistentes: si tu foto y vídeo tienen relaciones de aspecto diferentes, la IA debe recortar o estirar para ajustarse. Las relaciones coincidentes dan un mapeo facial más preciso y un movimiento más suave.
La calidad importa: cuanto mayor sea la resolución y claridad de tus entradas, mejor será el resultado. Evita rostros borrosos, iluminación sobreexpuesta, o desenfoque de movimiento extremo.
Sigue los ejemplos de las plantillas: usa las plantillas integradas en esta herramienta para entender lo que el modelo puede lograr realmente. Reflejan los tipos de movimiento y escenas que el modelo maneja mejor.
Usa referencias de vídeo estables: elige vídeos donde la cámara esté estable y el rostro permanezca claramente visible y centrado. Evita escenas complejas, movimiento rápido, o cambios frecuentes de cámara para resultados más fiables.
Solución de problemas
Estás trabajando con IA: los errores ocasionales, artefactos o resultados inesperados son normales, y no se garantiza un resultado 100% correcto. Si un clip no se ve bien, intenta regenerarlo o ajustar tus entradas.
Animate y Replace pueden ser inestables. Usa solo materiales de alta calidad, y evita referencias de vídeo largas; de lo contrario, no podemos garantizar un resultado normal.
Si algo no salió como esperabas, contáctanos por el chat de soporte en la app, o escribe a [email protected].
Preguntas frecuentes
¿Qué pasa si mi vídeo no contiene un rostro visible?
¿Qué pasa si mi vídeo no contiene un rostro visible?
Recibirás un error, pero tus créditos se reembolsarán automáticamente.
¿Puedo subir clips largos?
¿Puedo subir clips largos?
Sí, hasta 30 segundos.
¿Por qué el rostro parpadea o cambia durante el vídeo?
¿Por qué el rostro parpadea o cambia durante el vídeo?
Esto puede ocurrir cuando el rostro no es claramente visible en todos los fotogramas, el vídeo contiene movimiento rápido o cortes, o la iluminación cambia significativamente. Para mejores resultados, usa vídeos estables con iluminación consistente y un rostro visible.
¿Por qué falló mi generación?
¿Por qué falló mi generación?
Tu tarea puede fallar debido a archivos no admitidos o corruptos, entradas de muy baja calidad, restricciones de contenido según el modelo seleccionado, o movimiento inestable en el vídeo de origen. Intenta simplificar tus entradas y usar un vídeo más corto o más claro.
¿Cuál es la diferencia entre Animate y Kling 2.6 Motion?
¿Cuál es la diferencia entre Animate y Kling 2.6 Motion?
Animate sigue el movimiento del vídeo y es más rápido pero menos estable. Kling 2.6 Motion ofrece mayor calidad y consistencia, pero usa filtros de seguridad más estrictos.
¿Por qué mi vídeo se corta a 30 segundos?
¿Por qué mi vídeo se corta a 30 segundos?
Kling 2.6 Motion admite una duración máxima de 30 segundos. Si tu vídeo es más largo, se recortará automáticamente.
¿Puedo usar vídeos de Instagram o TikTok?
¿Puedo usar vídeos de Instagram o TikTok?
Sí, puedes pegar enlaces directamente en la herramienta. Los enlaces solo funcionan con algunos modelos, y Seedance, Wan 3.0 y MiniMax H3 requieren un archivo de vídeo subido. Asegúrate de que el vídeo sea público y accesible.
¿Se me cobrará si la generación falla?
¿Se me cobrará si la generación falla?
No. Los créditos de las tareas fallidas se reembolsan automáticamente a tu saldo.
Cursos completos por modelo
¿Quieres profundizar en el estilo de prompting de un modelo específico? Cada uno tiene su propio curso detallado dentro de ZenCreator:
Y ahora, ¿qué?
Video Upscaler: mejora la nitidez y agranda tu resultado
Video Merger: combina clips en un vídeo más largo
Image Editor: pule tu foto de origen antes de subirla
¿Fue útil esto?
¿Aún necesitas ayuda? Pregunta al equipo