Image to Video
Convierte la imagen en un vídeo listo para redes sociales. Elige un modelo, escribe un prompt opcional, y procesa por lotes hasta 100 clips.
Última actualización Hace alrededor de 5 horas
Qué hace la herramienta
Image to Video toma tu imagen de referencia y sintetiza un clip corto que preserva el sujeto y el estilismo general mientras añade movimiento, movimientos de cámara y dinámicas sutiles de escena. Puede crear cualquier tipo de vídeo, admite NSFW por completo, y funciona igual de bien para proyectos personales o contenido para redes sociales.
🎬Resultados
Un vistazo a lo que Image to Video puede producir a partir de una sola referencia.
¿No quieres configurarlo todo tú mismo?
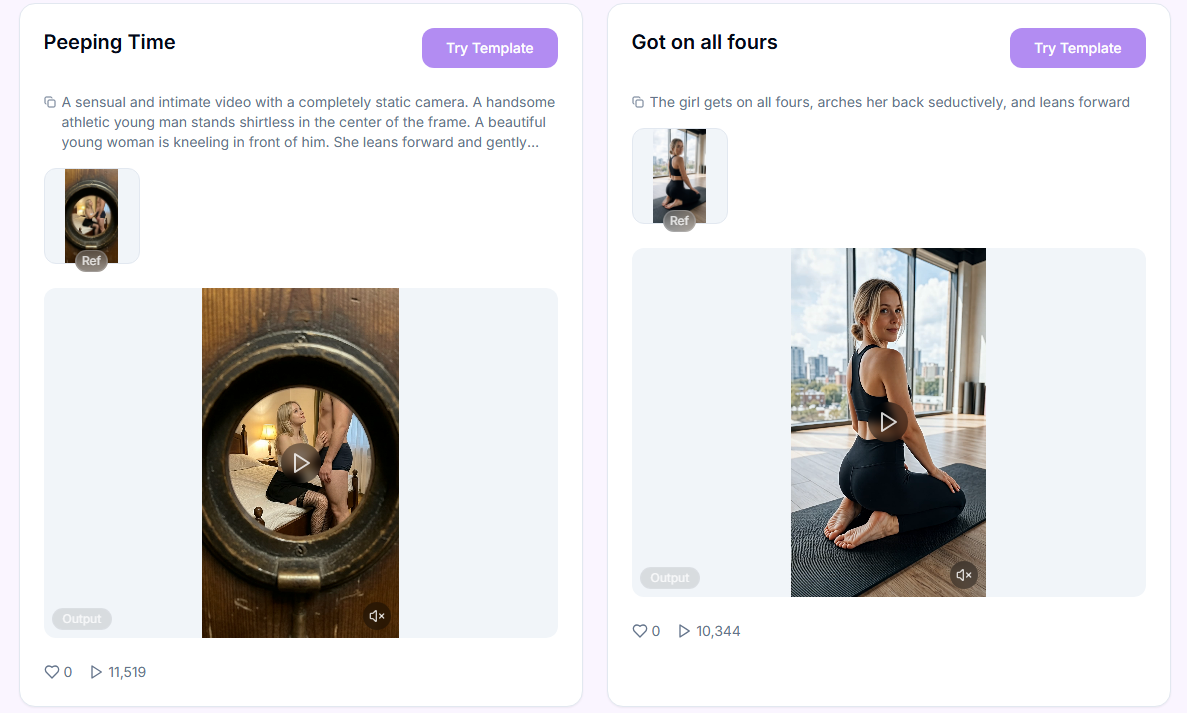
Sáltate la configuración: elige un estilo ya hecho de la biblioteca de Templates y añade tu referencia. Las plantillas se pueden filtrar por etiquetas o buscar por nombre.
Guía paso a paso
Paso 1. Model: elige qué modelo anima tu imagen en la lista desplegable. Toca uno de abajo para ver en qué destaca.
Wan 3.0 Spicy
Wan 3.0 Spicy
Duración: 5, 10, 15, 20, 25, o 30s
Resolución: 480p / 720p / 1080p
Ideal para: animar una imagen mediante Reference Mode (hasta 9 imágenes de referencia más hasta 3 clips de audio de referencia) en clips largos y de varias tomas de hasta 30 segundos, con audio nativo opcional escrito por el modelo. Entrenado en un extenso conjunto de datos etiquetado de contenido NSFW.
Fortalezas: puede escribir su propia banda sonora mediante el interruptor Generate Audio, sigue prompts largos tipo guion divididos en tomas con marca de tiempo, los tokens de referencia ([img1], [audio1]) te permiten dirigirte exactamente a qué archivo subido usar, mayor consistencia multi-sujeto y control de cámara que los modelos Wan anteriores.
Desventajas: los mejores resultados necesitan un prompt acorde a la duración: los prompts cortos en duraciones largas dejan las decisiones de trama y toma al modelo. Sin prompt negativo; los elementos no deseados deben describirse explícitamente.
Notas de contenido: Filtros: Mínimos
Wan 3.0 Prime Spicy
Wan 3.0 Prime Spicy
Duración: 5, 10, 15, 20, 25, o 30s
Resolución: 480p / 720p / 1080p
Ideal para: la misma animación con Reference Mode que Wan 3.0 Spicy (hasta 9 imágenes de referencia más hasta 3 clips de audio de referencia) en clips largos y de varias tomas de hasta 30 segundos, con audio nativo opcional escrito por el modelo, pero devuelto aproximadamente un 40% más rápido.
Fortalezas: misma calidad de salida y mismas funciones que Wan 3.0 Spicy (interruptor Generate Audio, prompts tipo guion, tokens de referencia, consistencia multi-sujeto); la diferencia es el tiempo de espera, importante al probar ideas o iterar sobre una toma.
Desventajas: cuesta más por segundo que Wan 3.0 Spicy para el mismo resultado; misma sensibilidad a la longitud del prompt y ausencia de prompt negativo.
Notas de contenido: Filtros: Mínimos
Seedance Pro
Seedance Pro
Duración: 5 s o 10 s
Ideal para: animaciones más controladas entre dos estados definidos; narrativa fluida y movimiento realista de personajes.
Puntos fuertes: admite Last Frame para bucles más suaves y finales más estables. Admite 480p, 720p y 1080p.
Compensaciones: más lento que Pro Fast; funciona mejor con fotogramas de inicio/fin limpios y bien alineados para transiciones consistentes.
Notas de contenido: Filtros: Mínimos
Seedance Pro Fast
Seedance Pro Fast
Duración: 5 s o 10 s
Ideal para: previsualizaciones rápidas y borradores más económicos.
Puntos fuertes: velocidad de generación rápida, bajo coste, admite 480p, 720p y 1080p. Admite Start Frame para una guía de movimiento sencilla.
Compensaciones: menos control y menor calidad en comparación con Seedance Pro.
Notas de contenido: Filtros: Mínimos
Seedance Pro 1.5
Seedance Pro 1.5
Duración: 5 s, 10 s o 12 s
Ideal para: generar vídeos cortos y cinematográficos donde el audio y el vídeo se generan juntos en un proceso unificado. Este modelo es ideal para clips narrativos, escenas de diálogo, movimiento impulsado por audio, y narrativa expresiva directamente desde prompts o imágenes.
Puntos fuertes: Seedance 1.5 Pro es un modelo de generación conjunta de audio y vídeo que produce visuales y sonido sincronizados en un solo proceso. Ofrece sincronización labial precisa, movimiento expresivo, fuerte adherencia a las instrucciones, admite 720p y 1080p, e incluye Generate Audio y Fix camera position para un control mejorado.
Compensaciones: los mejores resultados provienen de prompts claros e instrucciones estructuradas; las escenas complejas se benefician de un diseño de prompt cuidadoso para mantener la coherencia del movimiento y el ritmo expresivo.
Notas de contenido: Filtros: Mínimos
Seedance 2.0 Spicy
Seedance 2.0 Spicy
Duración: 5 s, 6 s, 8s, 10 s, 12s 15 s
Resolución: 480p / 720p
Ideal para: animar una sola imagen como el primer fotograma literal, crear una transición entre dos fotogramas (First-Last Frame), o transferir características (apariencia, estilo, movimiento) a través de Reference Mode (hasta 9 imágenes + 3 vídeos + 3 clips de audio), más entrenamiento adicional con un enorme conjunto de datos anotados de contenido NSFW.
Puntos fuertes: alta previsibilidad del inicio del vídeo (composición, pose y ángulo de cámara se preservan exactamente como en la imagen de origen), generación usando marcadores de referencia [Image 1]/[Video 1]/[Audio 1], buena consistencia del personaje entre fotogramas al reutilizar la misma referencia. Generación de audio para vídeo en modo estándar.
Compensaciones: los tres modos de entrada funcionan de forma diferente, y es fácil confundirlos: seleccionar el modo equivocado producirá un resultado distinto al esperado; la calidad de la imagen de origen afecta directamente al resultado final. Más lento que Seedance 2.0 Fast.
Notas de contenido: Filtros: Mínimos
Seedance 2.0 Fast Spicy
Seedance 2.0 Fast Spicy
Duración: 5 s, 6 s, 8s, 10 s, 12s 15 s
Resolución: 480p / 720p
Ideal para: animar una imagen como el primer fotograma literal, crear una transición entre dos fotogramas especificados (interpolación), o transferir características usando referencias multimodales: hasta 9 imágenes, 3 vídeos y 3 clips de audio. Además, entrenamiento adicional con un enorme conjunto de datos anotados de contenido NSFW.
Puntos fuertes: alta previsibilidad del inicio del vídeo (composición, pose y ángulo se preservan exactamente como en la imagen de origen); etiquetado de referencias conveniente con [Image 1] / [Video 1] / [Audio 1], buena consistencia del personaje al reutilizar una sola referencia, tiempo de generación rápido. Más rápido y económico que la versión estándar.
Compensaciones: es fácil confundir los tres modos de entrada: seleccionar el incorrecto da un resultado distinto al esperado; la calidad de la imagen de origen afecta directamente al resultado final. La calidad es inferior a la de la versión estándar.
Notas de contenido: Filtros: Mínimos
Seedance 2.5 Spicy
Seedance 2.5 Spicy
Duración: 5, 10, 15, 20 o 30 s
Resolución: 480p / 720p / 1080p
Ideal para: escenas largas de varias tomas de hasta 30 segundos en una sola generación: una historia completa en lugar de un único momento estirado. Anima un Start Frame (o Start + End Frame), o activa Reference Mode para usar hasta 30 imágenes de referencia y 10 clips de audio de referencia, que se citan en el prompt como [img1], [audio1]. Entrenado con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: metraje más natural y menos «de IA»: mejores transiciones de cámara, estabilidad del sujeto, iluminación y detalle de piel y ojos; los prompts con marcas de tiempo («0–5s: …, 6–10s: …») controlan qué ocurre y cuándo; audio nativo opcional con el interruptor Generate Audio.
Compensaciones: el modelo Seedance más caro: 1080p cuesta unas 3,4 veces la tarifa de 720p, así que prueba primero en 480p/720p. Sin prompt negativo. El video puede salir sin audio aunque Generate Audio esté activado.
Notas de contenido: Filtros: Mínimos
Wan 2.5 + Audio
Wan 2.5 + Audio
Duración: 5 s o 10 s
Ideal para: sincronización labial, respiración, movimiento corporal rítmico, y escenas reactivas al audio usando un único archivo de audio (WAV, MP3).
Puntos fuertes: fuerte sincronización con el audio, movimiento facial y corporal expresivo. Admite 480p, 720p y 1080p.
Compensaciones: los resultados dependen en gran medida de la calidad del audio; diseñado para movimiento expresivo más que para configuraciones de cámara complejas.
Notas de contenido: Filtros: Mínimos
Wan 2.2 + LoRA
Wan 2.2 + LoRA
Duración: 5 s, 8 s.
Ideal para: generación ultrarrápida de imagen a vídeo con control de estilo LoRA personalizado. Ideal para creadores que quieren movimiento cinematográfico, un aspecto de personaje personalizado, y estilos visuales consistentes directamente desde una sola imagen.
Puntos fuertes: WAN 2.2 es un modelo ultrarrápido de imagen a vídeo que genera vídeo dinámico en 720p a partir de imágenes fijas y admite LoRAs personalizados para definir el movimiento y comportamiento del personaje. Los LoRAs se usan para controlar cómo se mueven, posan e interactúan los personajes con la cámara, permitiendo patrones de movimiento consistentes entre generaciones.
Plantillas de estilo LoRA:
La plataforma ofrece una gran biblioteca de plantillas de estilo LoRA que se aplican automáticamente durante la generación. Estas plantillas te permiten seleccionar rápidamente estilos de movimiento predefinidos y dinámicas de personaje, garantizando un movimiento y comportamiento visual consistentes en varios vídeos sin ajuste manual del prompt.
Compensaciones: WAN 2.2 + LoRAs se centra en la velocidad y la consistencia.
Notas de contenido: Filtros: Mínimos
Wan 2.6 + Audio
Wan 2.6 + Audio
Duración: 5 s, 10 s o 15 s
Ideal para: generación de imagen a vídeo de alta calidad con audio, clips más largos, y movimiento expresivo con sonido sincronizado.
Puntos fuertes: fuerte sincronización de audio, animación facial expresiva y movimiento corporal, admite 720p y 1080p.
Compensaciones: los resultados dependen de la calidad de la entrada y la claridad del prompt; mejor adaptado para escenas controladas.
Notas de contenido: Filtros: Mínimos
Wan 2.6 Ultra Fast
Wan 2.6 Ultra Fast
Duración: 5 s, 10 s o 15 s
Ideal para: generaciones rápidas, pruebas rápidas, flujos de trabajo para redes sociales, y producción de contenido por lotes.
Puntos fuertes: tiempo de renderizado significativamente más rápido, soporte nativo de audio, movimiento expresivo, admite 720p y 1080p.
Compensaciones: consistencia visual ligeramente inferior en comparación con Wan 2.7; optimizado principalmente para la velocidad.
Notas de contenido: Filtros: Mínimos
Wan 2.7 + Audio
Wan 2.7 + Audio
Ideal para: generación de imagen a vídeo con audio, clips más largos, y movimiento expresivo con sonido sincronizado, generaciones cinematográficas, movimiento de cámara suave, personajes realistas, y renders finales de alta calidad.
Puntos fuertes: consistencia temporal mejorada, mejor comprensión del prompt, calidad de movimiento mejorada, admite 720p y 1080p.
Compensaciones: más lento que los modelos Ultra Fast; los mejores resultados requieren prompts claros e imágenes de entrada de alta calidad.
Notas de contenido: Filtros: Mínimos
Wan 2.2 Spicy
Wan 2.2 Spicy
Duración: 5s, 8s
Ideal para: generación ultrarrápida de imagen a vídeo, estilos visuales consistentes directamente desde una sola imagen, más entrenamiento adicional con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: detalle impactante, fuerte adherencia a tu imagen de referencia, bueno para movimientos de cámara dramáticos y gradación con ambiente.
Compensaciones: un filtrado menos conservador significa que debes mantener los prompts precisos; la anatomía y los pequeños detalles pueden desviarse si llevas al extremo.
Notas de contenido: Filtros: Mínimos
Wan 2.7 Spicy
Wan 2.7 Spicy
Duración: 5 s , 10 s , 15 s
Ideal para: generación de imagen a vídeo de alta calidad con audio, clips más largos, y movimiento expresivo con sonido sincronizado, más entrenamiento adicional con un enorme conjunto de datos etiquetados de contenido NSFW.
Puntos fuertes: consistencia temporal mejorada, mejor comprensión del prompt, calidad de movimiento mejorada, admite 720p y 1080p.
Compensaciones: más lento que los modelos Ultra Fast; los mejores resultados requieren prompts claros e imágenes de entrada de alta calidad.
Notas de contenido: Filtros: Mínimos
Wan 2.7 + LoRA
Wan 2.7 + LoRA
Duración: 5s / 10s / 15s
Ideal para: generar rápidamente vídeos a partir de una imagen mientras controlas el estilo usando LoRAs personalizados. Ideal para creadores que quieren movimiento cinematográfico, un aspecto de personaje personalizado, y estilos visuales consistentes, todo basado en una sola imagen.
Puntos fuertes: WAN 2.7 es un modelo de conversión de imagen a vídeo que genera vídeo dinámico en 720p o 1080p con audio sintetizado a partir de imágenes fijas y admite LoRAs personalizados para definir el movimiento y comportamiento del personaje. Los LoRAs se usan para controlar cómo se mueven, posan e interactúan los personajes con la cámara, garantizando patrones de movimiento consistentes entre generaciones. No se requiere prompt.
Plantillas de estilo LoRA: La plataforma ofrece una gran biblioteca de plantillas de estilo LoRA que se aplican automáticamente durante la generación. Estas plantillas te permiten seleccionar rápidamente estilos de movimiento preestablecidos y dinámicas de personaje, garantizando un movimiento y comportamiento visual consistentes en varios vídeos sin necesidad de ajuste manual del prompt.
Compensaciones: WAN 2.7 + LoRAs prioriza la calidad y la consistencia. Añadir un prompt puede entrar en conflicto con el prompt predeterminado y causar errores en el vídeo generado o hacer que el LoRA falle.
Notas de contenido: Filtros: Mínimos
Kling 2.6 + Audio
Kling 2.6 + Audio
Opciones de duración: 5 s o 10 s
Ideal para: generación de vídeo SFW de alta calidad con soporte de audio nativo. Ideal para personajes que hablan, escenas de diálogo, contenido de marca, presentaciones de producto, y clips cortos realistas donde el audio y los visuales deben generarse juntos. Admite Start Frame, que define cómo empieza el movimiento.
Puntos fuertes: este modelo es un modelo de generación nativa de audio y vídeo, lo que significa que el vídeo y el audio se crean simultáneamente en un solo proceso. Produce voz y sonido sincronizados alineados con el movimiento visual, ofrece animación facial realista e identidad estable, y admite resolución 1080p. El modelo incluye Generate Audio para la creación de audio integrada en tomas de cámara estables y sin movimiento.
Compensaciones: optimizado para el realismo y resultados limpios y seguros para la marca en lugar de la estilización extrema; el mejor rendimiento proviene de prompts claros y movimiento controlado.
Notas de contenido: Filtros: Activos
MiniMax H3 Max
MiniMax H3 Max
Duración: 5, 6, 8, 10, 12, o 15 s
Resolución: 480p / 720p / 1080p
Ideal para: animar un Start Frame, un End Frame, o ambos, y usar Reference Mode para guiar el estilo, personaje, o sonido a partir de tus propias imágenes, video, y audio: hasta 9 imágenes de referencia, 3 videos de referencia, y 3 clips de audio de referencia (12 archivos en total).
Fortalezas: los tokens de referencia (Image 1, Video 1, Audio 1) te permiten indicar exactamente qué archivo subido usar; cada clip obtiene automáticamente una pista de audio estéreo nativa, sin necesidad de activar nada; relaciones de aspecto flexibles (16:9, 9:16, 4:3, 3:4, 1:1, 21:9, o Adaptativo).
Desventajas: precio completo, aproximadamente el doble de MiniMax H3 Max Turbo. Sin prompt negativo; los elementos no deseados deben describirse al final del prompt principal. El audio no se puede desactivar. Los prompts largos se comprimen internamente, así que descripciones más cortas y precisas suelen funcionar mejor.
Notas de contenido: Filtros: Activados. Solo SFW, no admite contenido NSFW.
MiniMax H3 Max Turbo
MiniMax H3 Max Turbo
Duración: 5, 6, 8, 10, 12, o 15 s
Resolución: 480p / 720p / 1080p
Ideal para: animación de Start/End Frame rápida y económica cuando no necesitas imágenes, video, o audio de referencia.
Fortalezas: aproximadamente la mitad de precio que MiniMax H3 Max y más rápido; los mismos controles de Start Frame / End Frame / ambos; audio estéreo nativo incluido automáticamente.
Desventajas: sin Reference Mode. Para referencias de imagen, video, o audio, usa MiniMax H3 Max en su lugar. Sin prompt negativo. El audio no se puede desactivar.
Notas de contenido: Filtros: Activados. Solo SFW, no admite contenido NSFW.
Grok
Grok
Duración: 6 s o 10 s
Ideal para: animaciones dinámicas, clips conceptuales rápidos, y movimiento expresivo a partir de una sola imagen.
Puntos fuertes: generación rápida, adecuada para escenas enérgicas e iteración rápida.
Compensaciones: menos estable y menos consistente en comparación con modelos cinematográficos de gama alta.
Notas de contenido: Filtros: Parciales
Elección rápida:
¿Necesitas el clip de una sola toma más largo (hasta 30s) mediante Reference Mode, con audio nativo opcional y hasta 9 imágenes + 3 clips de audio como referencias? → Wan 3.0 Spicy.
¿Necesitas ese mismo resultado más rápido, aunque cueste más por segundo? → Wan 3.0 Prime Spicy.
¿Necesitas una historia completa de 30 segundos en una sola generación, con hasta 30 imágenes de referencia y audio nativo? → Seedance 2.5 Spicy.
¿Necesitas vídeos SFW que hablan con audio nativo? → Kling 2.6 + Audio.
¿Necesitas previsualizaciones ultrarrápidas? → Seedance Pro Fast.
¿Necesitas narrativa controlada y transiciones fluidas entre estados definidos? → Seedance Pro.
¿Necesitas generación nativa de audio y vídeo con movimiento expresivo? → Seedance Pro 1.5.
¿Necesitas animación impulsada por audio con o sin un archivo de audio subido? → Wan 2.5 + Audio.
¿Necesitas imagen a vídeo ultrarrápida con movimiento de personaje impulsado por LoRA? → Wan 2.2 + LoRA.
¿Necesitas clips más largos impulsados por audio con movimiento y duración más expresivos? → Wan 2.6 + Audio.
¿Necesitas animaciones dinámicas rápidas y clips conceptuales rápidos? → Grok.
¿Necesitas NSFW ultrarrápido de alto detalle con movimientos de cámara dramáticos y gradación cinematográfica con ambiente? → Wan 2.2 Spicy
¿Necesitas la mejor calidad de movimiento y consistencia temporal en clips NSFW impulsados por audio? → Wan 2.7 Spicy (5s / 10s / 15s)
¿Necesitas animación de Start/End Frame con imágenes, video, o audio de referencia guiando el estilo, personaje, o sonido? → MiniMax H3 Max.
¿Necesitas animación de Start/End Frame rápida y económica sin referencias? → MiniMax H3 Max Turbo.
Paso 2. Upload Reference Image: añade de 1 a 100 imágenes; cada archivo genera su propio clip. Usa entradas nítidas y bien iluminadas.
Paso 3. Model Settings: configura parámetros específicos del modelo como añadir LoRAs, activar Fix camera position, o establecer un Start/End Frame. Los controles disponibles dependen del modelo seleccionado.
Paso 4. Prompt: describe el movimiento y el ambiente: "empuje lento de cámara, cabello moviéndose suavemente, brisa suave, gradación cinematográfica." La mayoría de los modelos necesitan uno, pero algunos (como Wan 2.7 + LoRA) funcionan sin prompt. Consulta la ficha del modelo arriba, ya que añadir uno a veces puede entrar en conflicto con el estilo integrado de un modelo. ¿No sabes cómo formularlo? Haz clic en el botón » AI Prompt Assistant debajo del campo para convertir tu idea en un prompt correctamente formateado.
Paso 5. Negative Prompt (opcional): restringe artefactos no deseados (disponible para algunos modelos): "manos deformadas, desenfoque intenso, sobre-nitidez, parpadeo."
Paso 6. Duration: va de 5 a 30 segundos según el modelo (hasta 30 s en Wan 3.0 Spicy y Seedance 2.5 Spicy). Consulta la ficha del modelo arriba para ver las opciones exactas.
Paso 7. Quality: selecciona la resolución de salida. La mayoría de los modelos admiten 480p, 720p y 1080p, pero la disponibilidad exacta varía según el modelo. Consulta la ficha del modelo arriba.
Paso 8. Generate Videos: inicia el lote; verás el estado por clip y podrás abrir los resultados.
Consejos de prompting para vídeo
Céntrate en el movimiento y la cámara: "parallax suave, dolly-in lento, aleteo sutil del cabello, ondulación de la tela, poca profundidad de campo."
Mantén una idea por clip. Si quieres varios movimientos, renderiza versiones separadas (es más rápido y más limpio).
Para la consistencia de identidad, describe los rasgos clave de rostro/pelo en el prompt y elige el mismo modelo/duración en todo el lote.
Usa un negativo compacto: "parpadeo, ghosting, piel plástica, deformación extrema, marca de agua, texto."
Adapta tu prompt al modelo: indicaciones de audio como "ella dice…" o sonido ambiental solo funcionan con modelos con capacidad de Audio.
Para los modelos Spicy (NSFW), describe la acción o pose específica que quieres: un prompt vago no producirá contenido explícito automáticamente por sí solo.
Una imagen de referencia limpia y bien iluminada a menudo mejora la coherencia del movimiento más que un prompt más largo.
Consulta la guía completa "Cómo hacer prompts para Image to Video".
Mejores prácticas y notas profesionales
Empieza con 5s, aprueba el look, y luego pasa a 10s (o más, en modelos que lo admitan) para las selecciones finales.
Haz el upscale y Head & Face Swap en la foto como último paso antes de animarla, ya que Head & Face Swap no se puede aplicar a un vídeo terminado.
Si un modelo admite Start/End Frame, usa ambos en lugar de dejar el End Frame en blanco: da resultados mucho más predecibles.
Procesa por lotes unas cuantas imágenes de referencia con los mismos ajustes para comparar opciones, y luego solo mejora la resolución o intercambia el rostro de tus favoritos para ahorrar créditos.
Adapta la duración al destino del video: 5–6 s para Stories/Reels, hasta 15 s para contenido más largo en la mayoría de los modelos, o hasta 30 s en Wan 3.0 Spicy o Seedance 2.5 Spicy para escenas completas en una sola generación.
Elige una referencia que ya coincida con lo que quieres en el vídeo: los modelos no pueden hacer transformaciones complejas. Elige una referencia que ya esté en la pose y el vestuario que buscas. ¿Quieres a dos personas en el vídeo? Tu referencia también necesita mostrar a dos personas.
Limitaciones conocidas (y cómo mitigarlas)
Estás trabajando con IA: los errores ocasionales, artefactos, o resultados inesperados son normales, y no se garantiza un resultado 100% correcto. Si un clip no se ve bien, intenta regenerarlo o ajustar tu prompt o referencia.
Texto pequeño/logos no serán legibles. Superponlos en postproducción si es necesario.
Manos/oclusiones pueden introducir deformaciones; reduce la complejidad o recorta más de cerca.
La sincronización audio-vídeo puede desfasarse ligeramente en clips más largos (10–30 s): los clips cortos suelen mantenerse sincronizados con más fiabilidad.
Si algo no salió como esperabas, contáctanos por el chat de soporte en la app, o escribe a [email protected].
Preguntas frecuentes
¿Puedo escribir prompts en otros idiomas además del inglés?
¿Puedo escribir prompts en otros idiomas además del inglés?
Sí, pero se recomienda el inglés.
La mayoría de los modelos (WAN y Seedance Pro) pueden técnicamente procesar prompts escritos en otros idiomas. Sin embargo, el inglés proporciona los resultados más estables y predecibles, especialmente para el movimiento, la dirección de cámara, y las indicaciones emocionales.
Mejor práctica:
Usa el inglés para producción y flujos de trabajo repetibles. Otros idiomas pueden funcionar para escenas simples, pero los resultados pueden ser menos consistentes.
¿Cómo genero audio con un modelo compatible con audio? ¿Tengo que subir un archivo de audio?
¿Cómo genero audio con un modelo compatible con audio? ¿Tengo que subir un archivo de audio?
No es necesario subir un archivo de audio para la mayoría de los modelos con audio: Wan 2.5 + Audio, Wan 2.6 + Audio, Wan 2.7 + Audio, Wan 2.7 Spicy, Seedance Pro 1.5, Seedance 2.0 Spicy/Fast Spicy y Kling 2.6 + Audio pueden generar audio directamente a partir del prompt de texto. Solo describe el sonido que quieres oír, por ejemplo:
“the girl is softly moaning”
“slow breathing, sensual rhythm”
“quiet voice, soft exhales”
El modelo generará audio sincronizado automáticamente a partir de tu prompt. Los archivos de audio (WAV o MP3) solo son necesarios si ya tienes un sonido o una pista de voz concreta que deba coincidir con precisión.
Con Wan 3.0 Spicy, activa el interruptor Generate Audio para que el modelo cree su propia banda sonora. Si está activado y no has descrito el sonido, el modelo inventa diálogos y música por su cuenta: describe explícitamente en el prompt el audio concreto (o el silencio) si es importante (p. ej., "no dialogue, no background music" o el sonido exacto que quieres).
¿Cómo puedo crear videos de más de 30 segundos?
¿Cómo puedo crear videos de más de 30 segundos?
La mayoría de los modelos generan 5–15 segundos por clip, y Wan 3.0 Spicy y Seedance 2.5 Spicy pueden generar hasta 30 segundos en una sola generación, la generación individual más larga en ZenCreator. Si te bastan 30 segundos o menos, elige uno de ellos y ajusta la duración; no hace falta encadenar clips.
Para cualquier cosa de más de 30 segundos, créala a partir de varios clips con un flujo de trabajo encadenado:
1) Genera cada clip con Start Frame y End Frame:
Genera el primer clip.
Usa el último fotograma de ese clip como Start Frame de la siguiente generación.
Opcionalmente, define un End Frame para guiar el estado final.
Repite el proceso para ampliar la secuencia.
Este enfoque te permite:
mantener la continuidad visual y de movimiento
crear videos de prácticamente cualquier duración
evitar cambios bruscos de movimiento
Este flujo es compatible con Seedance Pro, Seedance Pro 1.5, Seedance 2.0 Spicy, Seedance 2.0 Fast Spicy, Seedance 2.5 Spicy, Wan 3.0 Spicy, Wan 3.0 Prime Spicy, MiniMax H3 Max y MiniMax H3 Max Turbo (consulta la ficha del modelo arriba para saber qué modelos admiten Start/End Frame).
2) Cuando tengas tus clips (cada uno de hasta 30 s si usas Wan 3.0 Spicy o Seedance 2.5 Spicy), únelos con Video Merger:
Añade de 2 a 5 videos
Selecciona un método de unión
Usa el interruptor para elegir si conservar el audio original del video
También puedes elegir cómo recortar los videos que has subido
Pulsa Run
Este enfoque te permite:
unir sin esfuerzo de 2 a 5 clips en un video de aspecto profesional
lograr transiciones suaves y un flujo natural entre escenas
recortar clips con precisión y controlar el audio, conservando el sonido original o sustituyéndolo
crear videos más largos y de alta calidad sin cortes bruscos, mucho más allá del límite de 30 segundos por generación
¿Qué modelos admiten contenido NSFW?
¿Qué modelos admiten contenido NSFW?
La mayoría de los modelos funcionan con Filtros: Mínimos, lo que permite contenido más explícito que las opciones muy filtradas. Los modelos creados específicamente para NSFW son Wan 2.2 Spicy, Wan 2.7 Spicy, Wan 3.0 Spicy, Seedance 2.0 Spicy, Seedance 2.0 Fast Spicy y Seedance 2.5 Spicy. Los modelos Kling (Filtros: Activos) son los más restringidos y los más adecuados para contenido SFW.
¿Qué modelo es mejor para movimiento estilizado o looks experimentales?
¿Qué modelo es mejor para movimiento estilizado o looks experimentales?
Usa Wan 2.2 Spicy para la máxima libertad creativa y movimiento audaz, o Wan 2.2 + LoRA / Wan 2.7 + LoRA si quieres controlar el movimiento del personaje usando estilos de movimiento predefinidos.
¿Cuándo debería usar LoRAs?
¿Cuándo debería usar LoRAs?
Usa Wan 2.2 + LoRA o Wan 2.7 + LoRA cuando quieras:
movimiento de personaje consistente,
comportamiento de movimiento predefinido,
no necesitar inventar prompts: simplemente elegir ideas de movimiento de plantillas integradas
Los LoRAs son especialmente útiles al generar muchas variaciones a partir de una sola imagen.
¿Debo empezar con 5 o con 10 segundos?
¿Debo empezar con 5 o con 10 segundos?
Empieza con 5 segundos para validar el movimiento y el estilo.
Cuando el resultado se vea bien, cambia a una duración mayor para los clips finales: 10–15 segundos en la mayoría de los modelos, o hasta 30 segundos en Wan 3.0 Spicy y Seedance 2.5 Spicy.
¿Puedo generar varios vídeos a la vez por lotes?
¿Puedo generar varios vídeos a la vez por lotes?
Sí. Puedes subir hasta 100 imágenes de referencia, y cada imagen se renderizará como un clip de vídeo separado usando los mismos ajustes.
¿Cuál es la diferencia entre los modelos Spicy y los normales?
¿Cuál es la diferencia entre los modelos Spicy y los normales?
Los modelos Spicy están entrenados específicamente para la generación NSFW con menos restricciones. Los modelos normales con Filtros: Mínimos todavía pueden funcionar con referencias NSFW, pero no están construidos ni entrenados de la misma manera.
¿Todos los modelos necesitan un prompt?
¿Todos los modelos necesitan un prompt?
La mayoría sí, pero Wan 2.7/Wan 2.2 + LoRA funciona sin uno. Añadir un prompt allí puede incluso entrar en conflicto con su estilo integrado y causar errores.
¿Se garantiza un resultado perfecto?
¿Se garantiza un resultado perfecto?
No. Como cualquier herramienta de IA, los resultados pueden variar y los errores o artefactos ocasionales son normales. Si un clip no sale bien, inténtalo de nuevo o ajusta tu prompt o referencia.
Cursos completos por modelo
¿Quieres profundizar en el estilo de prompting de un modelo específico? Cada uno tiene su propio curso detallado dentro de ZenCreator:
¿Fue útil esto?
¿Aún necesitas ayuda? Pregunta al equipo