Wan 2.2 与 Wan 2.7 中的 LoRA:它是什么以及如何使用
最后更新 1 天前
本指南用简单的语言解释了 LoRA 是什么、为什么需要它,以及如何在 Wan 2.2 和 Wan 2.7 模型中正确使用 LoRA。
什么是 LoRA?
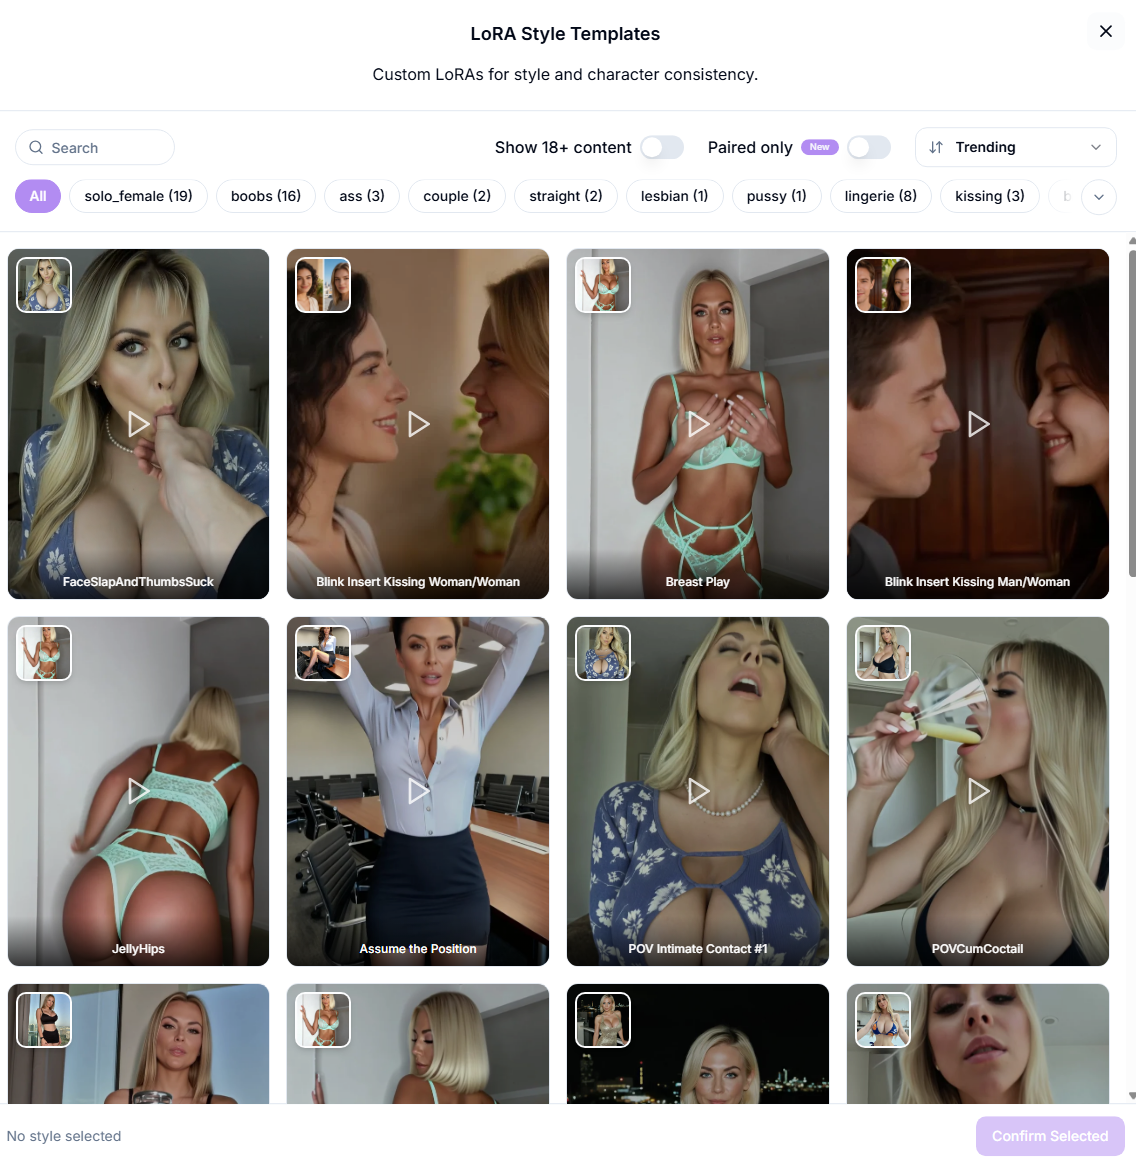
LoRA 是构建于基础视频生成模型之上、开箱即用的"附加组件"。模型本身几乎可以生成任何主题的视频(不带 LoRA 的模型可在我们网站的模型列表中找到),而 LoRA 会将其"调校"成特定的内容:例如某个特定角色、特定的视觉风格,或特定类型的动作。
简单来说:LoRA 是一套预训练的配置,能确保模型稳定地产出你想要的结果,而不是每次都生成一些全新且不可预测的内容。
工作原理
当你选择一个 LoRA 时,本质上是在选择一种预先配置好的生成"模式"。模型仍照常运作,但会将该 LoRA 对它的"训练"纳入考量,无论是角色外观、图像风格,还是角色的动作方式。
每个 LoRA 都已经内置了专属提示词,你无需自行添加任何内容;一切都已配置妥当,以帮助该 LoRA 发挥最佳表现。
重要提示: 与特定 LoRA 配套的提示词不应被复制到其他工具或与其他 LoRA 一起使用。该提示词是专门为那个 LoRA 和那个特定模型精心挑选和调校的。脱离这一搭配,它可能完全无法使用,或产生完全不同且出乎意料的结果。
LoRA 有哪些类型?
Standard LoRA 适用于 WAN 2.2,这是标准 LoRA,基于"首帧"原理运作,生成结果直接取决于你上传的图片。如果它与 LoRA 预览图有差异,结果可能完全不同,或包含瑕疵和错误。
Blink LoRA 适用于 WAN 2.2,是一种独立类型的 LoRA,会在视频内嵌入场景跳转。视频以一个场景开始(你的原始照片),随后突然"跳转"到另一个场景或情节,同时角色的外观保持不变、仍可识别。使用此类 LoRA 模型时,无需让预览图与你上传用于生成的照片保持一致。
Paired LoRA 适用于 WAN 2.2,是一种独特类型的 LoRA,可同时处理两个角色,而非单一角色。要生成视频,你需要上传两张照片(每个角色一张),模型会合成一个展现两者互动的场景,同时保留双方的外观。当你需要展示两个特定角色在一起,而不是随机生成一个搭档时,这类 LoRA 非常实用。
WAN 2.7 的 LoRA:该模型的 LoRA 数据经过了进一步训练和优化。基本原理与 Blink LoRA WAN 2.2 相同。几乎所有该版本的 LoRA 模型都表现出这一效果,这使得生成结果更加稳定。
Wan 2.2 和 Wan 2.7 中的 LoRA 有什么区别?
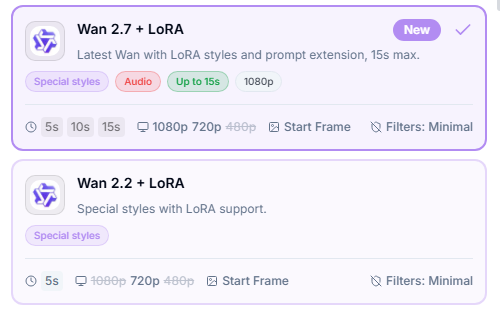
Wan 2.2 和 Wan 2.7 是模型的不同版本,它们对应的 LoRA 模型也各不相同:为某一版本设计的 LoRA 模型无法用于另一版本。
以下是两个版本在实际使用中的差异:
Wan 2.2 + LoRA:较旧的模型 / 支持最长 8 秒的视频生成 / 更大的动态范围 / 瑕疵更少 / 支持多种 LoRA 类型
Wan 2.7 + LoRA:较新的模型 / 支持最长 15 秒的视频生成 / 可以生成带声音的视频 / 但画面中有时可能出现瑕疵,且生成的视频动态感不如 Wan 2.2
应该选择哪一个?
如果更长的时长和音质对你更重要,请选择 Wan 2.7。
如果稳定的 LoRA 表现和更生动、更有动感的画面更重要,请选择 Wan 2.2。
如何运行 LoRA:分步操作
选择一个模型:Wan 2.2 或 Wan 2.7
选择你想要的 LoRA:从可用选项列表中,根据角色、任务或你想实现的效果进行选择。
根据你选择的 LoRA 添加一张照片。
使用 Wan 2.7 + LoRA 时,设置所需的视频时长和分辨率。
开始生成:所选 LoRA 的提示词已内置;无需额外配置。
等待结果,如果对结果不满意,可以尝试其他 LoRA 或其他模型。
最佳实践
使用 Standard LoRA WAN 2.2 时,准备一张与预览图相似的图片。这有助于获得更稳定的结果。
如果需要较长视频(最长 15 秒)或带声音的视频,请使用 Wan 2.7,但要注意其动态效果会略受限制。
不要将某个 LoRA 的提示词用于其他模型。LoRA 的提示词专为该模型设计。
如果结果显得不稳定或含有瑕疵,可尝试缩短视频时长或切换到其他版本的模型。
为 Paired LoRA 拍摄两张照片时,请在相似条件下进行:相同的角度(例如都为正面照)、相似的光线,以及每个角色清晰无遮挡的面部。这能显著降低角色"混淆"或出现畸变的风险。
故障排查
使用 Standard LoRA(Wan 2.2)时结果与预期差异较大:检查你的照片与 LoRA 预览图的相似程度;差异越大,出现瑕疵和不可预测结果的风险就越高。尽量寻找在角度、光线和构图上与预览图最接近的照片。
使用 Blink LoRA 时角色变得难以辨认:请确保使用清晰、高质量的照片;虽然与预览图的相似度在此并非关键因素,但原始照片的质量仍会影响结果。如果图像仍然难以辨认,可尝试更换源照片。
视频卡顿且有异常:在 Wan 2.2 中,请确认你清楚自己选择了哪个 LoRA 版本,并选择了正确的照片。在 Wan 2.7 中,可尝试缩短视频时长。
视频中出现明显瑕疵:这种情况在 Wan 2.7 中更常见;可尝试重新生成,或如果稳定性和动态效果比时长和声音更重要,可切换到 Wan 2.2。
视频显得过于静止,缺乏动感:这是 Wan 2.7 的特性;若需要更生动、更有动感的画面,可尝试 Wan 2.2。
LoRA 未产生预期效果:请确认你没有用自己的提示词替换内置提示词。
角色之间的互动显得不自然:这是该特定 LoRA 的局限性;如果不满意,可从列表中尝试其他 Paired LoRA。同时确认两张照片的分辨率足够高。
其中一个角色不再与上传的照片相似:检查两张照片的质量和清晰度;确保每个角色的面部清晰可见且未被遮挡。
常见问题
什么是 LoRA?
什么是 LoRA?
一种预构建的模型扩展,可将生成结果定制为特定角色、风格或场景。
我需要自己为 LoRA 编写提示词吗?
我需要自己为 LoRA 编写提示词吗?
不需要,每个 LoRA 都已内置提示词,你无需再做其他操作。
为某个 LoRA 设计的提示词可以用于另一个 LoRA 或其他工具吗?
为某个 LoRA 设计的提示词可以用于另一个 LoRA 或其他工具吗?
不可以,该提示词是专门为特定的 LoRA 和模型量身定制的,在其他地方可能无法使用,或产生意外结果。
Standard LoRA 与 Blink LoRA 有什么区别?
Standard LoRA 与 Blink LoRA 有什么区别?
Standard LoRA 要求你的照片与预览图相似,否则可能出现瑕疵。Blink LoRA 会在视频中创建明显的场景转换,且不要求照片与预览图相似。
什么是 Paired LoRA?
什么是 Paired LoRA?
这是一种用于 Wan 2.2 的 LoRA 类型,同时使用两张照片(每个角色一张),捕捉他们互动的场景。
使用 Paired LoRA 需要上传多少张照片?
使用 Paired LoRA 需要上传多少张照片?
两张,每个角色一张。
我可以在 Wan 2.7 中使用 Wan 2.2 的 LoRA 吗?
我可以在 Wan 2.7 中使用 Wan 2.2 的 LoRA 吗?
不可以,LoRA 与特定模型版本绑定,无法在版本之间转移。
使用 LoRA 时的最长视频时长是多少?
使用 LoRA 时的最长视频时长是多少?
Wan 2.2 最长 8 秒,Wan 2.7 最长 15 秒。
是否可以获得带声音的视频?
是否可以获得带声音的视频?
可以,但仅限于 Wan 2.7,Wan 2.2 不生成声音。
为什么 Wan 2.7 的视频动态感较弱?
为什么 Wan 2.7 的视频动态感较弱?
这是该模型的特性:为了实现更长的时长和声音,它相较于 Wan 2.2 牺牲了部分动态范围。
应该选择哪个模型:Wan 2.2 还是 Wan 2.7?
应该选择哪个模型:Wan 2.2 还是 Wan 2.7?
Wan 2.7:如果更长的时长和音质很重要。Wan 2.2:如果 LoRA 的稳定性和动态画面更重要。
为什么视频中会出现瑕疵?
为什么视频中会出现瑕疵?
最常见的原因是使用了 Wan 2.7 模型,或照片与 LoRA 预览图差异较大(针对 Standard LoRA)。
如果结果与预期完全不符,该怎么办?
如果结果与预期完全不符,该怎么办?
检查内置提示词是否被更改、照片是否适合所选的 LoRA 类型,以及 LoRA 是否与你使用的模型版本匹配。
为什么角色会变得难以辨认?
为什么角色会变得难以辨认?
通常是由于原始照片质量较差,请使用清晰、光线良好、面部无遮挡的图片。
是否可以在一次生成中同时使用多种类型的 LoRA?
是否可以在一次生成中同时使用多种类型的 LoRA?
不可以,每次生成只能为特定任务(角色、风格或场景)选择一个 LoRA。
这有帮助吗?
仍需要帮助? 咨询团队