掌握 Seedance 2.0
最后更新 大约 7 小时前
Seedance 2.0 是什么
Seedance 2.0 是字节跳动的视频生成模型,现已在 ZenCreator 的Text to Video、Image to Video和Video to Video中上线。它基于统一架构,将视频和音频作为一个整体流程一起生成,而不是把声音当作最后附加上去的东西。
大多数视频模型只为单张图片添加动画,而 Seedance 2.0 会将整个场景作为一个整体来解读(谁在画面中、发生了什么、地点在哪、镜头应如何运动、以及采用什么风格),并在此理解的基础上构建出连贯的片段。
它的独特之处
理解整个场景,而不只是一张图片。 主体、动作、环境和镜头共同构成一个连贯的片段,动作明显比早期模型更稳定。
支持两种生成模式。 使用带有 First/Last Frame 上传的标准模式来控制开头和结尾,或切换到 Reference Mode,将最多 9 张图片和 3 段音频组合作为风格、身份和动作的输入,每一项都可以在提示词中直接以名称引用。
同时生成音频和视频。 声音与动作自然同步,无需单独的对口型或音频步骤。
精确编辑现有素材。 在 Video to Video 中,你可以更换服装、背景或光线,同时保持原始动作和时间轴不变。
四种输入:各自负责什么
这是使用 Seedance 2.0 时最实用的思维模型。每种输入类型都有各自的职责,不要让一种输入去做另一种输入的工作。
文本 控制空间维度:外观、氛围、风格、环境。
图片 控制身份:角色、物体或场景的具体样貌。
视频 控制时间维度:时序、节奏、镜头运动。实际使用中,这种输入用于 Video to Video,你正在编辑的片段本身就是视频参考。
音频 控制节奏和声音:节拍,以及动作如何与声音同步。
经验法则:文本和图片决定事物的样子,视频和音频决定它们如何运动和发声。 用一堆副词描述复杂的动作("快速地、平滑地、突然地")很少能像直接附上视频参考、让模型复制其动态那样有效。
五种生成方式
Text to Video:仅凭提示词,无需素材来源。灵活性最高。
First Frame:一张图片成为视频字面意义上的起始帧。
First + Last Frame:两张图片确定起点和终点,模型会构建两者之间的过渡。
Reference Mode:多张图片和音频片段被用作风格、身份或动作参考(而非字面意义上的第一帧)。具体能附加什么取决于所用工具,请参见下方的界面导览,了解 Image to Video 中具体可用的内容。
Video to Video:编辑现有片段,修改你指定的部分,同时保留其余一切不变。
一个常见误解: 在 Reference Mode 中上传一张图片并不会使其成为第一帧。模型会将其视为风格/身份参考,并根据提示词文本构建实际的开场画面。如果你希望照片真正作为片段的开头,请改用 First Frame 模式。
提示词公式
每一个强有力的 Seedance 2.0 提示词都遵循相同的结构。你不需要每次都用上所有模块,但Subject 和 Action 是基础,没有它们,场景就会失焦。
Subject:画面中是谁或是什么
Action:一个动词,现在时态,一个清晰的动作
Environment:地点、背景、氛围
Camera:镜头尺寸、运动、角度
Lighting:光源和光质
Style:视觉语言:电影感、编辑风格等
Constraints:稳定性和质量要求
模型对前 20–30 个词的权重最高,因此要把 Subject 和 Action 放在开头。
始终有效的四条规则:
每个镜头一个动作:"走路、转身、微笑"是三个动作,结果会模糊不清
使用现在时动词:"rolls"、"turns"、"falls",而不是"will roll"
具体胜过一堆形容词的堆砌
描述画面中应该有什么,而不是不应该有什么(排除项留给 Constraints)
组合参考素材:标签语法
当你上传多张图片或多段音频时,请直接在提示词中为它们打上标签,以便模型知道你指的是哪一个。具体的标签格式因工具而异,请始终查看提示词框中的占位文本,它会显示该工具的实时语法。
在Image to Video中,参考素材的标签方式如下:
图片: [img1]、[img2]...(最多 9 张,按上传顺序编号)
音频: [audio1]、[audio2]、[audio3](最多 3 段)
示例:"[img1] 中的女性走向镜子。她的姿势参考 [img2]。" 其中 [img1] 定义了她是谁,[img2] 定义了她的姿势。文本将两者融合成一个场景。
界面导览:Image to Video 中的 Seedance 2.0 Spicy
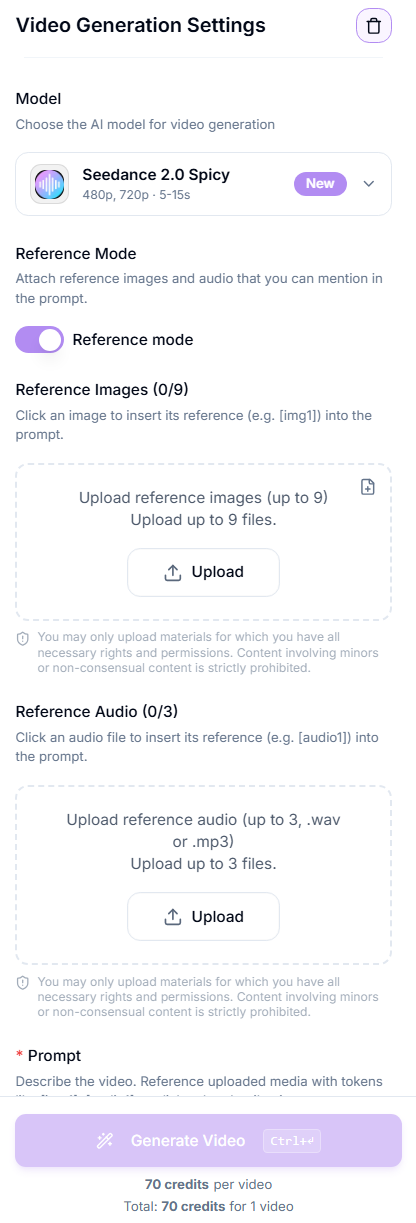
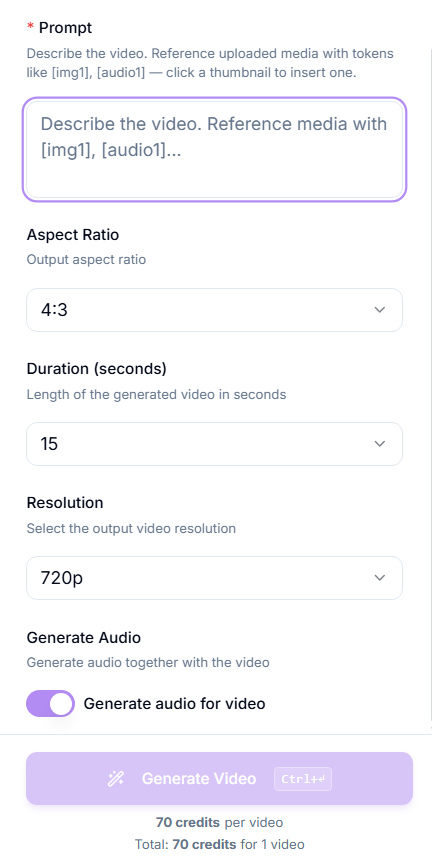
以下是在 Image to Video 中使用 Seedance 2.0 Spicy 生成的实际操作过程,按界面上设置出现的顺序逐步说明。
Model。 已选择 Seedance 2.0 Spicy,即该工具中经过 NSFW 训练的 Seedance 2.0 版本(480p/720p,5–15 秒)。
Reference Mode 开关。 开启此选项以附加可在提示词中提及的参考图片和音频。保持关闭则将单张图片用作字面意义上的第一帧。
Reference Images(0/9)。 最多上传 9 张图片。点击任意已上传的缩略图,即可自动将其标签(例如 [img1])插入提示词。
Reference Audio(0/3)。 最多上传 3 个音频文件(.wav 或 .mp3)。点击某个文件即可将其标签(例如 [audio1])插入提示词。
Prompt。 使用上述七模块公式描述视频。用你插入的标记引用已上传的素材,例如"[img1] turns toward the camera, [audio1] plays as she speaks."
Aspect Ratio。 设置输出的宽高比(例如 4:3)。
Duration(seconds)。 可选择 5、6、8、10、12 或 15 秒。
Resolution。 480p 或 720p。
Generate Audio。 开启此选项可在生成视频的同时生成音频。开启后费用大约会翻倍,确认前请查看 Generate 按钮上方显示的价格。
Generate Video。 查看按钮上方显示的 credits 费用,然后生成。先检查开场画面。如果构图或姿势不对,请再次确认 Reference Mode 是否真的按你的预期工作,而不是字面意义上的第一帧。
常见问题及解决方法
结果看起来很普通或缺乏面部特征 → 主体/动作描述较弱,或形容词堆砌过多。请在开头几个词中重写为具体的主体和一个清晰的动作。
皮肤或表面看起来像塑料或"3D" → 添加 "no 3D, no cartoon, no VFX" 和 "film grain, natural imperfections"。
角色在多次生成之间发生变化 → 重复使用同一张参考图片,用 [img1](或该工具中对应的标签)标记它,并添加 "maintaining consistent [subject]"。
720p 下细节不够精细 → 细节要求未被明确提出。添加 "ultra-sharp detail" 或 "crisp texture"。
镜头或动作感觉不稳定 → 添加 "stable [subject], smooth motion"。
提示词的部分内容似乎被忽略 → 提示词过长、自相矛盾,或将多镜头序列硬塞进一个段落中。请将其拆分为独立、编号的镜头。
生成前快速检查清单:
主体和动作是否出现在前 20–30 个词中?
每个镜头是否只有一个动作、使用现在时动词?
镜头是否明确说明(尺寸+运动+角度)?
参考素材是否为所用工具正确打上标签(例如 Image to Video 中的 [img1] / [audio1])?
是否包含了确保真实感的稳定性约束(no 3D/cartoon/VFX)?
这有帮助吗?
仍需要帮助? 咨询团队