Video to Video
使用我们的 AI Video to Video Generator,将静态照片转化为动态影像,或替换视频中的人物。 上传一张照片和一段视频,创造出视觉一致性极高的动感电影级效果。
最后更新 大约 5 小时前
该工具的功能
Video to Video 有两种运作方式:使用参考视频中的动作为静态照片添加动画,或将现有视频中的人物替换为其他人,同时保持原始场景、镜头运用和动作不变。例如,用他人的舞蹈动作让一张肖像"活起来",或用你自己的照片替换视频中的主持人。完全支持 NSFW。
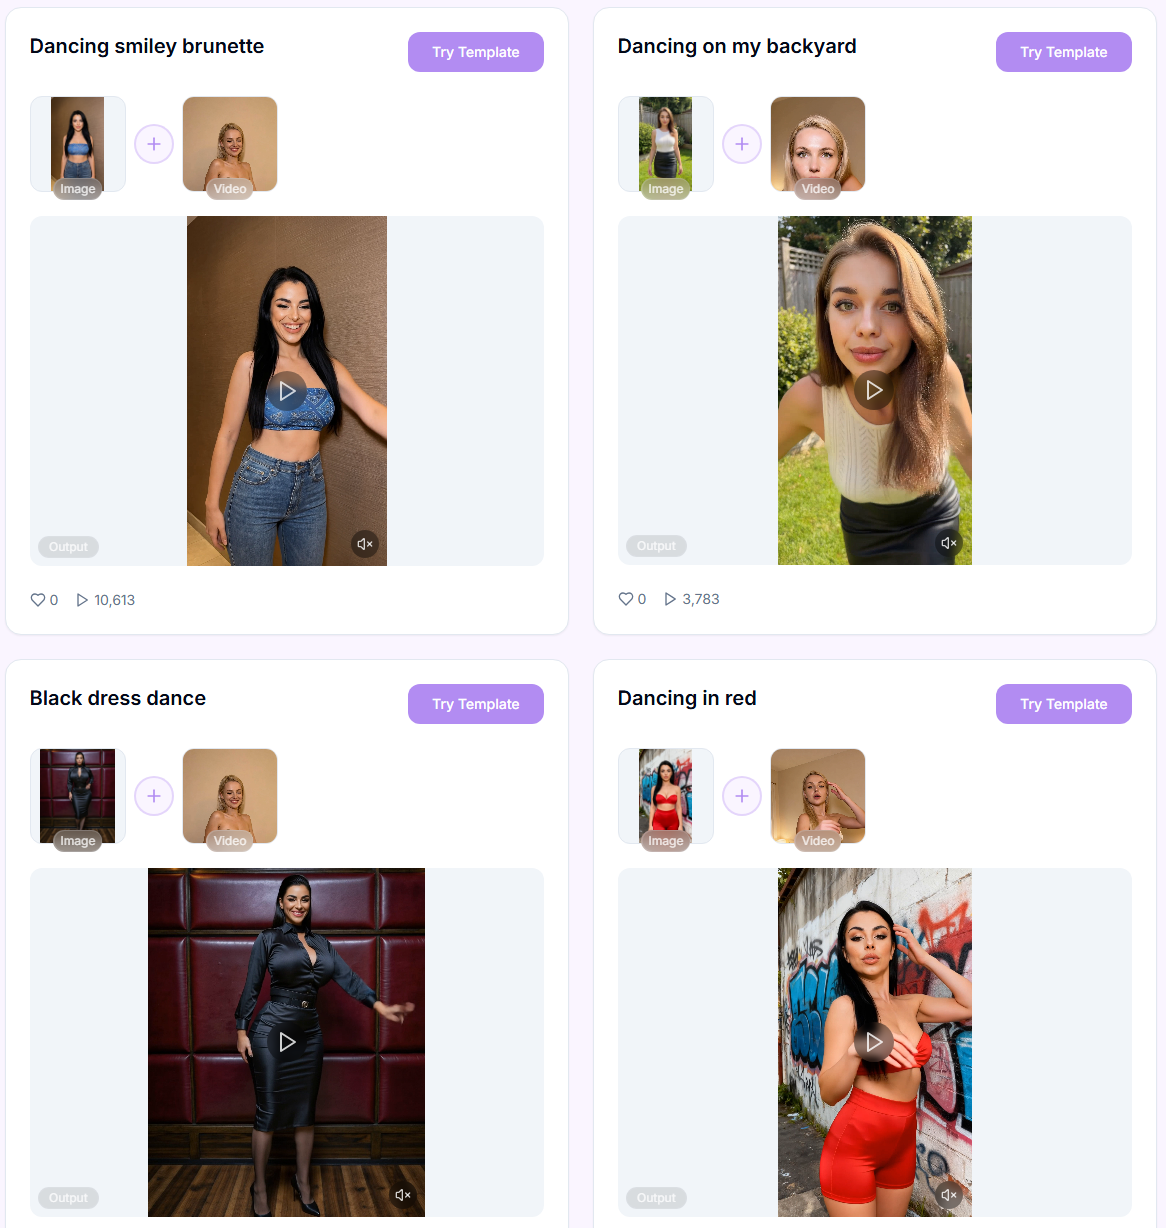
🎬 效果展示
看看 Video to Video 能用一张照片和一段参考视频生成怎样的效果。
不想自己设置一切?
跳过设置,从 Templates 模板库中选择一个现成风格,放入你的照片和视频。模板还能让你了解该模型最擅长处理哪些类型的动作和场景。
分步操作指南
第 1 步:Model,从下拉列表中选择驱动转换的模型。点击下方任意模型即可查看其擅长领域。
Wan 3.0 Spicy
Wan 3.0 Spicy
时长: 5、10、15、20、25,或30秒
分辨率: 480p / 720p / 1080p
最适合: 使用参考视频(最多3个)、参考图片(最多9张),和参考音频进行提示词驱动的 video-to-video 生成,创建最长30秒的多镜头长编辑或转换,可选由模型编写的原生音频。基于大规模标注 NSFW 内容数据集训练。
优势: 可通过 Generate Audio 开关自行编写配乐;支持划分为带时间戳镜头的长剧本式提示词;参考标记([img1]、[vid1]、[audio1])可让你精确指定使用哪个上传素材;比早期 Wan 模型具有更强的多主体一致性和镜头控制力。
权衡: 最佳效果需要与时长匹配的提示词:短提示词配长时长会把情节和镜头选择交给模型决定。没有负面提示词;不需要的元素必须明确描述。
内容说明: 过滤器:最低
Wan 3.0 Prime Spicy
Wan 3.0 Prime Spicy
时长: 5、10、15、20、25,或30秒
分辨率: 480p / 720p / 1080p
最适合: 与 Wan 3.0 Spicy 相同的提示词驱动 video-to-video 生成(参考视频最多3个、参考图片最多9张,以及参考音频),但返回速度约快 40%。
优势: 与 Wan 3.0 Spicy 完全相同的输出质量和功能组合(Generate Audio 开关、剧本式提示词、参考标记、多主体一致性);区别在于等待时间,这在测试想法或微调镜头时很重要。
权衡: 对于相同结果,每秒成本高于 Wan 3.0 Spicy;对提示词长度的敏感度相同,同样没有负面提示词。
内容说明: 过滤器:最低
Seedance 2.0 Uncensored
Seedance 2.0 Uncensored
时长: 5–15秒
分辨率: 720p / 480p
最适合: 基于提示词的视频生成,支持首尾帧和多模态参考(图片、视频、音频):在保留主体动作、时序和身份的同时,编辑已完成的视频,替换服装、背景、光线或场景。基于大规模标注的 NSFW 内容数据集训练。
优势: 在提示词中清晰区分"保留什么"和"改变什么",可获得可预测的结果,而无需"重建"整个场景。当提示词表述精确时,能很好地保留原始动画和身体比例。能准确处理 [video 1]/[audio 1]/[image 1] 等参考,并在未提供参考时可自动生成音频。
权衡: 描述元素的顺序至关重要:如果先描述改动而非需要保留的内容,模型可能会丢失原始动作和时序。原始视频参考 [Video 1] 必须清晰,才能获得可靠结果。3 个视频参考的最大长度为 15 秒。速度比 Seedance 2.0 Fast Spicy 慢。
内容说明: 过滤级别:最低
Seedance 2.0 Fast Spicy
Seedance 2.0 Fast Spicy
时长: 5–15秒
分辨率: 720p / 480p
最适合: 采用与 Seedance 2.0 Uncensored 相同的首尾帧和多模态参考方式,实现更快、更便宜的视频生成,质量良好,可在保留动作、时序和面部身份的同时编辑预录制视频(服装、背景、光线)。此外还基于大规模标注的 NSFW 内容数据集进行了额外训练。
优势: 处理时间快;在提示词中清晰区分"保留什么"和"改变什么",可获得可预测的结果,而无需"重建"场景。比 Seedance 2.0 Uncensored 更快、更便宜。
权衡: 描述改动的顺序至关重要:如果先描述改动而非需要保留的内容,模型可能会丢失原始动作和时序。原始视频参考 [Video 1] 必须清晰。3 个视频参考的最大长度为 15 秒。质量低于 Seedance 2.0 Uncensored。
内容说明: 过滤级别:最低
Seedance 2.5 Uncensored
Seedance 2.5 Uncensored
时长: 5、10、15、20 或 30 秒
分辨率: 480p / 720p / 1080p
最适合: 提示词驱动的 video-to-video 生成,可使用最多10个参考视频、30张参考图片和10个参考音频片段(在提示词中以 [vid1]、[img1]、[audio1] 引用),生成最长30秒的多镜头长结果。基于大规模标注的 NSFW 内容数据集训练。
优势: 画面更自然、更少“AI感”:镜头转场、主体稳定性、光照以及皮肤和眼睛细节均有提升;带时间戳的提示词(“0–5s: …, 6–10s: …”)可控制何时发生什么;可通过 Generate Audio 开关生成可选原生音频。
权衡: 最贵的 Seedance 模型:1080p 的价格约为 720p 的 3.4 倍,且参考视频的秒数会与结果一起计费,建议先用 480p/720p 测试。不支持负面提示词。即使开启 Generate Audio,视频也可能没有音频。
内容说明: 过滤级别:最低
Dream Actor M2.0
Dream Actor M2.0
时长: 最长 30 秒
分辨率: 720p / 480p
最适合: 通过精确应用参考视频中的身体动作、手势、面部表情和唇部动作,让静态角色图片"活起来"。非常适合角色表演、舞蹈序列、富有表现力的动画,以及多角色场景,并基于大规模标注的 NSFW 内容数据集进行了额外训练。
优势: 出色的动作保真度和对动作的语义理解、高身份和背景一致性、在非人类和风格化角色上表现出色、表情自然、在复杂动作中输出稳定。是让照片"活起来"最稳定的选择。
权衡: 构图匹配良好、参考视频清晰(光线良好、遮挡最少)、角色图片兼容时效果最佳。
内容说明: 过滤级别:最低
Animate
Animate
时长: 最长 30 秒
分辨率: 720p / 480p
最适合: 通过精确应用参考视频中的身体动作、手势和面部表情,让静态角色图片(肖像、插画或设计)"活起来"。非常适合角色表演、舞蹈序列和富有表现力的动画,并基于大规模标注的 NSFW 内容数据集进行了额外训练。
优势: 动作保真度高、表情自然,身份一致性高,复杂动作的转移无缝流畅。
权衡: 构图匹配良好、参考视频清晰(光线良好、遮挡最少)、角色图片兼容时效果最佳。可能不够稳定(见下方说明)。
内容说明: 过滤级别:最低
Replace
Replace
时长: 最长 30 秒
分辨率: 720p / 480p
最适合: 在保留原始动作、场景、光线和镜头运用的同时,将现有视频中的主要角色替换为你图片中的主体。非常适合镜头中的角色替换、主持人替换,以及无缝集成,并基于大规模标注的 NSFW 内容数据集进行了额外训练。
优势: 保持原始场景元素和动作,身份保持能力强,与环境和光线的融合真实自然。
权衡: 图片与视频之间的姿势/构图匹配良好、参考素材干净时效果最佳。可能不够稳定(见下方说明)。
内容说明: 过滤级别:最低
Kling 2.6 Motion
Kling 2.6 Motion
时长: 最长 30 秒(更长的视频会自动裁剪)
分辨率: 仅限 1080p
最适合: 将参考视频中的编舞和动作应用到角色图片中的主体上。非常适合复杂的舞蹈动作、手势和全身表演。非常适合舞蹈序列、动作转移,以及创建一致的角色动画。
优势: 从参考视频中提取并转移完整的动作/编舞(包括复杂动作、手部、面部表情)。可选择保留原始声音。动作保真度和角色一致性强。
权衡: 需要良好的参考视频质量(动作清晰、无遮挡)以及兼容的角色图片。安全过滤比其他模型更严格。
内容说明: 过滤级别:开启
MiniMax H3 Max
MiniMax H3 Max
时长: 5秒、6秒、8秒、10秒、12秒,或15秒
分辨率: 480p / 720p / 1080p
最适合: 使用文字提示词重新处理现有视频,可选择结合参考图片、额外视频,和音频(最多9张图片、3个视频、3个音频片段,总计12个文件)来引导结果。
优势: 参考标记(Image 1、Video 1、Audio 1)可让你精确指定哪个上传素材驱动编辑的哪个部分;每个结果都自带原生立体声音轨,无需开关;灵活的宽高比(16:9、9:16、4:3、3:4、1:1、21:9,或自适应)。
权衡: 会同时按源视频秒数和输出秒数计费。没有负面提示词;需将排除项写在主提示词末尾。音频无法关闭。长提示词会在内部被压缩,因此更简短精确的文字通常效果更好。
内容说明: 过滤器:开启。仅限 SFW,不支持 NSFW 内容。
快速选择:
需要长时间、提示词驱动的多镜头编辑或转换(最多30秒),结合可选原生音频与视频/图片/音频参考? → Wan 3.0 Spicy。
需要同样的结果但更快,即使每秒成本更高也可以? → Wan 3.0 Prime Spicy。
需要在单次生成中使用最多10个参考视频加30张图片和10个音频片段,最长30秒、最高1080p? → Seedance 2.5 Uncensored。
需要最高质量的编舞/舞蹈转移,SFW? → Kling 2.6 Motion.
想用参考视频让静态照片"活起来",最稳定的选项,包括 NSFW? → Dream Actor M2.0.
相同需求,但不介意稳定性稍低? → Animate.
需要在保留场景的同时替换现有视频中的人物? → Replace.
编辑已完成的视频(服装、背景、光线),同时保留动作和身份? → Seedance 2.0 Uncensored 或 Seedance 2.0 Fast Spicy (更便宜、更快).
需要用文字提示词重新处理现有视频,加上可选的图片/视频/音频参考,SFW? → MiniMax H3 Max。
第 2 步:Upload your Image,选择角色清晰的肖像照或全身照。支持格式:JPG 或 PNG。图片应显示光线良好、无遮挡的面部(无墨镜或浓重阴影)。建议最小尺寸:每边 512px。
第 3 步:Upload your Video,上传视频或粘贴链接(Instagram 或 TikTok)作为动作来源。链接仅适用于部分模型,Seedance、Wan 3.0 和 MiniMax H3 需要上传视频文件。视频决定了动作、手势和表情。时长和帧率取自源视频。最低计费时长为 5 秒。支持格式:MP4、MOV。你还可以开启 Keep original sound 以保留源视频的音频。
第 4 步:Prompt,提示词驱动的模型(Wan 3.0 Spicy、Wan 3.0 Prime Spicy、Seedance 2.0 Uncensored、Seedance 2.0 Fast Spicy、Seedance 2.5 Uncensored、MiniMax H3 Max)需要此项:描述要保留什么、要改变什么,并按顺序使用参考标记([image 1]、[video 1]、[audio 1])指向你上传的素材。动作迁移模型(Dream Actor M2.0、Animate、Replace、Kling 2.6 Motion)不使用提示词,它们直接从你的源视频获取动作。不知道怎么写?点击字段下方的「» AI Prompt Assistant」按钮,将你的想法转换为格式正确的提示词。
第 5 步:Resolution,选择输出视频的分辨率。大多数模型提供 720p 或 480p;Wan 3.0 Spicy、Wan 3.0 Prime Spicy、Seedance 2.5 Uncensored、MiniMax H3 Max 和 Kling 2.6 Motion 还支持 1080p。
第 6 步:Generate,点击 Generate,等待模型处理你的视频。每次生成的费用取决于所选时长和设置。结果会出现在任务列表中,可供预览、下载或发送到其他工具。
获得最佳效果的技巧
匹配构图与姿势:保持上传的图片和视频在镜头位置和身体姿势上一致。不匹配可能导致面部扭曲或画面错位。
保持宽高比一致:如果你的照片和视频宽高比不同,AI 必须进行裁剪或拉伸以适配。比例匹配能带来更准确的面部映射和更流畅的动作。
质量很重要:输入素材的分辨率和清晰度越高,输出效果越好。避免模糊的面部、过曝的光线或过度的运动模糊。
参考模板示例:使用工具内建的模板,了解模型实际能达成的效果。它们反映了模型最擅长处理的动作和场景类型。
使用稳定的视频参考:选择镜头稳定、面部清晰可见且居中的视频。避免复杂场景、快速动作或频繁的镜头切换,以获得更可靠的结果。
故障排查
这是 AI 处理结果,偶尔出现错误、瑕疵或意外结果属于正常现象,无法保证 100% 准确的结果。如果片段效果不理想,可尝试重新生成或调整输入素材。
Animate 和 Replace 可能不够稳定。请仅使用高质量素材,并避免使用过长的视频参考,否则我们无法保证生成正常的结果。
如果结果不符合预期,请通过应用内的客服聊天联系我们,或发送邮件至 [email protected]。
常见问题
如果我的视频不包含清晰可见的面部会怎样?
如果我的视频不包含清晰可见的面部会怎样?
你会收到错误提示,但你的 credits 会自动退还。
我可以上传较长的片段吗?
我可以上传较长的片段吗?
可以,最长支持 30 秒。
为什么视频过程中面部会闪烁或变化?
为什么视频过程中面部会闪烁或变化?
这可能发生在面部并非在所有画面中都清晰可见、视频包含快速动作或剪辑、或光线发生显著变化时。为获得最佳效果,请使用光线一致、面部清晰可见的稳定视频。
为什么我的生成失败了?
为什么我的生成失败了?
你的任务可能因不支持或损坏的文件、质量极低的输入素材、根据所选模型而定的内容限制,或源视频中不稳定的动作而失败。请尝试简化输入素材,并使用更短或更清晰的视频。
Animate 和 Kling 2.6 Motion 有什么区别?
Animate 和 Kling 2.6 Motion 有什么区别?
Animate 跟随视频的动作,速度更快但稳定性较低。Kling 2.6 Motion 提供更高的质量和一致性,但使用更严格的安全过滤。
为什么我的视频被裁剪为 30 秒?
为什么我的视频被裁剪为 30 秒?
Kling 2.6 Motion 支持的最大时长为 30 秒。如果你的视频更长,将会自动裁剪。
我可以使用 Instagram 或 TikTok 的视频吗?
我可以使用 Instagram 或 TikTok 的视频吗?
可以,你可以直接将链接粘贴到工具中。链接仅适用于部分模型,Seedance、Wan 3.0 和 MiniMax H3 需要上传视频文件。请确保视频是公开且可访问的。
如果生成失败,我会被扣费吗?
如果生成失败,我会被扣费吗?
不会。失败任务的 credits 会自动退还到你的余额中。
完整模型课程
想深入了解特定模型的提示词写法吗?每个模型在 ZenCreator 内都有自己的深入课程:
接下来
Video Upscaler:让结果更清晰、放大结果
Video Merger:将片段合并为更长的视频
Image Editor:上传前润色你的源照片
这有帮助吗?
仍需要帮助? 咨询团队