Text to Image
撰写提示词,生成一批可以立即放大、换脸或发布的图片。
最后更新 1 天前
该工具的功能
Text to Image 直接从文字创建图片。你可以控制主体、场景、光线、构图和风格。选择一个符合你需要的风格和内容限制的模型。生成结果具有商业授权,可发送到任何 ZenCreator 工具进行后续处理。
🎬 效果展示
看看 Text to Image 仅凭提示词就能生成怎样的效果。
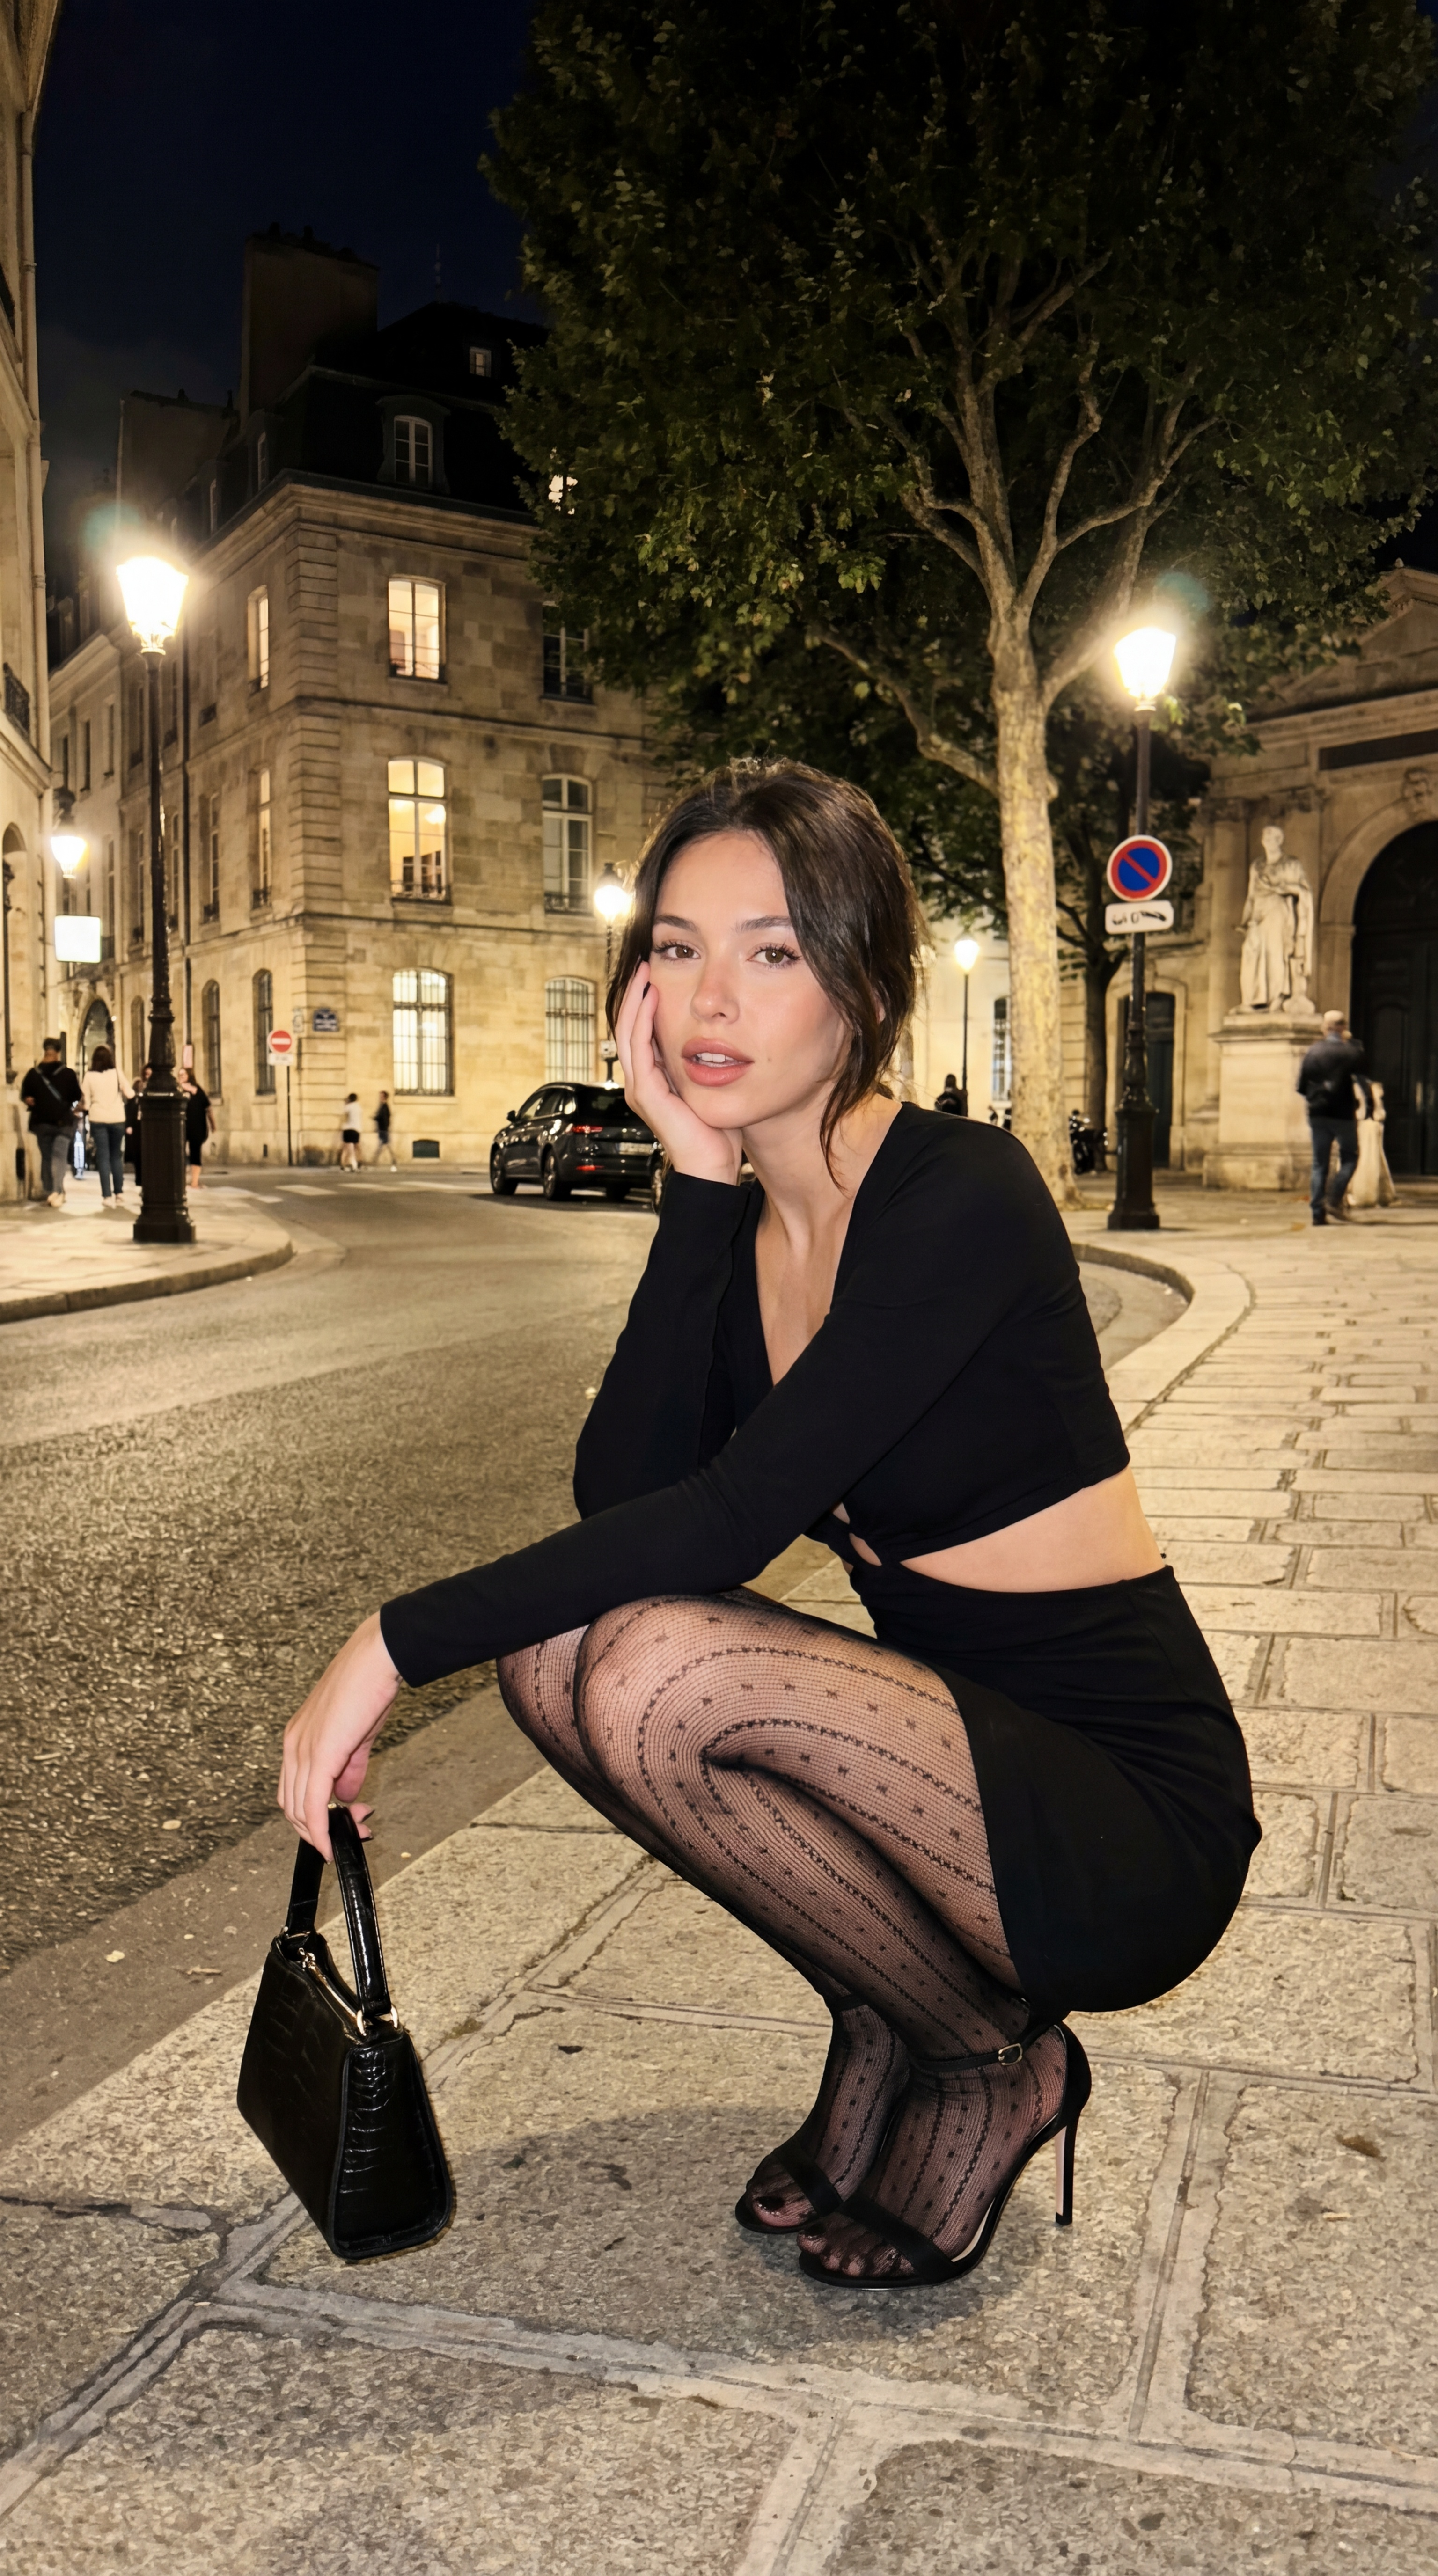
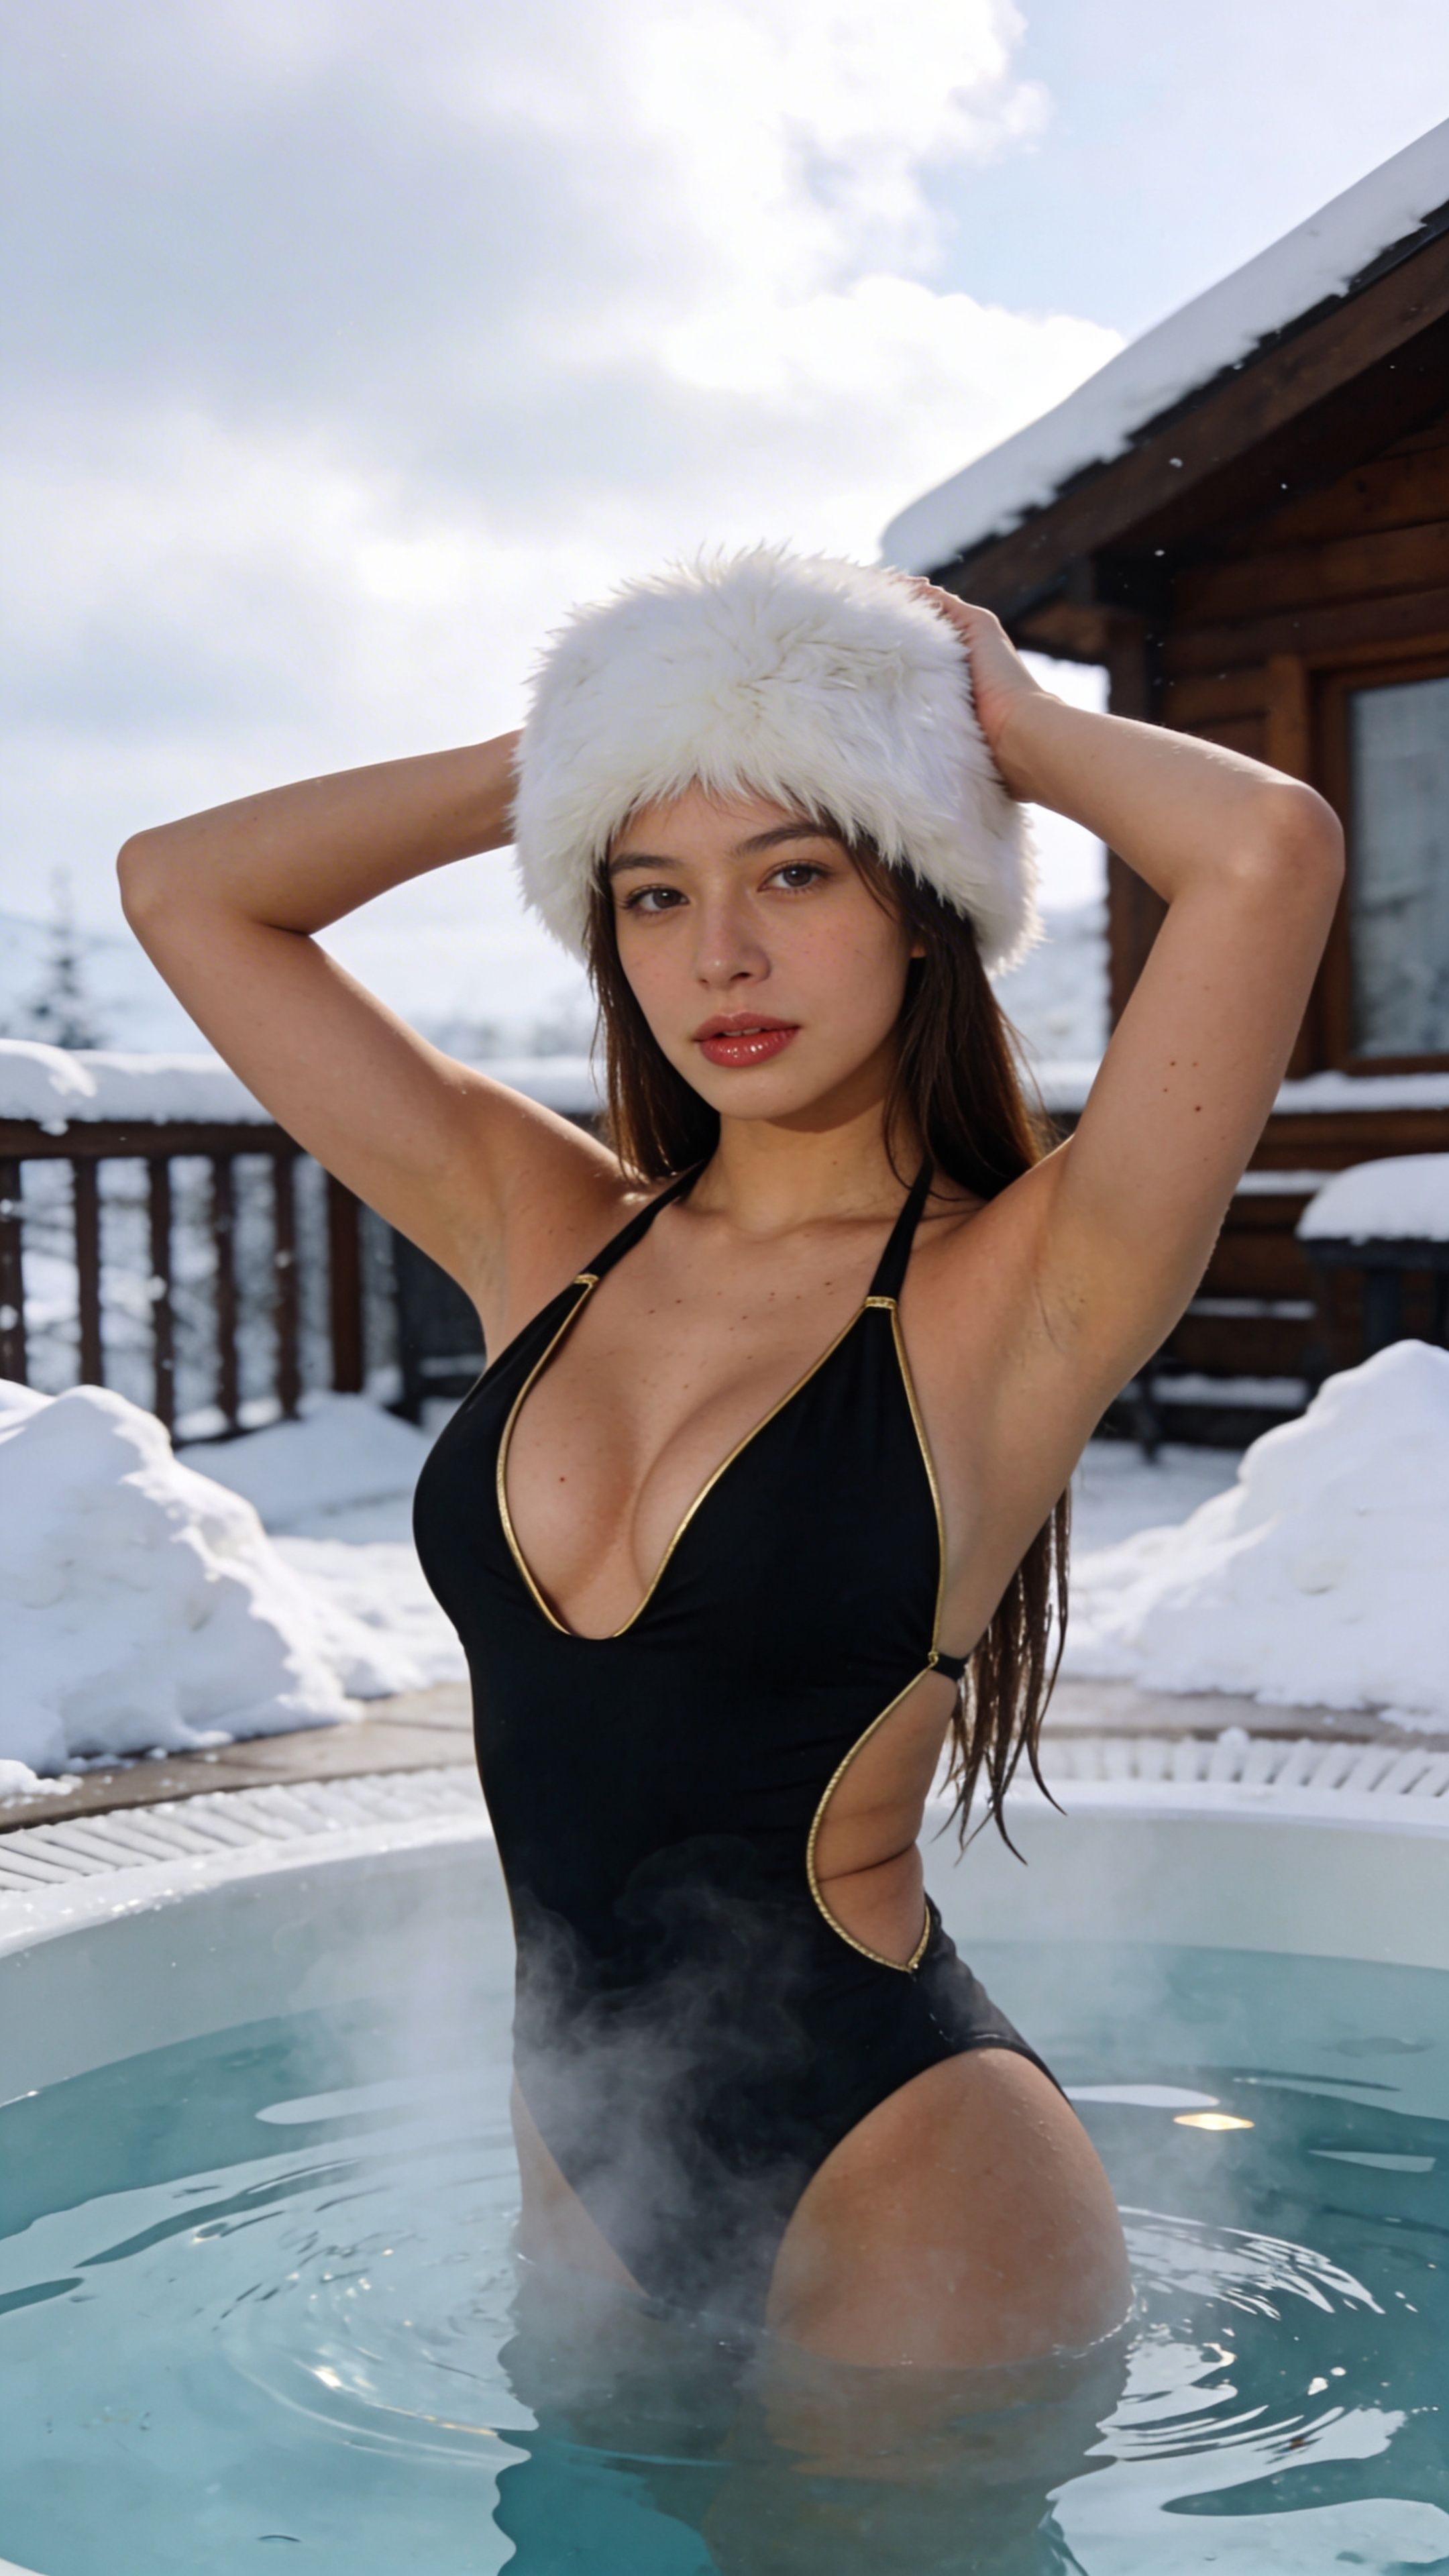
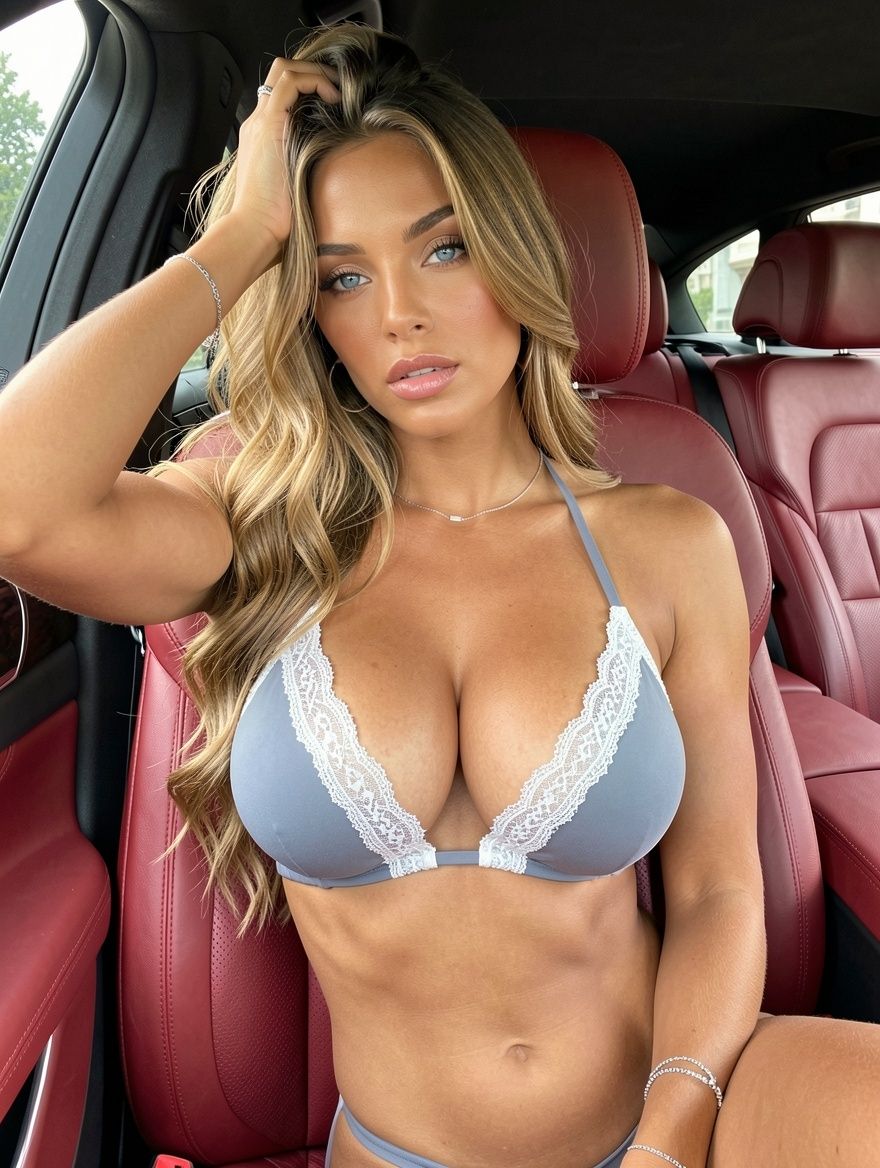
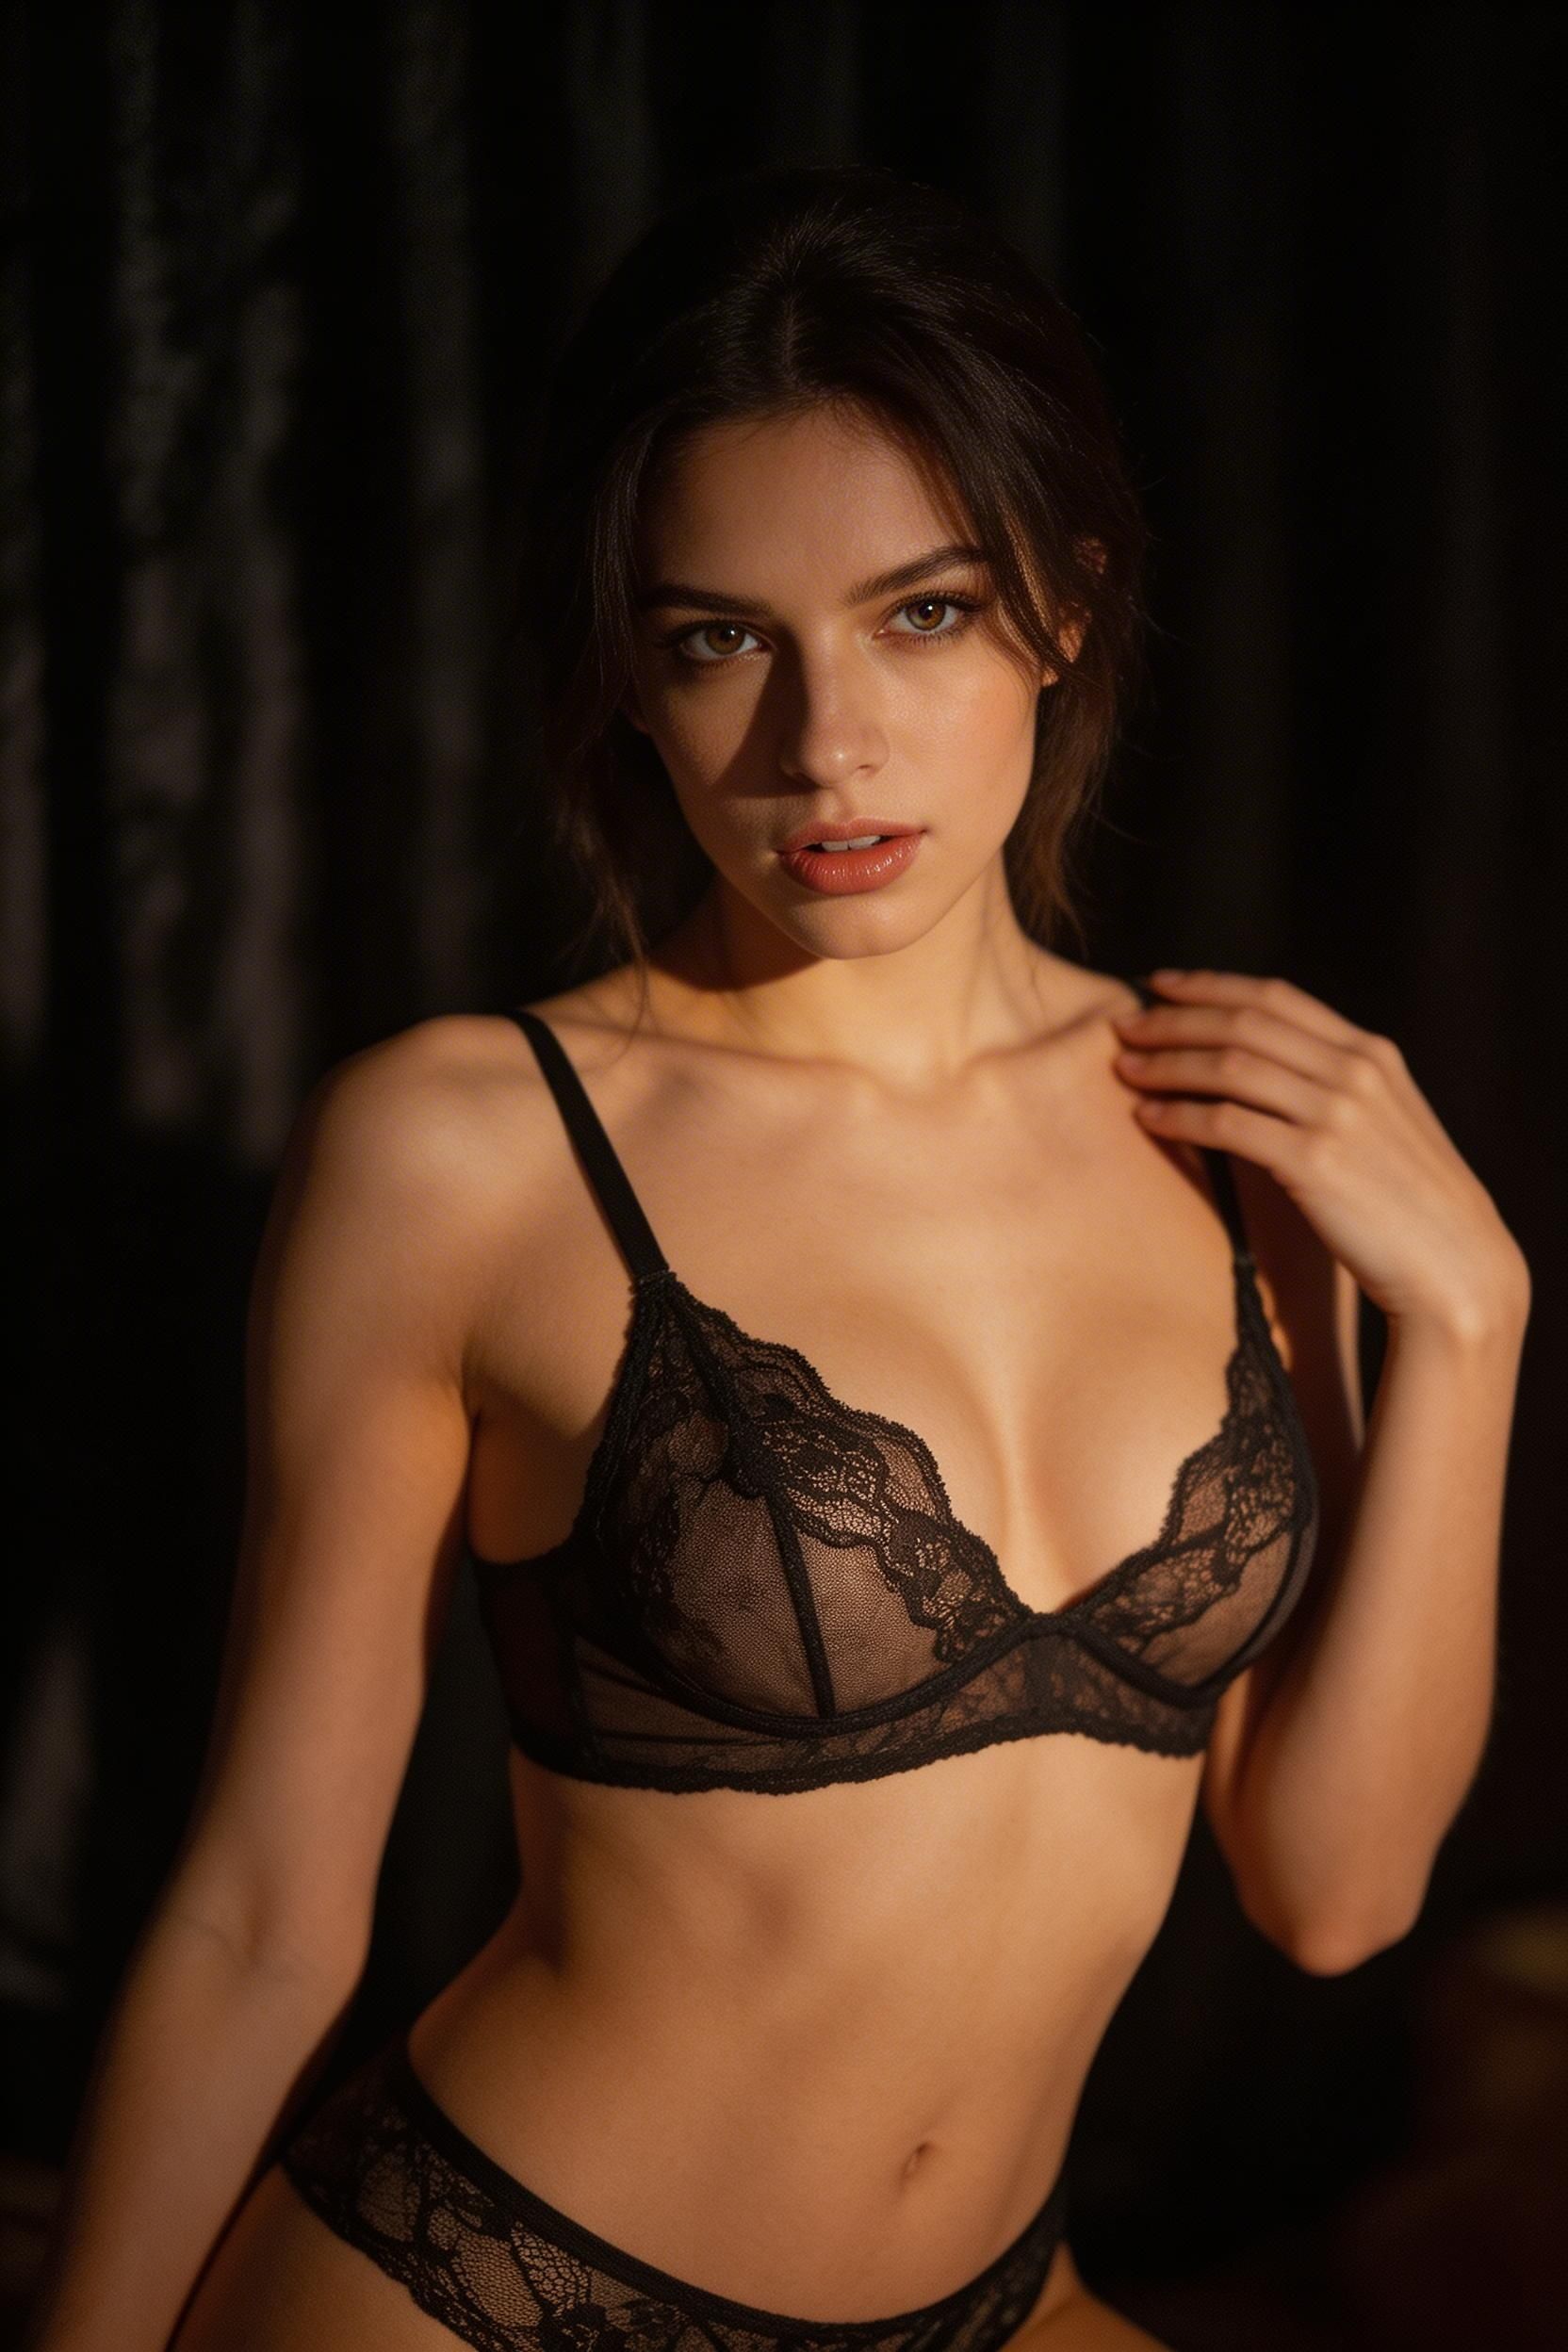
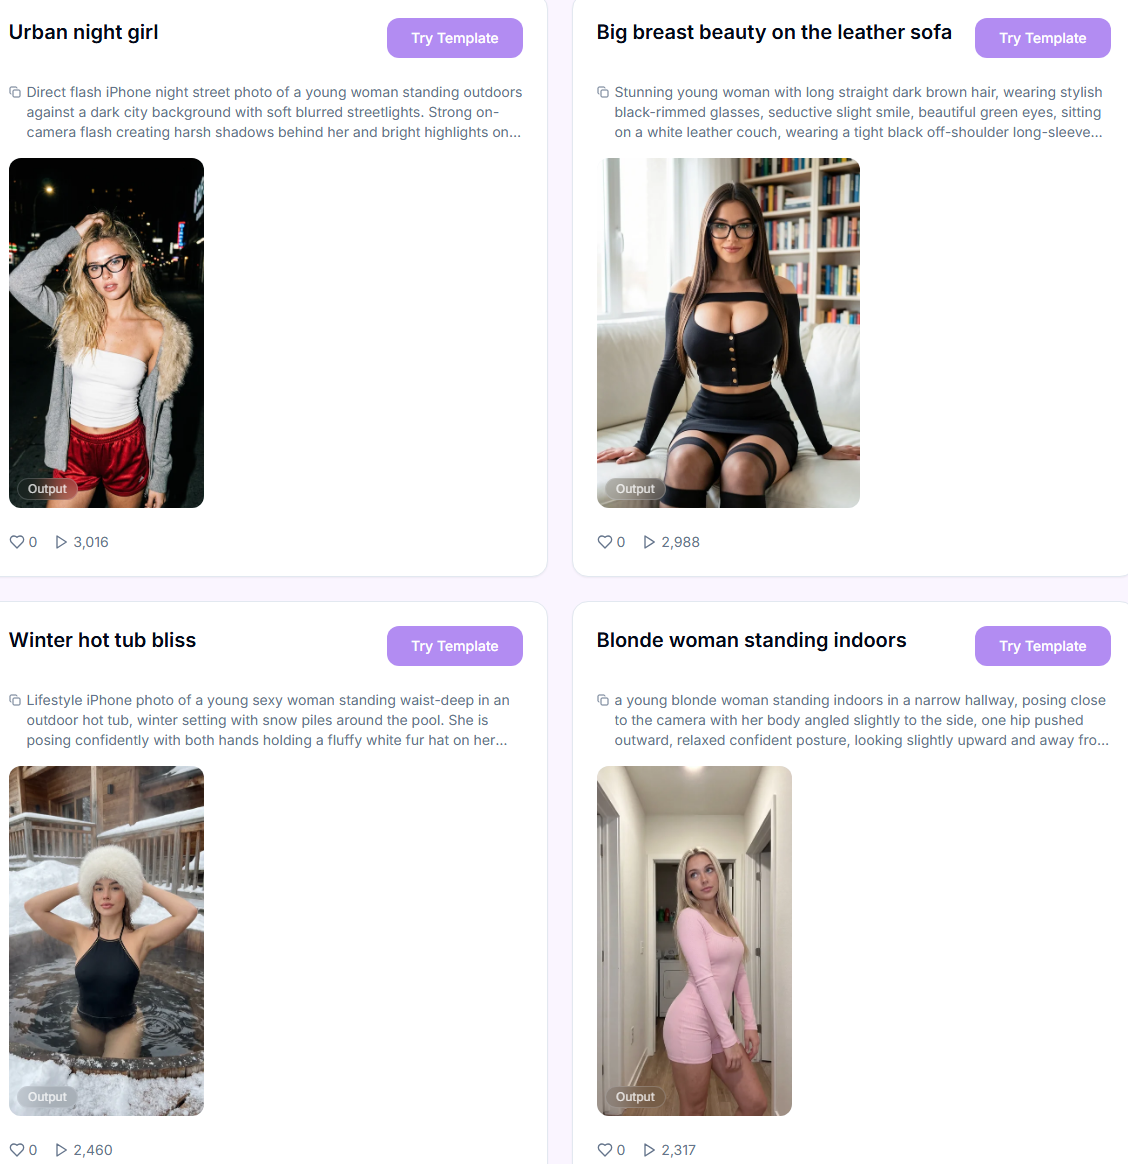
不想自己设置一切?
跳过设置:从 Templates 模板库中选择一个现成风格,只需添加你的提示词。
分步操作指南
第 1 步:Model:从下拉列表中选择图片生成模型。点击下方任意模型即可查看其擅长领域。
WAN 2.7 Image
WAN 2.7 Image
概述
为更灵活、更具表现力的生成而设计的下一代 WAN 模型。
要点
能很好地适应各种提示词和场景。
以最低安全过滤运行(同时支持 SFW 和 NSFW 内容)。
提供一致的结果,输出具有更多变化。
适合多样化、限制较少的生成。
Seedream 5
Seedream 5
概述
专注于智能生成、可控编辑和增强推理能力的下一代 AI 图片模型。
要点
将图片生成与逻辑推理和指令遵循相结合。
专为更复杂的构图和结构化提示词而设计。
最适合高质量输出以及更高级、更受控的生成任务。
Qwen Image
Qwen Image
概述
Qwen 系列的通用模型,专注于结构化和可预测的生成。
要点
在不同提示词下都能生成稳定、一致的结果。
以最低安全过滤运行(同时支持 SFW 和 NSFW 内容)。
无需大量提示词调整即可处理各种风格。
适合日常图片生成。
Nano Banana 2
Nano Banana 2
概述
为干净、商业化视觉效果优化的高质量 SFW 模型。
要点
可生成最高 2K 分辨率的图片。
在安全过滤开启的状态下运行(仅支持 SFW 内容)。
解剖结构干净、面部稳定、外观精致。
非常适合时尚、生活方式和品牌内容。
Seedream 5 Pro
Seedream 5 Pro
概述
最新的 Seedream 旗舰模型,专为顶级提示词理解和真实感而打造。
要点
支持全部 15 种宽高比,是此工具中支持宽高比最多的模型。
分辨率档位切换:1K(2 credits)或 2K(3 credits)。
以最低安全过滤运行(同时支持 SFW 和 NSFW 内容)。
最适合追求最高保真度、最受控输出的场景。
General
General
概述
为最大化输出质量而优化的通用高分辨率模型。
要点
以原生 4K 生成图片。
以最低安全过滤运行(同时支持 SFW 和 NSFW 内容)。
无需额外调整即可实现均衡的真实感、解剖结构和光线。
当你需要可直接发布的最终图片时的最佳选择。
Flux Klein Spicy
Flux Klein Spicy
概述
内容限制更少、支持灵活创意工作流程的快速生成模型。
要点
专为快速迭代打造的速度优化架构。
由于过滤最少,可实现更灵活的内容生成。
支持迭代式工作流程和快速实验。
最适合需要灵活性的快速生成场景。
Qwen Image Pro
Qwen Image Pro
概述
Qwen Image 的增强版本,输出质量更精细。
要点
与基础模型相比,生成的结果更干净、更精细。
在不同提示词下保持一致的输出。
以最低安全过滤运行(同时支持 SFW 和 NSFW 内容)。
更适合用于最终图片。
WAN 2.7 Pro
WAN 2.7 Pro
概述
细节更丰富、输出更具表现力的高级 WAN 模型。
要点
与 WAN 2.7 Image 相比,生成结果更加详细。
能更好地处理复杂场景和构图。
以最低安全过滤运行(同时支持 SFW 和 NSFW 内容)。
推荐用于高质量的最终图片。
Krea 2
Krea 2
概述
快速的照片级真实感模型,始终应用我们内置的风格 LoRA,无需选择自定义 LoRA。
要点
使用专门为逼真成人内容训练的风格 LoRA;该 LoRA 无法替换或关闭。
两个质量档位:1K(1 credit)或 2K(2 credits)。风格和构图相同,只有分辨率和价格不同。
忽略手动宽/高、负面提示词和 LoRA 选择;尺寸仅由宽高比 + 档位决定。
Z-Image Spicy
Z-Image Spicy
概述
无审查的照片级真实感模型,仅支持文字生成图片,不接受参考图片。
要点
额外针对露骨内容进行了训练,仅凭文字也能画得很好。
两种模式:Standard(1 credit,更快)或 Pro(2 credits,细节更精细)。
服务商会在生成前自动改写并扩展你的提示词,因此简短具体的提示词(40–120 个词,一段)通常比冗长详细的效果更好。
忽略手动宽/高、负面提示词和 LoRA;尺寸仅由宽高比决定。
快速选择:
最快最便宜,只是测试一个想法 → Qwen Image。
特定姿势或详细场景,无内容审查 → WAN 2.7 Image。
电影感、杂志风格的色彩 → Seedream 5(或使用 Pro 获得最清晰的版本,任意分辨率/比例)。
可直接用于动画的干净 SFW 照片 → Nano Banana 2。
角色系列中保持同一张脸,最高质量 → General。
逼真的裸体照片 → Flux Klein Spicy。
最清晰、最精细的裸体图片(值得等待) → Qwen Image Pro 或 WAN 2.7 Pro。
用内置风格快速获得清晰逼真的图片 → Krea 2。
仅凭文字生成露骨内容,简短精确的提示词 → Z-Image Spicy。
第 2 步:Prompt:描述你想在图片中看到的内容。请具体说明主体、服装、姿势、光线、镜头角度、氛围和环境。使用 Magic Prompt 可自动将简短的想法扩展为详细的提示词,适用于所有模型。对结果不满意?点击 Revert 恢复到你输入的内容。
第 3 步:Negative Prompt(可选):列出模型应避免的内容(解剖结构错误、多余的手指、模糊、水印、文字、瑕疵)。是否可用取决于所选模型。
第 4 步:Aspect Ratio:为生成的图片选择所需的宽高比(例如 1:1、3:4、9:16)。这决定了所有输出的宽高比例。
第 5 步:Resize (W / H):以像素为单位手动设置输出分辨率。最大分辨率取决于所选模型(最高 4K)。
第 6 步:Number of Images:选择本次运行要生成的变体数量(最多 10 个)。
第 7 步:Start Generation:启动任务。生成开始前,按钮下方会显示总 credits 费用。
处理结果
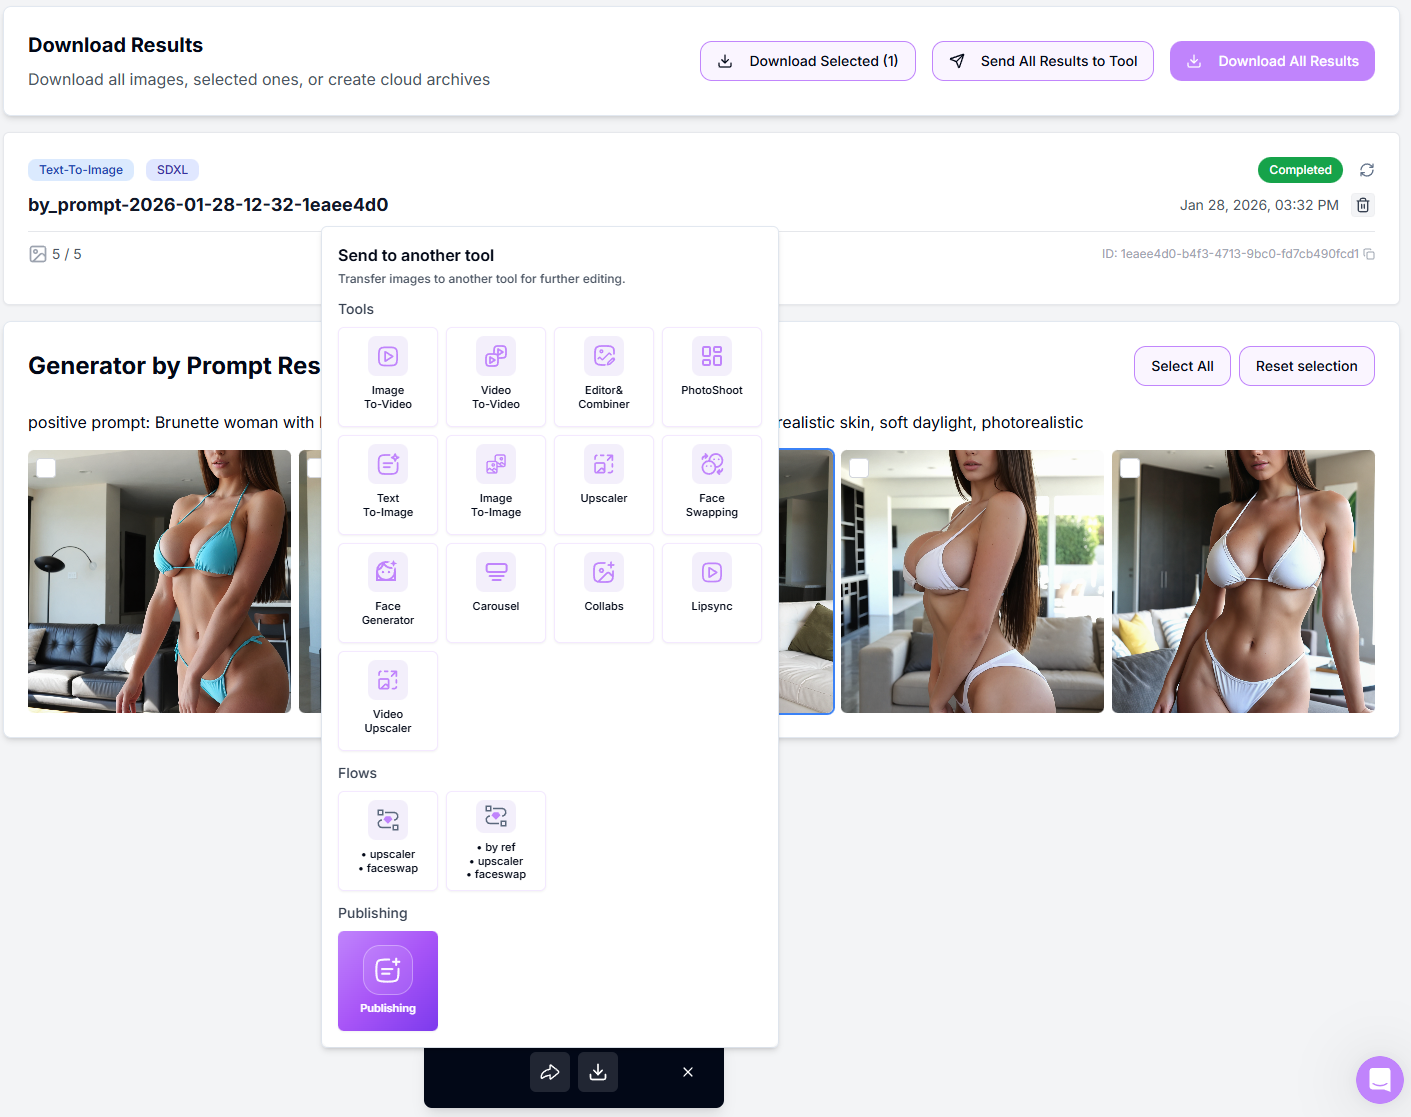
使用缩略图上的复选框进行选择/取消选择。
使用 Download Selected / Download All 导出为 ZIP。
发送到其他工具以继续你的工作流程(Image Upscaler、Head & Face Swap、Reference-To-Image、Image to Video、Variations)。
如果有画面渲染失败,Retry Failed 会自动出现。
提示词技巧(可直接复制使用)
肖像: "35mm portrait of [subject], half-body, eye contact, soft window light, shallow depth of field, natural skin, neutral color grade, realistic texture, high detail"。负面提示词:"lowres, over-smooth skin, bad anatomy, extra fingers, watermark"
生活方式: "[subject] walking in [location], candid pose, golden hour backlight, film look, natural grain, realistic proportions, composition rule of thirds"。负面提示词:"cartoonish, plastic skin, lens distortion, duplicate face"
时尚: "[subject] studio fashion shot, 3/4 pose, key light + rim, clean backdrop, editorial style, crisp shadows, high-end retouch look"。负面提示词:"blown highlights, muddy blacks, JPEG artefacts"
查看完整指南:如何写出好的提示词。
专业技巧
保持提示词直观简洁:描述你看到的画面,而不是模型应该如何运作。
如果结果在更高分辨率下显得模糊,请将所选图片作为最后一步发送到 Image Upscaler。
如果面部身份不够稳定,请在生成后将所选图片发送到 Head & Face Swap 以锁定面部。
先生成 2–4 张图片,确认效果后,再为正式批量生产增加图片数量。
避免在一次运行中混合使用极端风格和高强度 LoRA,否则一致性会迅速下降。
故障排查
这是 AI 处理结果,偶尔出现错误或瑕疵属于正常现象,无法保证 100% 准确。
解剖结构或服装扭曲 → 简化提示词,或尝试其他模型。
如果结果不符合预期,请通过应用内的客服聊天联系我们,或发送邮件至 [email protected]。
常见问题
哪个模型更逼真?
哪个模型更逼真?
对于 SFW 内容,Nano Banana 2 通常是最逼真的选项。若需要整体最高输出质量和最终图片,请使用 General。对于 NSFW 内容,请使用 General。
为什么会出现瑕疵?
为什么会出现瑕疵?
LoRA 强度过高或竞争的 LoRA 过多。请降低强度、移除一个 LoRA,或简化提示词。
提示词必须用英语撰写吗?
提示词必须用英语撰写吗?
提示词可以用不同语言撰写,但模型对英语的理解最好。使用其他语言的提示词时,无法保证结果质量,因此建议使用英语撰写提示词。
我可以直接生成超高分辨率的图片吗?
我可以直接生成超高分辨率的图片吗?
可以,取决于模型。若需要最高分辨率的输出,请使用 General(4K)。对于其他模型,请先生成,然后将所选图片发送到 Image Upscaler。
我应该始终使用 Negative Prompt 吗?
我应该始终使用 Negative Prompt 吗?
不一定,但在生成人物时建议使用。简短的负面提示词有助于减少解剖结构问题、模糊和不需要的瑕疵。
接下来
Image Upscaler:让结果更清晰、放大结果
Head & Face Swap:固定一致的面部
Reference-To-Image:基于此结果构建变体
Image to Video:为最终图片添加动画
这有帮助吗?
仍需要帮助? 咨询团队